Haiku 5.5: Anthropic macht aus Modellfähigkeit ein System der Arbeitsteilung
Der Wert von Claude Haiku 5.5 liegt nicht nur darin, dass es schneller und günstiger antwortet, sondern darin, dass es Modellaufrufe zu einer Infrastruktur macht, die sich in großem Maßstab einsetzen lässt.
Haiku 5.5: Anthropic macht aus Modellfähigkeit ein System der Arbeitsteilung
Der Wert von Claude Haiku 5.5 liegt nicht nur darin, dass es schneller und günstiger antwortet, sondern darin, dass es Modellaufrufe zu einer Infrastruktur macht, die sich in großem Maßstab einsetzen lässt.
Anthropic hat Claude Haiku 5.5 am 7. Oktober 2026 veröffentlicht. Zuerst ein Name, der sich leicht verwechseln lässt: In den öffentlichen offiziellen Unterlagen von Anthropic heißt das Modell Claude Haiku 5.5, die Modell-ID ist claude-haiku-5-5, und es gibt kein offizielles Modell namens „Claude Hiya 5.5“. Dieser Artikel verwendet durchgehend Haiku 5.5.
Anthropic gibt ihm eine klare Stellung: ein kleines Modell für Aufgaben mit hoher Nebenläufigkeit, niedriger Latenz und Kostensensibilität, geeignet für Klassifikation, Informationsextraktion, Zusammenfassung, Kontextkompression, Datenbankabfragen, Browseraktionen und Agent-Teilaufgaben. Offiziell liegen die durchschnittlichen Betriebskosten von Haiku 5.5 etwa 75% unter denen von Haiku 4.5; es ist zugleich das erste Modell der Haiku-Reihe mit einstellbarem effort.
Damit wird aus der Frage zu Haiku 5.5 nicht mehr „ist das nur wieder ein stärkeres kleines Modell?“, sondern eine praktischere Frage: Wenn ein Modell billig genug ist, um in großer Zahl aufgerufen zu werden, was verändert sich an der Arbeitsteilung der Modelle in einem KI-Produkt?
Die Familie Claude 5.5 bildet eine klare Arbeitsteilung
Wer nur auf die Modellnamen sieht, versteht Opus, Sonnet und Haiku leicht als drei Plätze auf derselben Fähigkeitsrangliste. Genauer ist, dass sie eine Arbeitsteilung für unterschiedliche Arbeitslasten bilden.
| Modell | Passendere Rolle | Typische Aufgaben |
|---|---|---|
| Claude Opus 5.5 | Experte für komplexe Probleme und Planer über lange Horizonte | Komplexe Agents, langes Programmieren, schwieriges Schlussfolgern, kritische Entscheidungen |
| Claude Sonnet 5.5 | Hauptmodell der täglichen Arbeit | Codeänderungen, Dokumenterzeugung, Analyse, mehrschrittige Wissensarbeit |
| Claude Haiku 5.5 | Ausführungsschicht mit hoher Aufrufzahl | Klassifikation, Extraktion, Zusammenfassung, Kompression, Routing, Browser- und Subagent-Aufgaben |
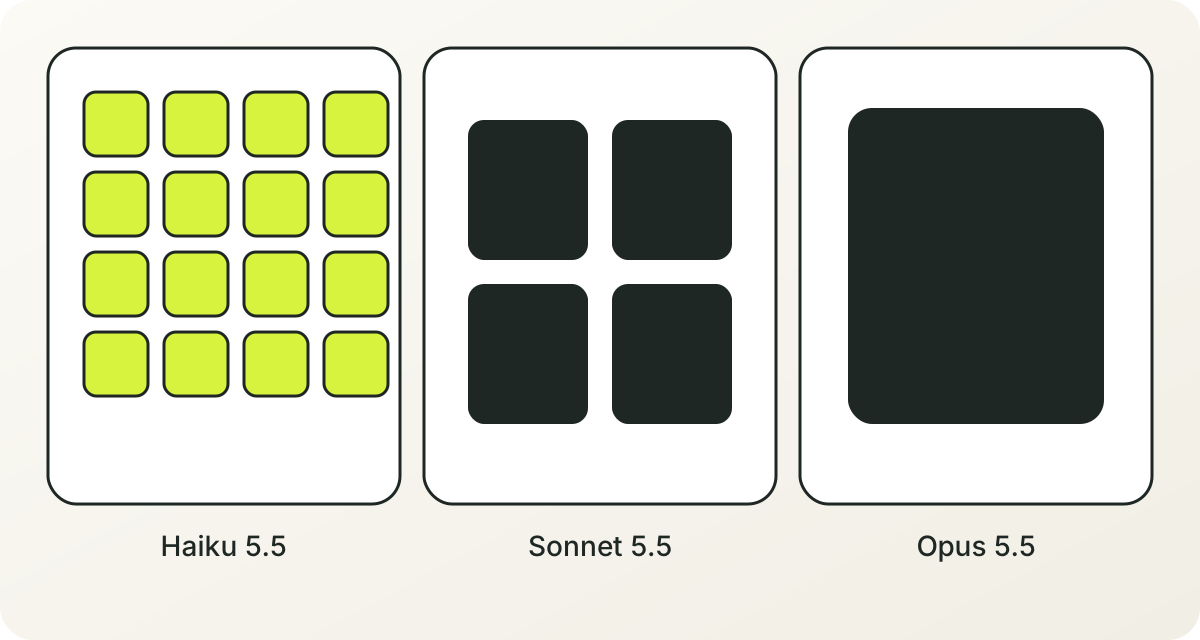
Die Modellübersicht von Anthropic verwendet eine ähnliche Einordnung: Opus 5.5 zielt auf langes Agent-Programmieren und Wissensarbeit, Sonnet 5.5 betont das Gleichgewicht von Geschwindigkeit und Intelligenz, Haiku 5.5 zielt auf Klassifikations-, Extraktions- und Routing-Aufgaben mit hoher Nebenläufigkeit und niedriger Latenz.
Das heißt, die Stärke von Haiku 5.5 muss sich nicht als „in allem stärker als ein mittelgroßes Modell“ zeigen. Sie zeigt sich wahrscheinlicher an einer anderen Stelle: Kann es viele lokale Aufgaben, die sich wegen Kosten, Latenz oder Durchsatz zuvor nicht zu automatisieren lohnten, in Systemschritte verwandeln, die dauerhaft laufen?
Der gesunkene Preis verändert die Art des Aufrufs
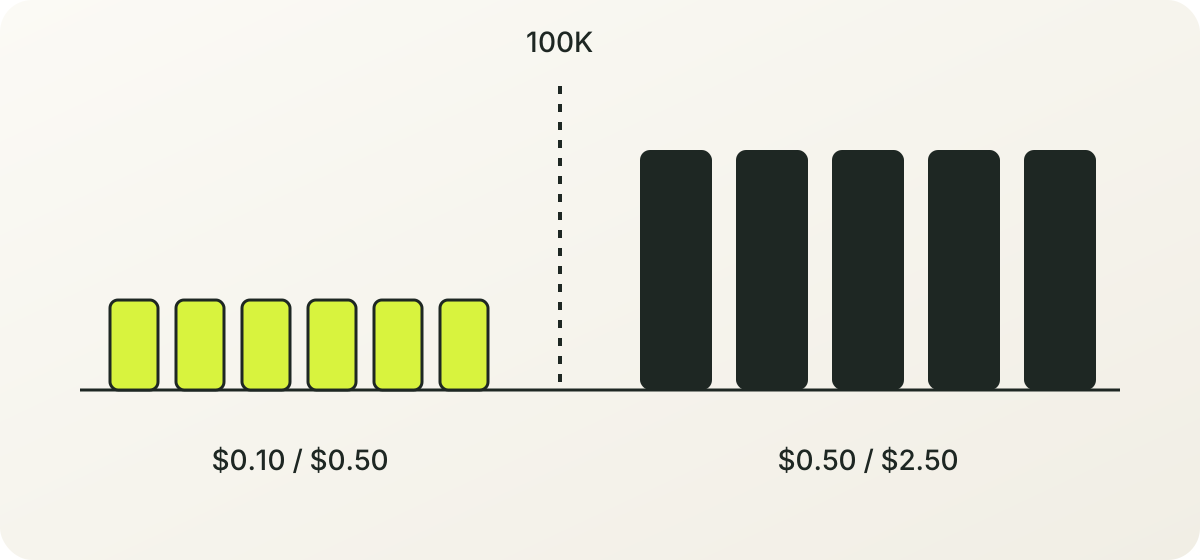
Der offizielle Preis von Haiku 5.5 ist in zwei Bereichen zu lesen. Bei Anfragen, deren Eingabe-Prompt 100K tokens nicht überschreitet, kostet die Eingabe $0.10 pro Million tokens und die Ausgabe $0.50 pro Million tokens; oberhalb von 100K tokens betragen die Preise $0.50 und $2.50.
| Anfragegröße | Eingabe | Ausgabe | Cache read |
|---|---|---|---|
| Höchstens 100K tokens | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| Über 100K tokens | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
Zwei Details gehen hier leicht unter.
Erstens sind ein niedrigerer Stückpreis und niedrigere reale Kosten nicht dasselbe. Die Formulierung von Anthropic „durchschnittliche Betriebskosten etwa 75% niedriger“ berücksichtigt bereits die veränderte Nutzung von tokens durch den neuen tokenizer. Man kann also nicht einfach die Preise pro Million tokens von altem und neuem Modell dividieren und daraus schließen, dass die Rechnung des Produkts im selben Verhältnis sinkt.
Zweitens verändert es die realen Kosten, ob das Modell die Aufgabe erfolgreich abschließt. Ein Aufruf kann billig sein; braucht er aber Wiederholungen, einen fallback auf Sonnet oder zusätzliche menschliche Prüfung, kann der endgültige Preis der Aufgabe trotzdem hoch bleiben.
Produktteams sollten deshalb eher diese Kennzahl beobachten:
Kosten jeder erfolgreichen Aufgabe
= gesamte Modell- und Werkzeugkosten zur Erledigung der Aufgaben ÷ Anzahl erfolgreich abgeschlossener Aufgaben
Wer verschiedene Architekturen weiter vergleichen will, sollte Wiederholungen, fallback, Werkzeugaufrufe und menschliche Übernahme in die Gesamtrechnung aufnehmen.
Eine der wichtigsten Änderungen an Haiku 5.5 ist, dass effort einstellbar wird
Haiku 5.5 ist das erste Modell der Haiku-Reihe mit einstellbarem effort. Diese Einstellung macht die Modellwahl nicht mehr zum einzigen Kostenschalter; das System kann innerhalb desselben Modells auch den Denkaufwand anpassen.
Man kann sich das wie die Fahrmodi eines Autos vorstellen:
- Bei einfacher Klassifikation und Formatumwandlung einen niedrigeren effort verwenden und Geschwindigkeit sowie niedrige Kosten vorziehen.
- Bei strukturierter Extraktion und Kompression langer Texte einen mittleren effort verwenden und Qualität gegen Kosten abwägen.
- Bei Aufgaben, die ein mehrschrittiges Urteil brauchen, den effort erhöhen.
- Schlägt die Aufgabe weiterhin fehl, erst dann auf Sonnet oder Opus wechseln.
Daraus entsteht eine neue Entscheidungsformel:
Endergebnis = Modell × effort × Kontext × Werkzeuge × Wiederholungsstrategie
Künftig genügt beim Vergleich von Modellen nicht mehr die Frage „wer ist stärker, Haiku 5.5 oder Sonnet 5.5?“. Außerdem ist zu fragen:
- Welche effort-Stufe ist bei derselben Aufgabe am günstigsten?
- Deckt der Qualitätsgewinn eines höheren effort die Mehrkosten?
- Verlängert ein höherer effort bei einer einfachen Aufgabe nur die Wartezeit?
- Ist es günstiger, Haiku noch einmal versuchen zu lassen, oder Sonnet einmal direkt aufzurufen?
Deshalb lässt sich Haiku 5.5 besser über die Kosten auf Aufgabenebene bewerten als über den Eindruck einer einzelnen Ausgabe.
Agents können von „ein großes Modell erledigt alles“ zu geschichteter Zusammenarbeit werden
Viele Agents waren früher ungefähr so gebaut: Nach der Anfrage des Nutzers übernimmt ein großes Modell Planung, Suche, Werkzeugaufrufe, das Ordnen der Ergebnisse und die endgültige Antwort.
Nutzeranfrage → großes Modell plant → großes Modell sucht → großes Modell fasst zusammen → großes Modell gibt aus
Diese Struktur ist einfach, lässt aber jede lokale Aktion dasselbe teure Modell verwenden. Bei einem Agent, der Dutzende Dokumente durchsucht, Hunderte Datensätze verarbeitet oder wiederholt einen Browser aufruft, summieren sich Kosten und Latenz schnell.
Haiku 5.5 passt besser in eine geschichtete Architektur dieser Art:
Nutzeranfrage
   ↓
Sonnet oder Opus zerlegt die Aufgabe und stellt den Plan auf
   ↓
Haiku 5.5 sucht, klassifiziert, extrahiert, fasst zusammen und führt einschrittige Werkzeugaufrufe aus
   ↓
Sonnet oder Opus prüft die Ergebnisse und trifft die endgültige Entscheidung
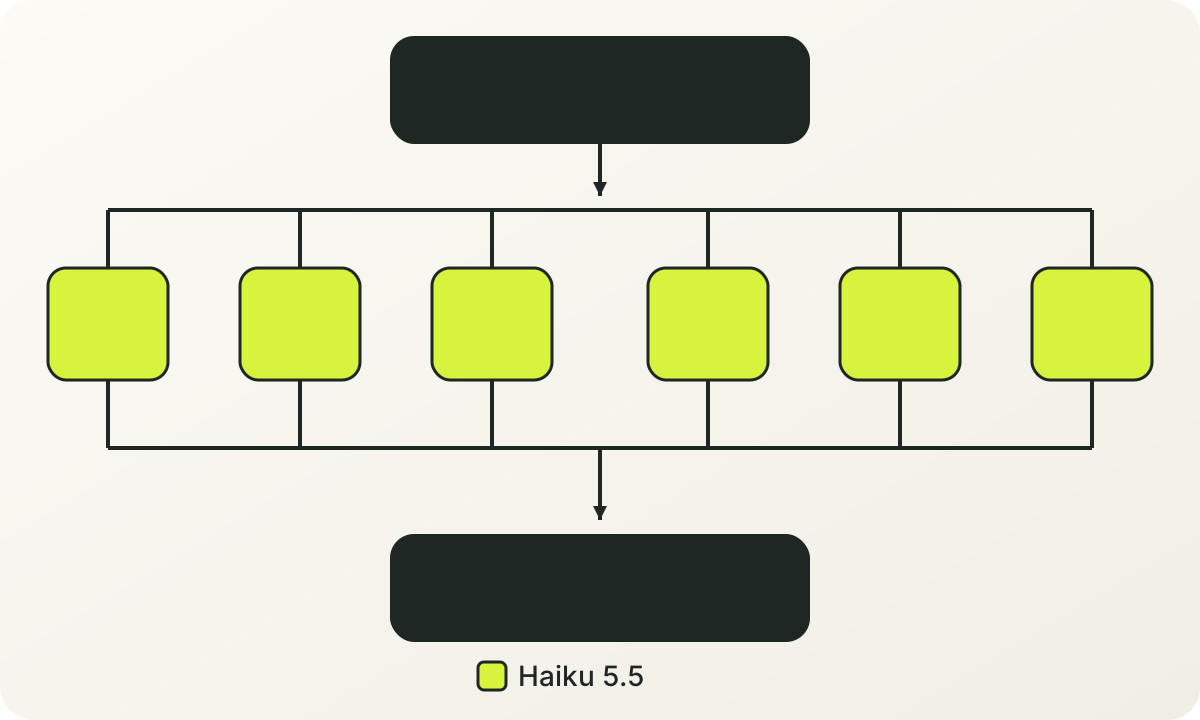
In dieser Struktur liegt der Wert von Haiku 5.5 nicht darin, die komplexeste Aufgabe allein zu Ende zu bringen, sondern die „Arbeiterschicht“ des Agents zu werden. Es übernimmt die lokale Arbeit, die am zahlreichsten ist, relativ klar strukturiert und überprüfbar.
Welche Arbeit zu Haiku 5.5 passt
- Eine Nutzeranfrage in verschiedene Arbeitsabläufe leiten.
- Feste Felder aus einem Dokument oder aus wenigen Dokumenten extrahieren.
- Tickets klassifizieren und nach Priorität ordnen.
- Ein langes Gespräch in den Kontext verdichten, den die nächste Agent-Runde braucht.
- Suchergebnisse deduplizieren und eine erste Zusammenfassung schreiben.
- Eine eindeutige Browseraktion ausführen.
- Das Codeformat prüfen, einen einfachen Test erzeugen oder lokalen Code erklären.
- Als Subagent von Sonnet oder Opus ein kurzes Stück Arbeit erledigen.
Welche Arbeit nicht standardmäßig an Haiku 5.5 gehen sollte
- Komplexe Projekte, die Planung über einen langen Horizont brauchen.
- Codeänderungen, die mehrere Dateien, mehrere Abhängigkeiten und mehrere Feedbackrunden betreffen.
- Kritische Entscheidungen, bei denen ein einzelner Fehler hohen Schaden bringt.
- Arbeit, die über einen langen Verlauf einen komplexen Zustand halten muss.
- Aufgaben ohne automatische Prüfung, die sich nur auf menschliches Urteil stützen können.
Der Punkt ist nicht, dem Modell das Etikett „kann“ oder „kann nicht“ zu geben, sondern den Preis eines Fehlschlags zu bewerten. Bei Aufgaben, die sich automatisch prüfen und nach einem Fehlschlag wiederholen lassen, wird das Preis-Leistungs-Verhältnis von Haiku 5.5 attraktiver; bei Aufgaben mit hohem Fehlerpreis bleiben Sonnet oder Opus die sicherere Wahl.
Wie gewöhnliche Entwickler unter den drei Modellen wählen
Zuerst lässt sich nach Aufgabenkomplexität und Fehlerpreis einfach routen:
| Aufgabenmerkmal | Standardwahl | Bedingung für einen Wechsel nach oben |
|---|---|---|
| Festes Ausgabeformat, automatisch prüfbar | Haiku 5.5 | Aufeinanderfolgende Formatfehler oder ein Schlüsselfeld fehlt |
| Hohes Aufrufvolumen, latenzempfindlich | Haiku 5.5 | p95-Latenz oder Fehlerrate überschreitet die Produktschwelle |
| Zusammenfassung, Kompression, Klassifikation oder Extraktion nötig | Haiku 5.5 | Dokumentübergreifendes Schlussfolgern oder ein Kontextkonflikt tritt auf |
| Gewöhnliche Wissensarbeit und Codeänderungen | Sonnet 5.5 | Die Aufgabe spannt sich über längere Zeit oder braucht mehrere Planungsrunden |
| Komplexe Agents und Programmieren über lange Horizonte | Sonnet 5.5 oder Opus 5.5 | Sehr geringe Fehlertoleranz oder Bedarf an tiefem Schlussfolgern |
| Hochriskantes Urteil und abschließende Prüfung | Sonnet 5.5 oder Opus 5.5 | Entscheiden nach dem Preis eines Fehlers und nach der Prüfbarkeit |
Diese Tabelle ist keine für immer feste Antwort. Vor dem echten Produktionseinsatz sollte am eigenen Aufgabensatz gemessen werden, wo sich jede Modellstufe bei Erfolgsrate, Latenz und Kosten jeder erfolgreichen Aufgabe trennt.
100K tokens ist eine Preisgrenze, auf die besonders zu achten ist
Der beworbene Preis von Haiku 5.5 ist sehr niedrig, nach 100K tokens steigt er aber deutlich. Teams mit langen Dokumenten, Code-Repositories und langen Gesprächen dürfen nicht nur auf den veröffentlichten Einstiegspreis des Modells sehen.
Ein Arbeitsablauf mit langem Kontext lässt sich in einige Schritte zerlegen:
- Beim ersten Lesen des Dokuments einen Cache aufbauen.
- Mit Haiku 5.5 den Kontext komprimieren.
- Sonnet nur die Stellen übergeben, die zur aktuellen Frage gehören.
- Zwischenergebnisse als strukturierten Zustand speichern.
- Nicht in jeder Runde die vollständige Historie erneut senden.
Dieser Ablauf hat zwei Vorteile: Er senkt die Wahrscheinlichkeit, die Preisstufe über 100K zu überschreiten, und er lässt verschiedene Modelle verschiedene Arbeit tragen.
Der Wert des langen Kontexts von Haiku 5.5 lässt sich deshalb nicht nur daran messen, „wie viele tokens es höchstens lesen kann“. Praktischer ist die Frage:
- Wie viel Rohinhalt muss in das Modell?
- Welcher Inhalt sollte zuerst komprimiert werden?
- Wie hoch ist die Cache-Trefferquote?
- Ist der Preis oberhalb von 100K noch vertretbar?
- Kann der Informationsverlust durch die Kompression spätere Aufgaben scheitern lassen?
Die Veröffentlichung von Haiku 5.5 verschiebt auch den Schwerpunkt der Modellbewertung
Die offizielle Seite nennt bereits mehrere Ergebnisse, darunter GDPval-AA, OSWorld, Humanity's Last Exam und Terminal-Bench. Sie helfen dem Leser, den ungefähren Fähigkeitsbereich des Modells zu sehen, aber ein Produktteam braucht weiterhin eigene Aufgabentests.
In einem realen System verdient nicht der einzelne Wert eines Modells auf einem Benchmark die meiste Beobachtung, sondern diese Gruppe von Kennzahlen:
- Erfolgsrate der Aufgaben.
- Ausgabequalität.
- Latenz p50 und p95.
- Zahl der Eingabe- und Ausgabe-tokens.
- Wiederholungsrate.
- Fehlerrate der Werkzeugaufrufe.
- fallback-Rate.
- Rate der menschlichen Übernahme.
- Kosten jeder erfolgreichen Aufgabe.
Besonders zu beachten ist die Stabilität bei wiederholten Läufen. Eine schöne Antwort auf denselben Prompt zeigt nur, dass dieser Lauf gelungen ist; sie zeigt nicht unmittelbar, dass das Modell gleichartige Aufgaben in der Produktion stabil erledigt.
Ein zuverlässigeres Testverfahren besteht darin:
- Für jede Aufgabenart eine eigene Gruppe unabhängiger Stichproben vorzubereiten.
- Sie unter demselben System-Prompt, demselben Kontext, denselben Werkzeugdefinitionen und derselben Region auszuführen.
- Jede Stichprobe mehrfach zu wiederholen.
- Die Ergebnisse mit Regeln, verdeckten Tests oder einer blinden menschlichen Bewertung zu beurteilen.
- Erfolgsrate und Konfidenzintervall zu berichten.
- Die schlechtesten Fälle und die Fehlerarten gesondert auszuweisen.
Dieses Verfahren verschiebt die Modellbewertung am Ende von „welche Ausgabe war die beste“ zu „kann dieses System die Arbeit dauerhaft erledigen“.
Was Haiku 5.5 für einzelne Nutzer bedeutet
Einzelne Nutzer spüren die Änderung des API-Stückpreises nicht unbedingt unmittelbar, können die Stellung von Haiku 5.5 aber aus drei Blickwinkeln verstehen.
Erstens passt es besser zu schnellen, wiederholten Aufgaben mit klarer Grenze, etwa Text ordnen, Informationen extrahieren, einen strukturierten Entwurf erzeugen und eine große Zahl kleiner Fragen bearbeiten.
Zweitens eignet es sich nicht unbedingt als Ersatz für alle stärkeren Modelle. Komplexes Schreiben, Planung über lange Horizonte, schwieriger Code und Arbeit, die einen Zustand durchgehend halten muss, hängen weiterhin stärker von Sonnet oder Opus ab.
Drittens gleichen die Unterschiede zwischen Modellen immer mehr Unterschieden in der Arbeitsweise und nicht einem einfachen Unterschied von hoch und niedrig. Bei der Wahl eines Modells sollte man zuerst auf die Häufigkeit der Aufgabe, die Latenzanforderung, den Preis eines Fehlers und die Mittel der Prüfung sehen, und erst danach auf die Fähigkeit eines einzelnen Aufrufs.
Was ein Produktteam neu rechnen muss, ist die Ökonomie der Aufgabeneinheit
Haiku 5.5 macht viele Schritte leichter ausprobierbar, deren Automatisierung sich früher nicht lohnte:
- Eine weitere Schicht der Eingabeklassifikation.
- Eine weitere Runde, die Suchergebnisse komprimiert.
- Einen weiteren Subagenten, der eigens Dokumente bearbeitet.
- Eine weitere günstige Prüfung der Ausgabe.
- Eine weitere strukturierte Prüfung vor der endgültigen Antwort.
Diese zusätzlichen Schritte erhöhen für sich die Zahl der Aufrufe. Senken sie aber die endgültige Fehlerrate, können die Gesamtkosten des Produkts trotzdem sinken.
Genau deshalb reicht der Preis eines einzelnen Modellaufrufs nicht. Was ein Produktteam wirklich vergleichen muss, ist:
Kosten eines einzelnen Aufrufs
→ Gesamtkosten einer Aufgabe
→ Gesamtkosten einer erfolgreichen Aufgabe
→ Gesamtkosten eines lieferbaren Ergebnisses
Wenn Haiku 5.5 billig genug ist, kann ein System mehrere kleine Aufgaben gegen eine höhere endgültige Zuverlässigkeit eintauschen. Diese Veränderung betrifft den Entwurf von Agents, die Gewinnstruktur des Produkts und die Entscheidung, welche Arbeit das Team einem Modell zur automatischen Erledigung übergibt.
Schluss: Haiku 5.5 ist eine Veränderung der Architektur
Die Veröffentlichung von Haiku 5.5 lässt sich als Upgrade eines kleinen Modells verstehen und auch als ein Vorstoß von Anthropic bei der Form des Modellprodukts.
Sie legt drei Fragen auf dieselbe Entscheidungstabelle:
- Wie viel Intelligenz braucht diese Aufgabe?
- Wie viel Latenz kann diese Aufgabe tragen?
- Wie viel Geld ist diese Aufgabe wert?
Stehen Modellwahl, Aufgabenrouting, effort, Cache, Wiederholungen und menschliche Übernahme beisammen, ist „welches Modell ist das stärkste“ nicht mehr die einzige Frage. Die wichtigere Frage wird:
Welches Modell soll welchen Aufruf bearbeiten, und wie erhält man bei den niedrigsten Ende-zu-Ende-Kosten ein ausreichend zuverlässiges Ergebnis?
Die Bedeutung von Haiku 5.5 liegt vielleicht darin, dass es diese Frage zum ersten Mal billig genug macht, um sie in großem Maßstab zu stellen.