Haiku 5.5: Anthropic está convirtiendo la capacidad de los modelos en un sistema de división del trabajo
El valor de Claude Haiku 5.5 no está solo en que responde más rápido y más barato, sino en que empieza a convertir las llamadas al modelo en una infraestructura que se puede desplegar a gran escala.
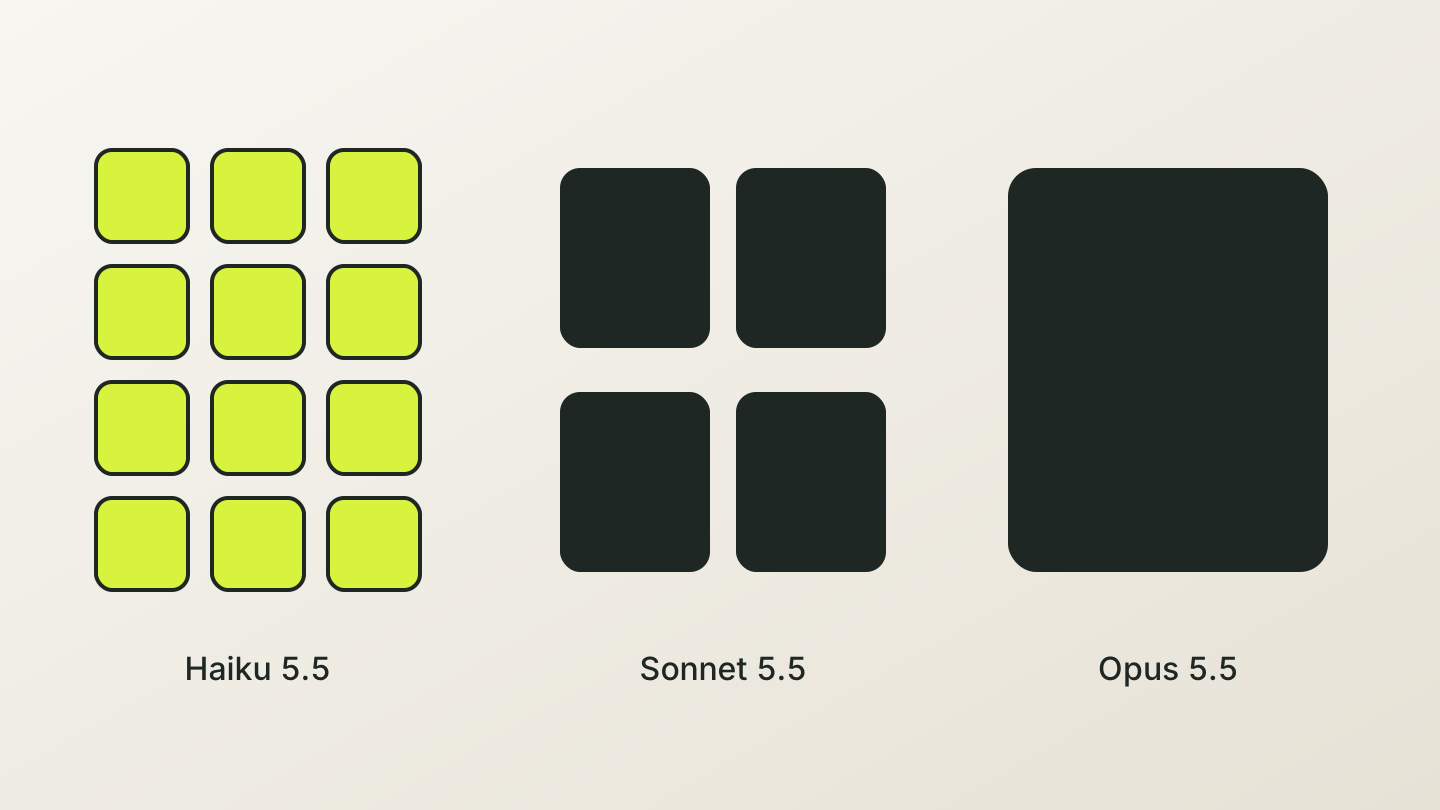
Haiku 5.5: Anthropic está convirtiendo la capacidad de los modelos en un sistema de división del trabajo
El valor de Claude Haiku 5.5 no está solo en que responde más rápido y más barato, sino en que empieza a convertir las llamadas al modelo en una infraestructura que se puede desplegar a gran escala.
Anthropic publicó Claude Haiku 5.5 el 7 de octubre de 2026. Conviene aclarar primero un nombre fácil de confundir: en los materiales públicos oficiales de Anthropic, el nombre del modelo es Claude Haiku 5.5 y el ID del modelo es claude-haiku-5-5. No hay un modelo oficial llamado "Claude Hiya 5.5". Este artículo usa Haiku 5.5 en todo el texto.
El posicionamiento de Anthropic es explícito. Es un modelo pequeño para tareas de alta concurrencia, baja latencia y sensibles al coste, adecuado para clasificación, extracción de información, resumen, compresión de contexto, consultas a bases de datos, acciones en el navegador y subtareas de agente. Según lo oficial, el coste medio de ejecución de Haiku 5.5 es aproximadamente un 75% más bajo que el de Haiku 4.5. También es el primer modelo de la serie Haiku con un ajuste de effort regulable.
Eso cambia la pregunta sobre Haiku 5.5, de «¿es otro modelo pequeño más fuerte?», a una más práctica: cuando un modelo es lo bastante barato como para llamarlo en gran número, ¿qué cambia en la división del trabajo entre modelos dentro de un producto de IA?
La familia Claude 5.5 está formando una división del trabajo clara
Si solo se miran los nombres, es fácil entender Opus, Sonnet y Haiku como tres puestos de una misma clasificación de capacidad. Una lectura más precisa es que están formando una división del trabajo entre modelos, orientada a cargas de trabajo distintas.
| Modelo | Rol más adecuado | Tareas típicas |
|---|---|---|
| Claude Opus 5.5 | Experto en problemas complejos y planificador de largo horizonte | Agentes complejos, programación prolongada, razonamiento difícil, decisiones críticas |
| Claude Sonnet 5.5 | Modelo principal del trabajo cotidiano | Cambios de código, generación de documentos, análisis, trabajo de conocimiento en varios pasos |
| Claude Haiku 5.5 | Capa de ejecución de llamadas frecuentes | Clasificación, extracción, resumen, compresión, enrutamiento, navegador y tareas de subagente |
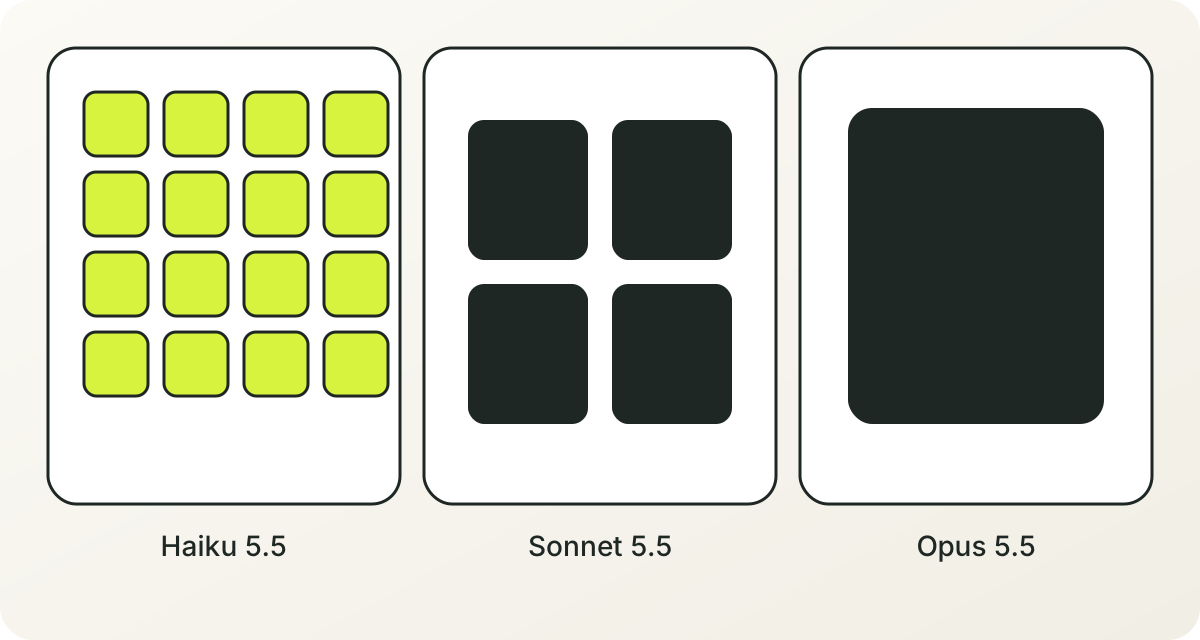
La visión general de modelos de Anthropic usa una colocación parecida. Opus 5.5 se orienta a la programación de agentes de larga duración y al trabajo de conocimiento. Sonnet 5.5 subraya el equilibrio entre velocidad e inteligencia. Haiku 5.5 se orienta a tareas de clasificación, extracción y enrutamiento de alta concurrencia y baja latencia.
Esto significa que la ventaja de Haiku 5.5 no tiene por qué aparecer como «más fuerte que un modelo mediano en todo». Es más probable que aparezca en otro lugar: si puede convertir un gran número de tareas locales que no merecían automatizarse, por el coste, la latencia o la capacidad de proceso, en pasos de sistema que pueden seguir en marcha.
Un precio más bajo cambia la forma de hacer las llamadas
El precio oficial de Haiku 5.5 hay que entenderlo en dos intervalos. Para las solicitudes cuyo prompt de entrada no supera los 100K tokens, el precio de entrada es $0.10 por millón de tokens y el de salida es $0.50 por millón de tokens. Por encima de 100K tokens, esos precios pasan a ser $0.50 y $2.50.
| Tamaño de la solicitud | Entrada | Salida | Cache read |
|---|---|---|---|
| Hasta 100K tokens | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| Más de 100K tokens | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
Hay dos detalles fáciles de pasar por alto.
Primero, que baje el precio unitario y que baje el coste real no es la misma cosa. El «coste medio de ejecución aproximadamente un 75% más bajo» de Anthropic ya incluye el cambio en el uso de tokens que trae el nuevo tokenizer. No basta con dividir el precio por millón de tokens del modelo nuevo entre el del antiguo para inferir que la factura del producto bajará en la misma proporción.
Segundo, que el modelo termine o no la tarea con éxito cambia el coste real. Una llamada puede ser barata, pero, si necesita reintentos, un fallback a Sonnet o una revisión humana añadida, el coste final de la tarea puede seguir siendo alto.
Por eso, los equipos de producto deberían fijarse más en esta medida:
Coste por tarea exitosa
= gasto total en modelos y herramientas para completar las tareas ÷ número de tareas completadas con éxito
Si se comparan arquitecturas con más detalle, también hay que meter en la factura total los reintentos, el fallback, las llamadas a herramientas y la toma de control humana.
Uno de los cambios más importantes de Haiku 5.5 es que el effort se vuelve regulable
Haiku 5.5 es el primer modelo de la serie Haiku que ofrece un effort regulable. Ese ajuste hace que la «elección de modelo» deje de ser el único interruptor de coste. El sistema también puede ajustar, dentro del mismo modelo, cuánto razonamiento invierte.
Se puede entender como los modos de conducción de un coche:
- Para la clasificación simple y la conversión de formato, usar un effort más bajo y priorizar la velocidad y el bajo coste.
- Para la extracción estructurada y la compresión de textos largos, usar un effort medio y equilibrar calidad y gasto.
- Para las tareas que necesitan un juicio en varios pasos, subir el effort.
- Si la tarea sigue fallando, pasar entonces a Sonnet u Opus.
Eso da una fórmula de decisión nueva:
Resultado final = modelo × effort × contexto × herramientas × política de reintento
Por eso, al comparar modelos de ahora en adelante, no basta con preguntar «quién es más fuerte, Haiku 5.5 o Sonnet 5.5». También hay que preguntar:
- En la misma tarea, ¿qué nivel de effort sale más a cuenta?
- ¿La subida de calidad de un effort más alto cubre el coste extra?
- En una tarea simple, ¿subir el effort solo alarga el tiempo de espera?
- ¿Sale más a cuenta dejar que Haiku lo intente una vez más, o llamar a Sonnet una sola vez?
Por eso Haiku 5.5 se evalúa mejor por el coste a nivel de tarea que por la impresión de una sola salida.
Los agentes pueden pasar de «un modelo grande que lo hace todo» a una colaboración por capas
Antes, la estructura de muchos agentes se parecía a esto: después de que el usuario plantea una solicitud, un modelo grande se encarga de planificar, recuperar, llamar a las herramientas, ordenar los resultados y dar la respuesta final.
Solicitud del usuario → el modelo grande planifica → el modelo grande busca → el modelo grande resume → el modelo grande responde
Esa estructura es simple, pero hace que cada acción local use el mismo modelo caro. Para un agente que tiene que buscar en decenas de documentos, procesar cientos de registros o llamar al navegador una y otra vez, el coste y la latencia se acumulan enseguida.
Haiku 5.5 encaja mejor en una arquitectura por capas como esta:
Solicitud del usuario
   ↓
Sonnet u Opus descompone la tarea y elabora el plan
   ↓
Haiku 5.5 busca, clasifica, extrae, resume y hace llamadas a herramientas de un solo paso
   ↓
Sonnet u Opus revisa los resultados y toma la decisión final
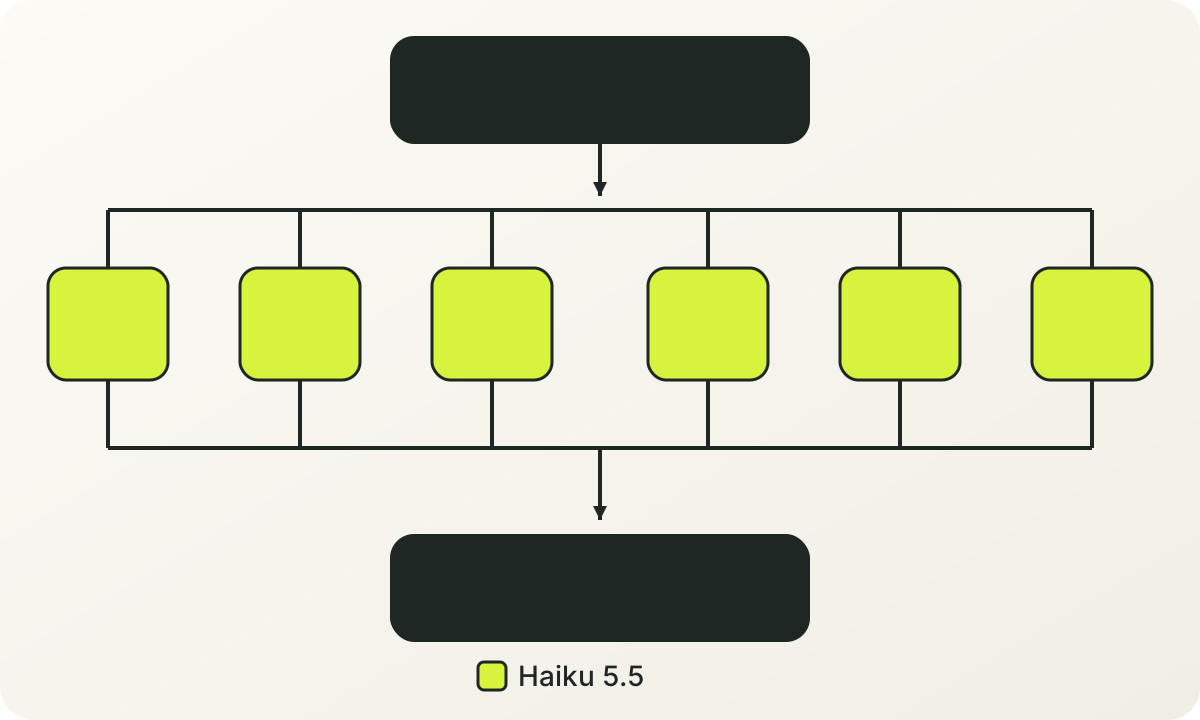
En esta estructura, el valor de Haiku 5.5 no es completar por su cuenta la tarea más compleja, sino convertirse en la «capa de trabajadores» del agente. Se ocupa del trabajo local más numeroso, de estructura relativamente clara y que se puede verificar.
Trabajo que conviene entregar a Haiku 5.5
- Enrutar la solicitud del usuario hacia distintos flujos de trabajo.
- Extraer campos fijos de un documento o de unos pocos documentos.
- Clasificar tickets y ordenarlos por prioridad.
- Comprimir una conversación larga en el contexto que necesita la siguiente vuelta del agente.
- Quitar duplicados de los resultados de búsqueda y hacer un resumen preliminar.
- Realizar una acción explícita en el navegador.
- Comprobar el formato del código, generar una prueba simple o explicar un fragmento local de código.
- Completar un tramo corto de trabajo como subagente de Sonnet u Opus.
Trabajo que no debería entregarse a Haiku 5.5 por defecto
- Proyectos complejos que necesitan planificación de largo horizonte.
- Cambios de código que tocan varios archivos, varias dependencias y varias rondas de comentarios.
- Decisiones críticas en las que un solo error supone una pérdida alta.
- Trabajo que tiene que mantener un estado complejo a lo largo de un proceso largo.
- Tareas sin medio de verificación automática, que solo pueden depender de un juicio humano.
La clave no es etiquetar al modelo como «puede» o «no puede», sino evaluar el coste de que la tarea falle. En las tareas que se pueden comprobar de forma automática y reintentar después de un fallo, la relación entre precio y resultado de Haiku 5.5 resulta más atractiva. En las tareas cuyo fallo sale muy caro, Sonnet u Opus siguen siendo la opción más segura.
Cómo puede un desarrollador ordinario elegir entre los tres modelos
Se puede empezar con un enrutamiento simple según la complejidad de la tarea y el coste del fallo:
| Rasgo de la tarea | Elección por defecto | Condición para subir |
|---|---|---|
| Formato de salida fijo y verificable de forma automática | Haiku 5.5 | Errores de formato seguidos, o falta un campo clave |
| Mucho volumen de llamadas y sensibilidad a la latencia | Haiku 5.5 | La latencia p95 o la tasa de fallos supera el umbral del producto |
| Hace falta resumen, compresión, clasificación o extracción | Haiku 5.5 | Aparece razonamiento entre documentos o un conflicto de contexto |
| Trabajo de conocimiento ordinario y cambios de código | Sonnet 5.5 | La tarea abarca un horizonte largo o necesita varias rondas de planificación |
| Agentes complejos y programación de largo horizonte | Sonnet 5.5 u Opus 5.5 | La tolerancia al error es muy baja, o hace falta un razonamiento profundo |
| Juicio de alto riesgo y revisión final | Sonnet 5.5 u Opus 5.5 | Se decide según el coste del error y la capacidad de verificación |
Esta tabla no debería tomarse como una respuesta fija para siempre. Antes de pasar de verdad a producción, hay que medir con el propio conjunto de tareas el punto en el que cada nivel de modelo se separa en tasa de éxito, latencia y coste por tarea exitosa.
100K tokens es un límite de precio al que hay que prestar atención
El precio anunciado de Haiku 5.5 es muy bajo, pero después de 100K tokens el precio sube de forma clara. En aplicaciones de documentos largos, repositorios de código y conversaciones largas, el equipo no puede mirar solo el precio de partida publicado del modelo.
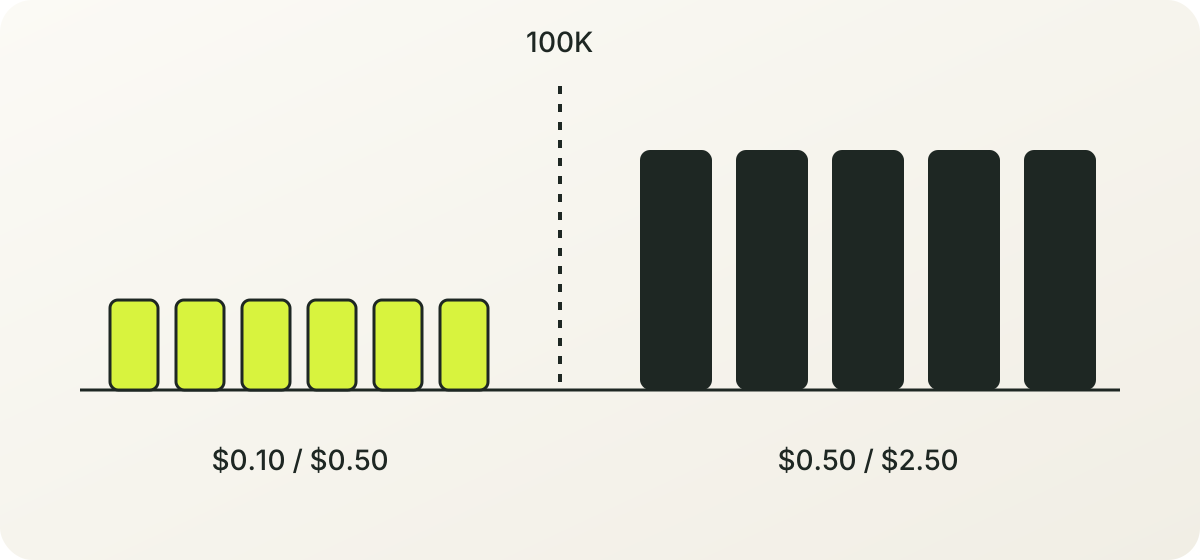
Un flujo de trabajo de contexto largo se puede partir en estos pasos:
- Crear la caché la primera vez que se lee el documento.
- Usar Haiku 5.5 para comprimir el contexto.
- Entregar a Sonnet solo los fragmentos relacionados con la pregunta actual.
- Guardar los resultados intermedios como estado estructurado.
- Evitar volver a enviar el historial completo en cada vuelta.
Este flujo tiene dos ventajas. Baja la probabilidad de cruzar el intervalo de precio de los 100K, y permite que modelos distintos asuman trabajos distintos.
Por eso, el valor de contexto largo de Haiku 5.5 no se puede medir solo con «cuántos tokens puede leer como máximo». Las preguntas más prácticas son:
- Cuánto contenido en bruto hay que meter en el modelo.
- Qué contenido debería comprimirse primero.
- Cuál es la tasa de aciertos de caché.
- Si el precio por encima de 100K sigue siendo aceptable.
- Si la pérdida de información debida a la compresión puede hacer fallar una tarea posterior.
El lanzamiento de Haiku 5.5 también cambia el foco de la evaluación de modelos
La página oficial ya ofrece varias puntuaciones, entre ellas GDPval-AA, OSWorld, Humanity's Last Exam y Terminal-Bench. Ayudan al lector a hacerse una idea del rango aproximado de capacidad del modelo, pero el equipo de producto sigue necesitando pruebas sobre sus propias tareas.
En un sistema real, lo que más merece observarse no es la puntuación aislada de un modelo en un benchmark, sino este conjunto de medidas:
- Tasa de éxito de la tarea.
- Calidad de la salida.
- Latencia p50 y p95.
- Número de tokens de entrada y de salida.
- Tasa de reintento.
- Tasa de error en las llamadas a herramientas.
- Tasa de fallback.
- Tasa de toma de control humana.
- Coste por tarea exitosa.
Hay que prestar atención especial a la estabilidad entre repeticiones. Una respuesta atractiva a un mismo Prompt solo demuestra que esa ejecución tuvo éxito. No demuestra directamente que el modelo vaya a completar de forma estable el mismo tipo de tarea en producción.
Una forma de prueba más fiable es esta:
- Preparar un conjunto de muestras independientes para cada tipo de tarea.
- Ejecutarlas con el mismo prompt de sistema, el mismo contexto, las mismas definiciones de herramientas y la misma región.
- Repetir cada muestra varias veces.
- Juzgar los resultados con reglas, pruebas ocultas o una revisión humana a ciegas.
- Informar de la tasa de éxito y del intervalo de confianza.
- Listar por separado los peores casos y los tipos de fallo.
Este método acaba llevando la evaluación del modelo desde «qué salida fue la mejor» hasta «si este sistema puede seguir completando el trabajo».
Qué significa Haiku 5.5 para un usuario individual
Un usuario individual quizá no note de forma directa el cambio del precio unitario de la API, pero puede entender el lugar de Haiku 5.5 desde tres ángulos.
Primero, encaja mejor en tareas rápidas, repetidas y de límite claro, como ordenar texto, extraer información, generar un borrador estructurado y tratar una gran cantidad de problemas pequeños.
Segundo, no tiene por qué sustituir a todos los modelos más avanzados. La escritura compleja, la planificación de largo horizonte, el código difícil y el trabajo que necesita mantener el estado de forma continua siguen dependiendo más de Sonnet u Opus.
Tercero, la diferencia entre modelos se parece cada vez más a una «diferencia de forma de trabajar», y no a una simple diferencia de más alto o más bajo. Al elegir un modelo, hay que mirar primero la frecuencia de la tarea, la latencia que exige, el coste de un error y el medio de verificación, y después la capacidad de una sola llamada.
Para un equipo de producto, lo que hay que recalcular es la economía por unidad de tarea
Haiku 5.5 hace más fácil probar muchos pasos que antes no merecían automatizarse:
- Una capa más de clasificación de la entrada.
- Una pasada más que comprime los resultados de la recuperación.
- Un subagente más, dedicado a los documentos.
- Una comprobación más, de bajo coste, de la salida.
- Una verificación estructurada más antes de la respuesta final.
Esos pasos añadidos aumentan por sí mismos el número de llamadas. Si consiguen bajar la tasa final de fallos, el coste del producto en conjunto puede bajar de todos modos.
Por eso el «precio de una sola llamada al modelo» no basta. Lo que un equipo de producto tiene que comparar de verdad es:
Coste de una llamada
→ coste total de una tarea
→ coste total de una tarea exitosa
→ coste total de un resultado entregable
Cuando Haiku 5.5 es lo bastante barato, el sistema puede tener capacidad de cambiar varias tareas pequeñas por una fiabilidad final más alta. Ese cambio afecta al diseño del agente, a la estructura de margen del producto y a qué trabajo decide el equipo entregar al modelo para que lo complete de forma automática.
Cierre: Haiku 5.5 es un cambio de arquitectura
El lanzamiento de Haiku 5.5 puede entenderse como una mejora de un modelo pequeño. También puede entenderse como un avance de Anthropic en la forma del producto de modelos.
Pone tres preguntas en la misma hoja de decisión:
- Cuánta inteligencia necesita esta tarea.
- Cuánta latencia puede soportar esta tarea.
- Cuánto dinero merece esta tarea.
Cuando la elección de modelo se pone junto al enrutamiento de tareas, el effort, la caché, los reintentos y la toma de control humana, «qué modelo es el más fuerte» deja de ser la única pregunta. La pregunta más importante pasa a ser:
¿Qué modelo debe atender cada tipo de llamada, y cómo se obtiene un resultado lo bastante fiable al coste de extremo a extremo más bajo?
El sentido de Haiku 5.5 quizá esté en que hace que esta pregunta, por primera vez, sea lo bastante barata como para que merezca plantearse a gran escala.