Haiku 5.5 : Anthropic transforme la capacité des modèles en un système de division du travail
La valeur de Claude Haiku 5.5 ne tient pas seulement à ce qu’il répond plus vite et moins cher, mais à ce qu’il commence à transformer les appels de modèle en une infrastructure qui peut être déployée à grande échelle.
Haiku 5.5 : Anthropic transforme la capacité des modèles en un système de division du travail
La valeur de Claude Haiku 5.5 ne tient pas seulement à ce qu’il répond plus vite et moins cher, mais à ce qu’il commence à transformer les appels de modèle en une infrastructure qui peut être déployée à grande échelle.
Anthropic a publié Claude Haiku 5.5 le 7 octobre 2026. Précisons d’abord un nom facile à confondre : dans les documents publics officiels d’Anthropic, le nom du modèle est Claude Haiku 5.5, l’ID du modèle est claude-haiku-5-5, et il n’existe pas de modèle officiel nommé « Claude Hiya 5.5 ». Cet article utilise Haiku 5.5 partout.
Anthropic le positionne clairement : c’est un petit modèle destiné aux tâches à forte concurrence, à faible latence et sensibles au coût, adapté à la classification, à l’extraction d’information, au résumé, à la compression de contexte, aux requêtes de base de données, aux opérations de navigateur et aux sous-tâches d’Agent. Officiellement, le coût moyen d’exécution de Haiku 5.5 est environ 75% plus bas que celui de Haiku 4.5 ; c’est aussi le premier modèle de la série Haiku à offrir un réglage effort ajustable.
Cela fait passer la question de Haiku 5.5 de « est-ce encore un petit modèle plus fort ? » à une question plus concrète : quand un modèle est assez bon marché pour être appelé en grand nombre, que devient la division du travail entre les modèles d’un produit d’IA ?
La famille Claude 5.5 forme une division du travail claire
Si l’on ne regarde que les noms des modèles, il est facile de prendre Opus, Sonnet et Haiku pour trois places sur un même classement de capacité. Une lecture plus juste est qu’ils forment une division du travail tournée vers des charges différentes.
| Modèle | Rôle le mieux adapté | Tâches typiques |
|---|---|---|
| Claude Opus 5.5 | Expert des problèmes complexes et planificateur à long horizon | Agents complexes, codage de longue durée, raisonnement difficile, décisions critiques |
| Claude Sonnet 5.5 | Modèle principal du travail quotidien | Modifications de code, génération de documents, analyse, travail de connaissance en plusieurs étapes |
| Claude Haiku 5.5 | Couche d’exécution à haute fréquence d’appel | Classification, extraction, résumé, compression, routage, navigateur et tâches de sous-agent |
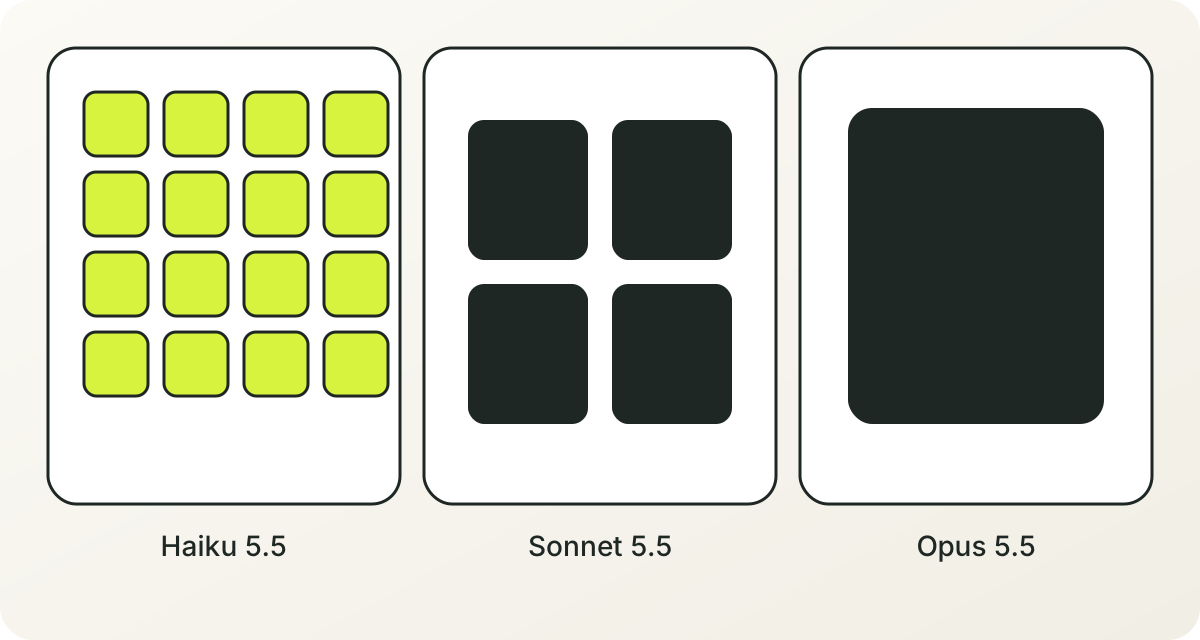
L’aperçu des modèles d’Anthropic adopte un placement semblable : Opus 5.5 vise la programmation d’Agent sur une longue durée et le travail de connaissance, Sonnet 5.5 insiste sur l’équilibre entre vitesse et intelligence, Haiku 5.5 vise les tâches de classification, d’extraction et de routage à forte concurrence et à faible latence.
Cela signifie que la force de Haiku 5.5 ne se montre pas forcément comme « plus fort qu’un modèle de taille moyenne en toute chose ». Elle se montre plus probablement ailleurs : peut-il transformer une grande quantité de tâches locales, qui ne valaient pas la peine d’être automatisées à cause du coût, de la latence ou du débit, en étapes de système capables de tourner en continu ?
La baisse du prix change la manière d’appeler le modèle
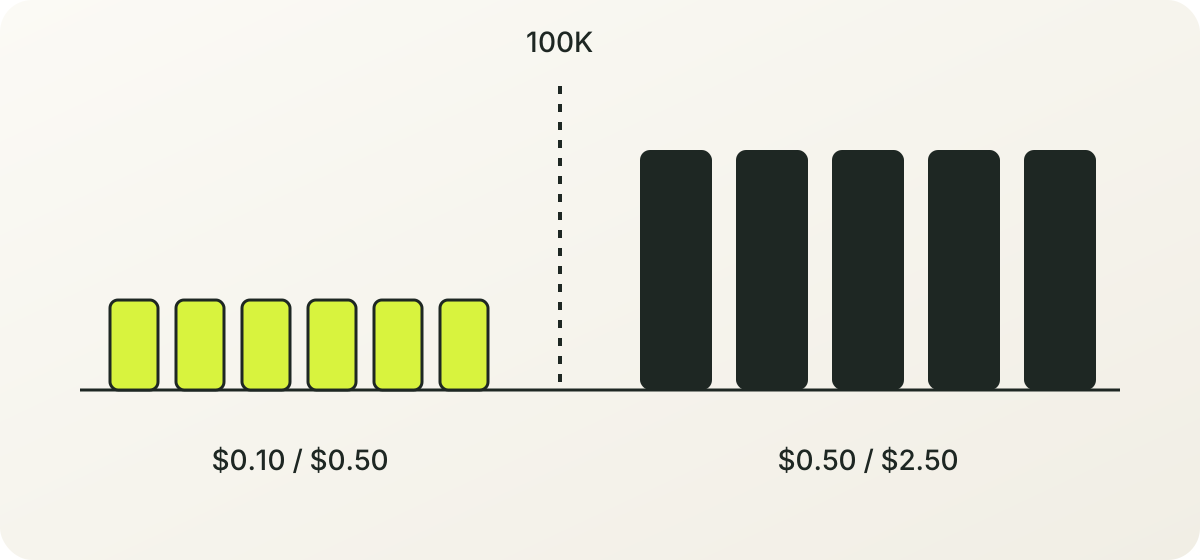
Le prix officiel de Haiku 5.5 doit se lire en deux tranches. Pour une requête dont le prompt d’entrée ne dépasse pas 100K tokens, le prix d’entrée est de $0.10 par million de tokens et le prix de sortie de $0.50 par million de tokens ; au-delà de 100K tokens, les prix sont respectivement de $0.50 et de $2.50.
| Taille de la requête | Entrée | Sortie | Cache read |
|---|---|---|---|
| Au plus 100K tokens | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| Au-delà de 100K tokens | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
Deux détails passent ici facilement inaperçus.
Premièrement, une baisse du prix unitaire et une baisse du coût réel ne sont pas la même chose. La formule d’Anthropic « coût moyen d’exécution plus bas d’environ 75% » tient déjà compte du changement d’usage des tokens apporté par le nouveau tokenizer. Autrement dit, on ne peut pas se contenter de diviser le prix par million de tokens de l’ancien modèle et du nouveau pour en conclure que la facture du produit baissera dans la même proportion.
Deuxièmement, le fait que le modèle mène ou non la tâche à bien change le coût réel. Un appel peut être bon marché, mais s’il faut des nouvelles tentatives, un fallback vers Sonnet et une vérification humaine en plus, le coût final de la tâche peut rester élevé.
Les équipes produit devraient donc plutôt suivre cet indicateur :
Coût de chaque tâche réussie
= total des frais de modèles et d’outils engagés pour accomplir les tâches ÷ nombre de tâches accomplies avec succès
Pour comparer plus avant différentes architectures, il faut aussi faire entrer dans la facture totale les nouvelles tentatives, le fallback, les appels d’outils et la reprise humaine.
L’un des changements les plus importants de Haiku 5.5 est que l’effort devient ajustable
Haiku 5.5 est le premier modèle de la série Haiku à offrir un effort ajustable. Ce réglage fait que le choix du modèle n’est plus le seul interrupteur de coût : le système peut aussi, dans le même modèle, ajuster l’effort de raisonnement.
On peut le voir comme les modes de conduite d’une voiture :
- Pour une classification simple et une conversion de format, utiliser un effort plus bas, en privilégiant la vitesse et le faible coût.
- Pour l’extraction structurée et la compression de longs textes, utiliser un effort moyen, en équilibrant qualité et dépense.
- Pour les tâches qui demandent un jugement en plusieurs étapes, augmenter l’effort.
- Si la tâche échoue encore, passer alors à Sonnet ou à Opus.
Cela donne une nouvelle formule de décision :
Effet final = modèle × effort × contexte × outils × stratégie de nouvelle tentative
Désormais, comparer des modèles ne consiste plus seulement à demander « qui est le plus fort, Haiku 5.5 ou Sonnet 5.5 ? ». Il faut aussi demander :
- Sur la même tâche, quel palier d’effort est le plus rentable ?
- Le gain de qualité apporté par un effort plus élevé couvre-t-il le coût supplémentaire ?
- Pour une tâche simple, augmenter l’effort ne fait-il qu’allonger l’attente ?
- Est-il plus rentable de laisser Haiku essayer une fois de plus, ou d’appeler Sonnet une seule fois ?
C’est aussi pourquoi Haiku 5.5 s’évalue mieux par un coût au niveau de la tâche que par l’impression laissée par une seule sortie.
L’Agent peut passer de « un grand modèle fait tout » à une collaboration par couches
Beaucoup d’Agents avaient autrefois une structure proche de celle-ci : une fois la demande de l’utilisateur posée, un grand modèle se charge de planifier, de chercher, d’appeler les outils, de mettre en ordre les résultats et de répondre pour finir.
Demande de l’utilisateur → le grand modèle planifie → le grand modèle cherche → le grand modèle résume → le grand modèle produit la sortie
Cette structure est simple, mais elle fait utiliser le même modèle coûteux pour chaque action locale. Pour un Agent qui doit chercher des dizaines de documents, traiter des centaines d’enregistrements ou appeler un navigateur de façon répétée, le coût et la latence s’accumulent vite.
Haiku 5.5 entre plus naturellement dans une architecture en couches de ce genre :
Demande de l’utilisateur
   ↓
Sonnet ou Opus découpe la tâche et établit le plan
   ↓
Haiku 5.5 cherche, classe, extrait, résume et effectue les appels d’outil en une seule étape
   ↓
Sonnet ou Opus examine les résultats et prend la décision finale
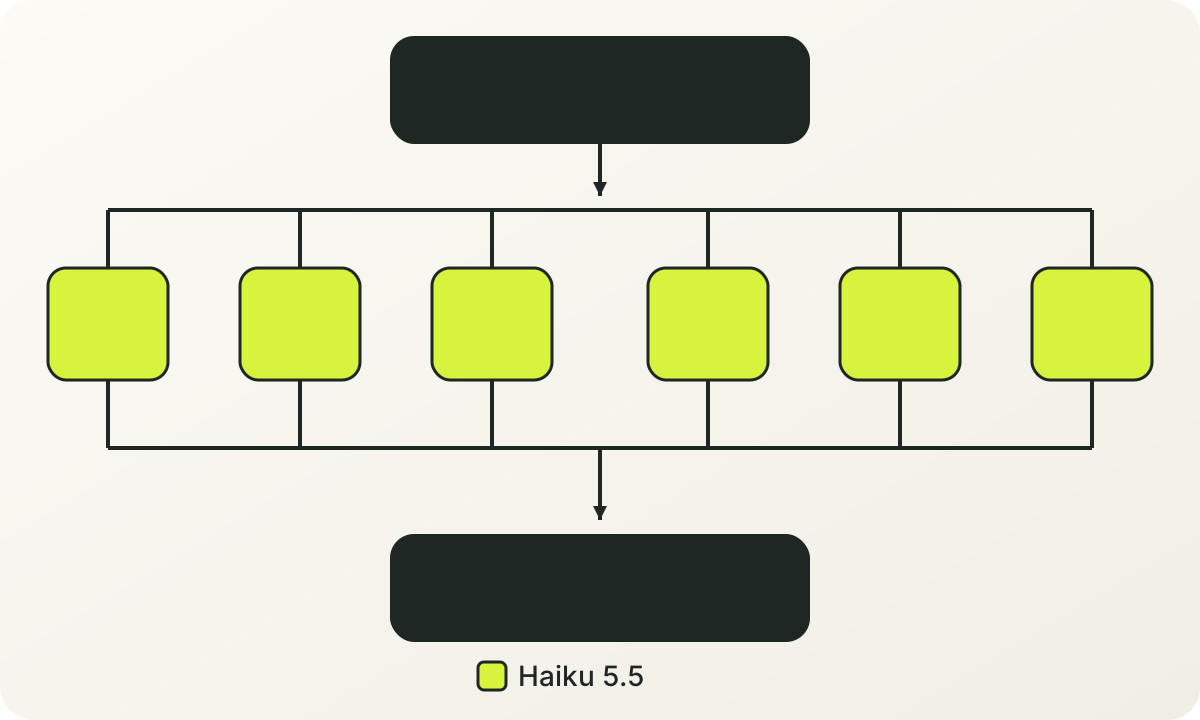
Dans cette structure, la valeur de Haiku 5.5 n’est pas d’achever seul la tâche la plus complexe, mais de devenir la « couche ouvrière » de l’Agent. Il traite le travail local le plus nombreux, relativement clair dans sa structure, et vérifiable.
Quels travaux conviennent à Haiku 5.5
- Acheminer une demande d’utilisateur vers différents flux de travail.
- Extraire des champs fixes d’un document ou de quelques documents.
- Classer des tickets et les ordonner par priorité.
- Comprimer une longue conversation dans le contexte dont le tour d’Agent suivant a besoin.
- Dédupliquer des résultats de recherche et en écrire un premier résumé.
- Effectuer une opération de navigateur explicite.
- Vérifier le format du code, générer un test simple ou expliquer un fragment local de code.
- Mener à bien un petit morceau de travail comme sous-agent de Sonnet ou d’Opus.
Quels travaux ne devraient pas aller à Haiku 5.5 par défaut
- Les projets complexes qui exigent une planification à long horizon.
- Les modifications de code qui touchent plusieurs fichiers, plusieurs dépendances et plusieurs tours de retour.
- Les décisions critiques où une seule erreur entraîne une perte élevée.
- Le travail qui doit conserver un état complexe tout au long d’un long processus.
- Les tâches sans moyen de vérification automatique, qui ne peuvent s’appuyer que sur un jugement humain.
L’essentiel n’est pas de coller au modèle l’étiquette « capable » ou « incapable », mais d’évaluer le prix d’un échec. Pour les tâches qui se vérifient automatiquement et peuvent être retentées après un échec, le rapport qualité-prix de Haiku 5.5 devient plus intéressant ; pour les tâches dont l’échec coûte cher, Sonnet ou Opus reste le choix plus sûr.
Comment un développeur ordinaire peut choisir parmi les trois modèles
On peut d’abord faire un routage simple à partir de la complexité de la tâche et du prix de l’échec :
| Caractéristique de la tâche | Choix par défaut | Condition pour monter |
|---|---|---|
| Format de sortie fixe, vérifiable automatiquement | Haiku 5.5 | Erreurs de format consécutives ou champ clé manquant |
| Fort volume d’appels, sensible à la latence | Haiku 5.5 | La latence p95 ou le taux d’échec dépasse le seuil du produit |
| Besoin de résumé, de compression, de classification, d’extraction | Haiku 5.5 | Apparition d’un raisonnement entre documents ou d’un conflit de contexte |
| Travail de connaissance ordinaire et modifications de code | Sonnet 5.5 | La tâche s’étend sur une longue durée ou demande plusieurs tours de planification |
| Agent complexe et codage à long horizon | Sonnet 5.5 ou Opus 5.5 | Tolérance aux erreurs très faible, ou besoin d’un raisonnement profond |
| Jugement à haut risque et revue finale | Sonnet 5.5 ou Opus 5.5 | Décider selon le prix de l’erreur et la capacité de vérification |
Ce tableau ne doit pas être pris pour une réponse figée à jamais. Avant une mise en production réelle, il faut mesurer sur son propre ensemble de tâches le point où chaque palier de modèle se sépare en taux de réussite, en latence et en coût de chaque tâche réussie.
100K tokens est une frontière de prix à surveiller de près
Le prix annoncé de Haiku 5.5 est très bas, mais il monte nettement après 100K tokens. Pour les applications sur de longs documents, des dépôts de code et de longues conversations, une équipe ne peut pas regarder seulement le prix de départ public du modèle.
Un flux de travail à long contexte peut se découper en quelques étapes :
- Constituer un cache à la première lecture du document.
- Utiliser Haiku 5.5 pour comprimer le contexte.
- Ne transmettre à Sonnet que les passages liés à la question en cours.
- Enregistrer les résultats intermédiaires comme état structuré.
- Éviter de renvoyer l’historique complet à chaque tour.
Ce flux a deux avantages : il réduit la probabilité de franchir la tranche de prix des 100K, et il permet à des modèles différents de porter des travaux différents.
La valeur de long contexte de Haiku 5.5 ne se mesure donc pas seulement à « combien de tokens il peut lire au maximum ». La question plus concrète est :
- Quelle quantité de contenu brut doit entrer dans le modèle ?
- Quel contenu doit être comprimé en premier ?
- Quel est le taux de succès du cache ?
- Le prix au-delà de 100K reste-t-il acceptable ?
- La perte d’information due à la compression peut-elle faire échouer les tâches suivantes ?
La sortie de Haiku 5.5 déplace aussi le centre de l’évaluation des modèles
La page officielle fournit déjà plusieurs résultats, dont GDPval-AA, OSWorld, Humanity's Last Exam et Terminal-Bench. Ils aident le lecteur à situer l’étendue approximative des capacités du modèle, mais une équipe produit a toujours besoin de ses propres tests de tâches.
Dans un système réel, ce qui mérite le plus d’être observé n’est pas le score isolé d’un modèle sur un banc d’essai, mais le groupe d’indicateurs suivant :
- Taux de réussite des tâches.
- Qualité de la sortie.
- Latence p50 et p95.
- Nombre de tokens d’entrée et de sortie.
- Taux de nouvelles tentatives.
- Taux d’erreur des appels d’outils.
- Taux de fallback.
- Taux de reprise humaine.
- Coût de chaque tâche réussie.
Il faut surtout prêter attention à la stabilité des exécutions répétées. Une belle réponse à un même Prompt montre seulement que cette exécution a réussi ; elle ne montre pas directement que le modèle accomplira de façon stable les tâches du même type en production.
Une façon de tester plus fiable consiste à :
- Préparer, pour chaque type de tâche, un ensemble d’échantillons indépendants.
- Les exécuter avec le même prompt système, le même contexte, les mêmes définitions d’outils et la même région.
- Répéter chaque échantillon plusieurs fois.
- Juger les résultats par des règles, des tests cachés ou une évaluation humaine en aveugle.
- Rapporter le taux de réussite et l’intervalle de confiance.
- Lister à part les pires cas et les types d’échec.
Cette méthode finit par faire passer l’évaluation des modèles de « quelle sortie était la meilleure » à « ce système peut-il continuer d’accomplir le travail ».
Ce que Haiku 5.5 signifie pour un utilisateur individuel
Un utilisateur individuel ne ressent pas forcément directement le changement de prix unitaire de l’API, mais il peut situer Haiku 5.5 sous trois angles.
Premièrement, il convient mieux aux tâches rapides, répétées et aux frontières nettes, par exemple mettre un texte en ordre, extraire de l’information, produire un brouillon structuré et traiter un grand nombre de petites questions.
Deuxièmement, il ne convient pas forcément comme remplacement de tous les modèles avancés. L’écriture complexe, la planification à long horizon, le code difficile et le travail qui doit garder un état de façon continue dépendent encore davantage de Sonnet ou d’Opus.
Troisièmement, les écarts entre modèles ressemblent de plus en plus à des différences de manière de travailler, et non à un simple écart de niveau. Pour choisir un modèle, il faut d’abord regarder la fréquence de la tâche, l’exigence de latence, le prix d’une erreur et les moyens de vérification, puis la capacité d’un appel isolé.
Pour une équipe produit, ce qu’il faut vraiment recalculer est l’économie de l’unité de tâche
Haiku 5.5 rend plus faciles à essayer beaucoup d’étapes qui, autrefois, ne valaient pas la peine d’être automatisées :
- Une couche de plus pour classer les entrées.
- Un tour de plus pour comprimer les résultats de recherche.
- Un sous-agent de plus, chargé des documents.
- Une vérification de sortie à bas coût de plus.
- Une vérification structurée de plus avant la réponse finale.
Ces étapes ajoutées augmentent en elles-mêmes le nombre d’appels, mais si elles abaissent le taux d’échec final, le coût global du produit peut au contraire baisser.
C’est aussi la raison pour laquelle le prix d’un seul appel de modèle ne suffit pas. Ce qu’une équipe produit doit vraiment comparer, c’est :
Coût d’un seul appel
→ coût total d’une tâche
→ coût total d’une tâche réussie
→ coût total d’un résultat livrable
Quand Haiku 5.5 est assez bon marché, le système peut avoir les moyens d’échanger plusieurs petites tâches contre une fiabilité finale plus élevée. Ce changement agit sur la conception des Agents, sur la structure de profit du produit, et sur les travaux que l’équipe décide de confier à un modèle pour une exécution automatique.
Conclusion : Haiku 5.5 est un changement d’architecture
La sortie de Haiku 5.5 peut se comprendre comme une mise à niveau de petit modèle, et aussi comme une avancée d’Anthropic sur la forme du produit modèle.
Elle place trois questions sur la même table de décision :
- De combien d’intelligence cette tâche a-t-elle besoin ?
- Combien de latence cette tâche peut-elle supporter ?
- Combien d’argent cette tâche mérite-t-elle ?
Quand le choix du modèle est réuni avec le routage des tâches, l’effort, le cache, les nouvelles tentatives et la reprise humaine, « quel modèle est le plus fort » n’est plus la seule question. La question plus importante devient :
Quel modèle doit traiter quel appel, et comment obtenir un résultat assez fiable au coût de bout en bout le plus bas ?
Le sens de Haiku 5.5 est peut-être qu’il rend cette question, pour la première fois, assez bon marché pour qu’elle vaille d’être posée à grande échelle.