DeepSeek V4.1 Flash en profondeur : architecture, prix Modelflare et rivaux
Une analyse appuyée sur les sources de DeepSeek V4.1 Flash : son architecture, le contexte 1M, la sortie 384K, les benchmarks d'Agent, les limites d'API, les comparaisons avec OpenAI et Anthropic, puis la disponibilité et les prix actuels sur Modelflare.
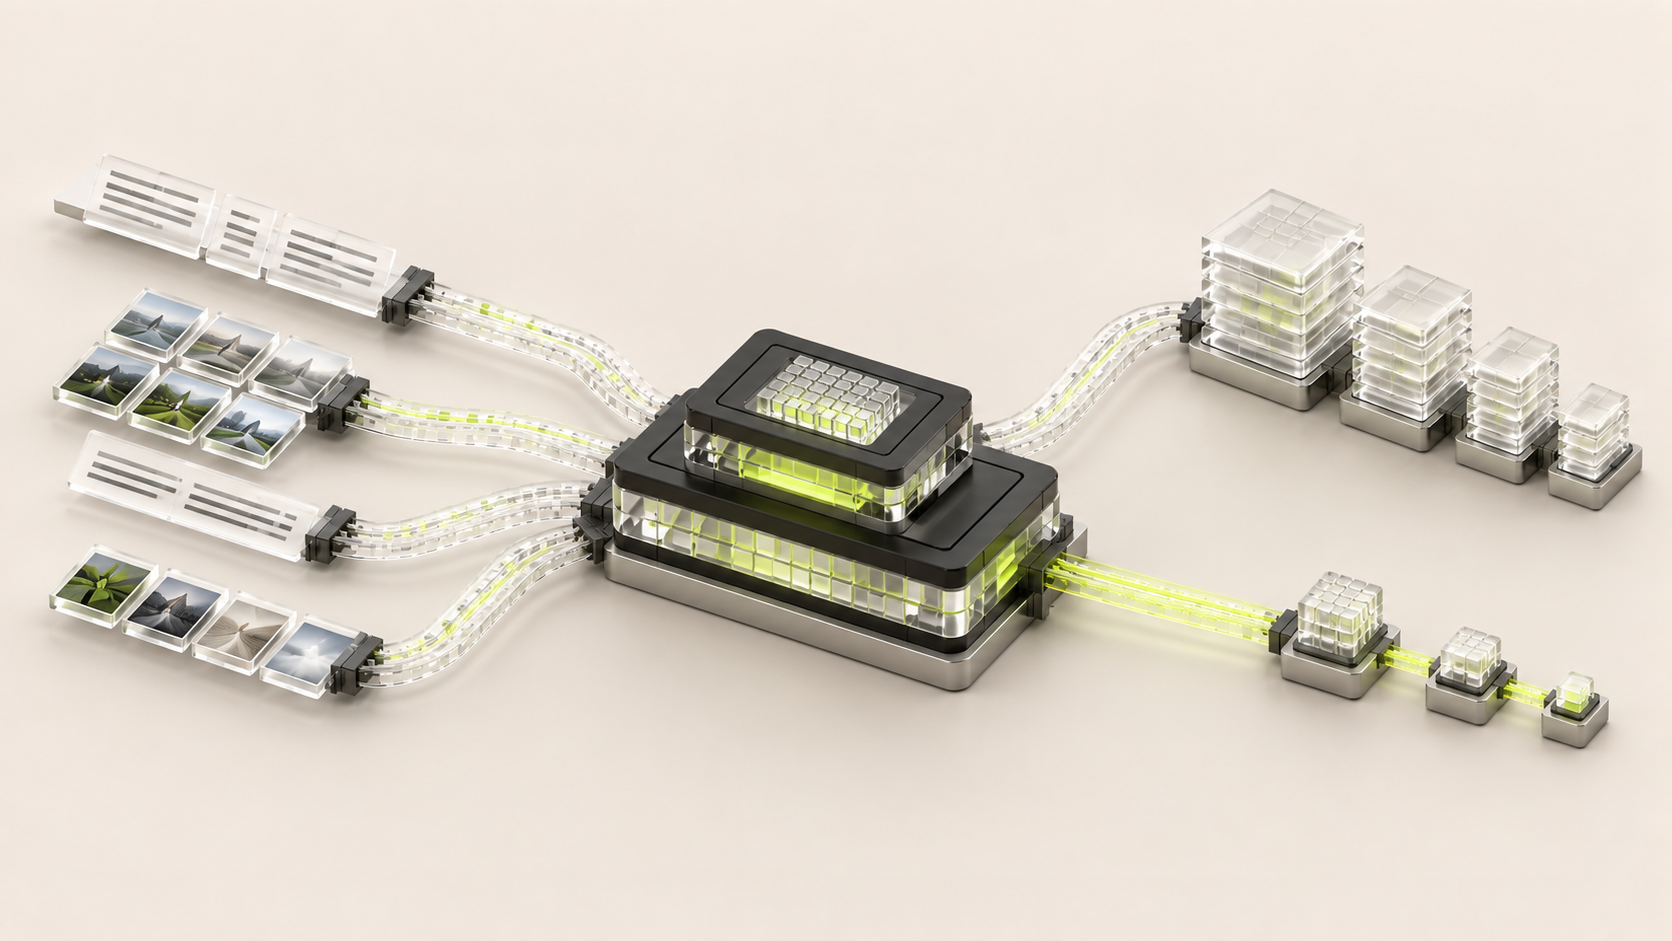
DeepSeek V4.1 Flash est un modèle multimodal à poids ouverts et à bas coût, construit pour de longues boucles d'Agent. Sorti le 10 septembre 2026, il réunit une fenêtre de contexte d'un million de tokens, jusqu'à 384K tokens de sortie, une API officielle inhabituellement bon marché, et une architecture qui réduit le traitement du prompt et la pression sur le cache KV. Son avantage le plus net n'est pas de gagner chaque benchmark. C'est la quantité de travail d'Agent en long contexte qu'il peut tenter par dollar, tout en restant compétitif sur les évaluations de code, de terminal, d'automatisation et d'usage d'outils.
Cette conclusion a besoin de bornes. Les nombres de benchmark ci-dessous ont été publiés par DeepSeek, et non reproduits indépendamment par Modelflare. Le propre rapport de DeepSeek dit que le modèle est encore derrière les plus grands systèmes fermés sur le raisonnement le plus dur et les cas limites. L'ID de modèle correct de l'API de première main est deepseek-flash. DeepSeek V4.1 Flash est maintenant en ligne sur Modelflare sous l'ID de modèle versionné deepseek-v4.1-flash-0910, avec Chat Completions et Responses dans le groupe public deepseek-stable.
Dernière vérification : 2026-09-10 UTC. Les prix, les alias et l'état du catalogue peuvent changer.
La réponse directe : ce qu'est DeepSeek V4.1 Flash
L'avis de sortie de DeepSeek définit DeepSeek V4.1 Flash comme le remplacement de production de la ligne Flash antérieure. Le point d'accès officiel accepte deepseek-flash. Les noms hérités deepseek-v4-flash et deepseek-v4-flash-vision-exp sont temporairement acceptés par DeepSeek et routés vers V4.1 Flash aux tarifs Flash. À partir du 14 septembre 2026 à 04:00 UTC, DeepSeek dit que les requêtes pour deepseek-v4-pro seront aussi routées vers V4.1 Flash jusqu'à une sortie ultérieure de V4.1 Pro.
Cette politique de migration appartient à l'API propre de DeepSeek. Modelflare utilise l'ID explicitement marqué par la sortie deepseek-v4.1-flash-0910, plutôt que de rebaptiser en silence l'entrée antérieure deepseek-v4-flash. L'opérateur de Modelflare a confirmé le lancement, et le modèle est apparu dans les catalogues de prix public et d'origine à 2026-09-10 15:21 UTC. Les clients devraient utiliser l'ID exact montré par leur fournisseur, au lieu de supposer qu'un alias de première main fonctionne inchangé à travers chaque passerelle.
L'identité pratique du modèle a cinq parties : entrée multimodale image et texte ; sortie texte ; un tronc MoE de 552B paramètres ; une mémoire Engram supplémentaire de 196B paramètres ; et une activation asymétrique de 8B paramètres par token de prompt contre 16B par token décodé. Le dernier point est central : les charges d'Agent lourdes en entrée devraient dépenser moins de calcul pendant le préremplissage répété qu'un dessin decoder-only symétrique d'échelle semblable.
Les spécifications d'un coup d'œil
Les valeurs suivantes viennent de la sortie officielle, de la fiche du modèle et du rapport technique. « Paramètres du tronc » et « paramètres Engram » décrivent des stockages différents ; aucun des deux nombres n'égale le calcul actif par token.
| Élément | DeepSeek V4.1 Flash |
|---|---|
| ID d'API officiel | deepseek-flash |
| ID de modèle Modelflare | deepseek-v4.1-flash-0910 |
| Classe de modèle | Transformer multimodal Mixture-of-Experts |
| Entrée / sortie | Texte et images en entrée ; texte en sortie |
| Disposition du Transformer | 40 couches : encodeur causal de 20 couches + décodeur de 20 couches |
| Stockages de paramètres | tronc 552B + mémoire conditionnelle Engram 196B |
| Paramètres actifs | 8B par token de préremplissage ; 16B par token de décodage |
| Contexte / sortie maximale | 1M / 384K tokens |
| Préentraînement | 45T tokens de corpus multimodal ; ratio 7:1 des tokens seulement texte vers multimodal |
| Conception principale attention/cache | CED + CSA2 + KV global FP4 ; KV local SWA en FP8 |
| Empreinte du KV global | 890 octets par token, rapportée par DeepSeek |
| Préréglages publics de raisonnement | low = 50, high = 75, max = 100 sur l'échelle interne d'effort |
| Limite de concurrence de l'API officielle | 2,500 requêtes concurrentes |
| Licence | licence de checkpoint MIT |
Le plafond de sortie de 384K est le triple du maximum de 128K publié pour les modèles de comparaison OpenAI et Anthropic actuels dans cet article. C'est une limite, pas une recommandation : une sortie très longue augmente la latence, le coût et la surface de dérive. Pour les Agents longs, la question plus utile est de savoir si le modèle peut retenir les exigences et passer de vrais contrôles d'acceptation après les appels d'outils.
Pourquoi l'architecture est faite pour de longues boucles d'Agent
Un Agent qui utilise des outils ajoute sans cesse des observations, des résultats de commandes et des modifications à son historique. Chaque nouveau tour peut exiger un préremplissage du prompt, de l'attention sur un contexte qui grandit, un stockage KV et une nouvelle sortie. DeepSeek V4.1 Flash attaque chaque coût séparément, plutôt que de s'appuyer sur un seul modèle plus petit.
| Coût d'Agent | Mécanisme V4.1 Flash | Effet visé |
|---|---|---|
| Retraiter de longs prompts | Causal Encoder-Decoder (CED) | Réduit presque de moitié, dans l'analyse de DeepSeek, le travail asymptotique de préremplissage des longues séquences |
| Garder l'historique global en HBM | Réutilisation inter-couches CSA2 + FP4 | Réduit les entrées KV globales dupliquées et les octets par entrée |
| Persister l'état d'attention local | SWA Bounded Replay | Reconstruit une fenêtre locale bornée au lieu de stocker le cache local complet de chaque couche |
| Rappeler des motifs de tokens stables | Engram | Déplace la mémoire conditionnelle de n-grammes vers des tables à accès épars |
| Produire des tokens | Décodage spéculatif DSpark | Ébauche plusieurs positions candidates et choisit une longueur de vérification selon la confiance et la charge du système |
| Traiter les images | DeepSeek-ViT + projecteur | Convertit les entrées visuelles en plongements traités avec le texte dès le préentraînement |
Ces mécanismes améliorent surtout l'économie de service et le débit. Ils ne prouvent pas à eux seuls un meilleur raisonnement. La qualité du modèle dépend aussi des données, du post-entraînement, du harnais d'Agent et de la quantité d'effort d'inférence achetée.
CED : couper le traitement du prompt avant de toucher au cache
Le rapport technique partage 40 couches Transformer en un encodeur causal de 20 couches et un décodeur de 20 couches. Les deux premières couches n'utilisent qu'une fenêtre glissante de 128 tokens. Les couches restantes combinent une attention locale à fenêtre glissante et un contexte global compressé.
Pour l'attention globale, le décodeur ne construit pas un historique KV complet et indépendant à chaque couche. Ses clés et valeurs globales sont projetées depuis l'état caché final de l'encodeur. Les états de fenêtre glissante locale restent propres à chaque couche. DeepSeek estime la complexité de préremplissage des longues séquences à environ la moitié du chemin correspondant sur toutes les couches : le terme dominant passe du traitement de chaque token à travers toutes les couches L au traitement du contexte global à travers environ L/2, plus un travail de fenêtre locale borné.
Cela explique le partage d'activation 8B/16B. Les tokens de prompt activent environ 8B paramètres de tronc pendant le préremplissage ; les tokens nouvellement générés activent environ 16B pendant le décodage. Les charges avec d'énormes documents et de courtes réponses y gagnent plus que les charges dominées par des centaines de milliers de tokens générés. CED réduit la première moitié de cette facture ; il ne rend pas le décodage gratuit.
CSA2, FP4 et SWA Bounded Replay : l'histoire de la mémoire
Compressed Sparse Attention 2 compresse le cache le long des dimensions de séquence, de couche et de précision. Chaque couche CSA2 est assignée statiquement à l'un de trois modes. Full calcule le KV principal, les clés d'indexeur et des positions Top-K fraîches. Reindex réutilise le KV principal et les clés d'indexeur, mais les reparcourt avec sa propre requête. Reuse réutilise à la fois le KV partagé et une sélection éparse précédente. Chaque couche a encore sa propre requête et son KV de fenêtre glissante locale.
La première couche Full du décodeur sélectionne les entrées Top-512 et construit un bassin de candidats ; les couches Reindex suivantes choisissent leurs positions Top-512 dans ce bassin réduit. Le KV global principal utilise une représentation E2M1 d'environ quatre bits, avec une échelle E4M3 par 16 canaux. DeepSeek garde le FP8 pour le cache SWA local, plus sensible à la quantification.
| Couche de cache | Précision / durée de vie | Résultat rapporté | Ce que cela ne garantit pas |
|---|---|---|---|
| KV global d'exécution | FP4, résident en HBM | 890 octets/token ; environ 1/4 de V4 Flash et 437× plus petit que V1 | Une sélection éparse parfaite sur chaque cas limite |
| KV SWA local d'exécution | FP8 | Préserve la fenêtre locale de 128 tokens, propre à la couche | Une mémoire négligeable à une concurrence arbitraire |
| KV global persistant | Mémoire hôte ou SSD dans le dessin de déploiement de DeepSeek | Un état global réutilisable et de longue durée | Une durée de rétention fixe sur l'API publique |
| État SWA local persistant | Reconstruit avec Bounded Replay | Environ 1/8 de l'empreinte totale de cache persistant de V4 Flash, à longueur de séquence égale | La relecture exacte de chaque état local écarté |
Le rapport dit que son déploiement garde le KV persistant global au moins 72 heures et utilise un bassin SWA distribué de courte durée. Le guide public du cache de contexte décrit la création du cache comme automatique et au mieux, dit que la construction peut prendre des secondes, et dit que les entrées sont en général effacées après des heures ou des jours. Les clients de production devraient traiter le contrat public comme faisant autorité : inspecter les champs de tokens touchés et manqués, au lieu de budgéter autour d'un succès garanti de 72 heures.
DeepSeek identifie lui-même deux bornes de robustesse : CSA2 peut sélectionner les mauvaises positions éparses, et Bounded Replay approxime l'état local écarté. Ses tests n'ont pas trouvé de dégradation systématique dans les réglages évalués, mais les contextes extrêmes et les bornes de reprise de cache restent des zones pour des tests de charge supplémentaires.
Engram, DSpark et le chemin multimodal
Engram sépare une part de mémorisation du calcul dense du modèle. V4.1 Flash alloue 196B paramètres sur deux modules de mémoire conditionnelle, aux couches indexées à partir de zéro 1 et 14. Chacun utilise des n-grammes de tokens de longueurs deux, trois et quatre, huit têtes de hachage, un portillonnage conscient du contexte et une prélecture en mémoire hôte sur RDMA. Ce sont des paramètres stockés, pas 196B paramètres de plus activés pour chaque token.
DSpark est un décodeur spéculatif entraîné à part. Trois blocs Transformer regardent à travers une fenêtre glissante de 128 tokens et proposent cinq positions en parallèle. Une tête de dépendance légère relie les tokens d'ébauche ; une tête de confiance estime quelle part de l'ébauche survivra à la vérification. L'ordonnanceur utilise ces probabilités et le débit mesuré du moteur pour choisir une longueur de vérification sous la charge actuelle. Cela peut améliorer le débit de tokens du système sans changer le rôle de vérification finale du tronc.
Le chemin visuel utilise un DeepSeek-ViT entraîné à part, avec un encodage de position rotatif 2D. Un pas de pixel-unshuffle 3×3 réduit par neuf le nombre de tokens visuels avant la projection dans le modèle de langage. L'encodeur de vision a 32 couches, une taille cachée de 1,024 et 16 têtes d'attention dans la configuration rapportée. Son étape d'entraînement autorégressif utilise des images mises à l'échelle entre 544×544 et 1,344×1,344, après une étape contrastive antérieure sur environ 47B paires image-texte.
Entraînement et post-entraînement
DeepSeek rapporte 45T tokens de préentraînement, avec des données multimodales intégrées à l'entraînement du modèle de langage. Les pipelines seulement texte et multimodal sont fusionnés à un ratio de tokens 7:1 après remplacement des chevauchements et déduplication. L'attention éparse est entraînée depuis zéro à une longueur de séquence de 64K, sans échauffement en attention dense ; le contexte s'étend à 1M au point des 34T tokens.
| Étape | Détail publié | Pourquoi cela compte |
|---|---|---|
| Préentraînement contrastif de vision | Environ 47B paires image-texte, phase basse résolution | Apprend de larges représentations visuelles avant l'intégration au langage |
| Réglage autorégressif de vision | 236B tokens avec légendes, graphiques, OCR et données liées | Ajoute une compréhension visuelle et documentaire à grain fin |
| Préentraînement du LLM | 45T tokens ; données multimodales incluses dès le départ | Évite de traiter la vision seulement comme un adaptateur de prompt tardif |
| Entraînement du contexte | Attention éparse depuis 64K ; étendue à 1M à 34T tokens | Entraîne le motif d'attention déployé, plutôt que de ne le convertir qu'après l'entraînement |
| Post-entraînement | SFT, apprentissage par renforcement et distillation on-policy | Aligne le raisonnement, les outils et le comportement d'Agent |
Le rapport ne revendique pas un nouvel algorithme de post-entraînement. Il attribue les gains à la création de tâches et d'environnements synthétiques, à un meilleur filtrage des données, à des récompenses vérifiables et à l'échelle de l'architecture et des données. Cela compte quand on compare des affirmations d'« architecture de modèle » : CED et CSA2 expliquent l'efficacité, tandis que la performance d'Agent observée est le produit de toute la pile d'entraînement et d'échafaudage.
Effort de raisonnement : la qualité a une facture de tokens visible
DeepSeek expose un continuum d'effort interne de 1 à 100 et mappe les préréglages publics de l'API low, high et max vers 50, 75 et 100. Les entrées de compatibilité mappent minimal et low vers low ; medium, high et xhigh vers high ; et max ou ultra vers max. La réflexion est par défaut à high.
Dans le balayage rapporté par DeepSeek, monter l'effort de 25 à 100 a fait passer le résultat moyen sur huit évaluations de raisonnement de 67.1% à 76.3%, DeepSWE de 66.0% à 74.2%, et Terminal-Bench 2.1 de 82.4% à 90.6%. Les tokens de sortie ont grandi d'environ 2.5×. L'intervalle 60–80 a capté l'essentiel de la qualité à moins de la moitié du budget maximal de tokens ; le dernier passage à 100 a allongé les trajectoires d'Agent de 1.6–1.8× pour des gains plus petits.
C'est l'un des contrôles les plus utiles du modèle. Utilisez low pour la classification, l'extraction et l'exploration réessayable ; high pour le code et la recherche ordinaires ; réservez max aux tâches où un autre essai, ou un cas limite manqué, coûte plus que les tokens en plus. Traitez cela comme des hypothèses de départ et mesurez le coût par tâche acceptée.
En mode de réflexion, la température et les pénalités de présence et de fréquence sont ignorées, et top_p a un minimum de 0.95. Avec des outils, les clients doivent renvoyer le reasoning_content complet du message assistant en même temps que les résultats d'outils ; l'omettre provoque une réponse 400. Cette règle d'état compte plus que de copier un jeu familier de paramètres OpenAI.
Comparaison de benchmarks avec OpenAI et Anthropic
Ce tableau reproduit des résultats choisis du tableau 3 du rapport technique de DeepSeek. Tous les modèles sont montrés au réglage Max du rapport. DeepSeek a utilisé des échafaudages exigés ou officiels différents pour certaines évaluations, un contexte DeepSeek Harness de 1M pour le code, et un contexte Claude Code de 512K pour les tâches d'Agent visuel. Les nombres sont des preuves rapportées par le fournisseur, pas un face-à-face indépendant et pas un SLA de production.
| Évaluation | V4 Flash | V4 Pro | V4.1 Flash | GPT-5.6 Sol | Claude Opus 5 |
|---|---|---|---|---|---|
| GPQA Diamond, Pass@1 | 89.9 | 92.4 | 90.9 | 94.1 | 93.4 |
| Terminal-Bench 2.1, Pass@1 | 82.7 | 87.9 | 90.6 | 88.8 | 89.1 |
| Terminal-Bench 3.0, Pass@1 | 7.6 | 11.8 | 30.0 | 34.4 | 43.3 |
| Terminal-Bench 4.0, Pass@1 | 7.0 | 12.4 | 31.2 | 39.9 | 51.8 |
| DeepSWE v1.1, resolved | 54.4 | 62.7 | 74.2 | 73.0 | 74.0 |
| CyberGym, Pass@1 | 76.7 | 83.3 | 88.1 | 84.5 | — |
| HLE with tools, Pass@1 | 51.5 | 60.0 | 63.9 | — | 63.6 |
| AutomationBench, Pass@1 | 37.7 | 43.2 | 54.8 | 45.8 | 50.3 |
| Agents' Last Exam, Pass@1 | 25.2 | 25.7 | 31.8 | 26.7 | 28.6 |
| Chartography with tools, Pass@1 | — | — | 78.9 | 79.9 | 84.0 |
La lecture la plus solide est précise. V4.1 Flash fait un grand pas par rapport à V4 Flash sur les tâches d'Agent et reste compétitif avec GPT-5.6 Sol et Claude Opus 5 sur DeepSWE, Terminal-Bench 2.1, l'automatisation et HLE avec outils. Il ne mène pas GPQA, les versions ultérieures de Terminal-Bench, ni Chartography. Le rapport lui-même avertit qu'une quasi-parité sur les tâches courantes ne veut pas dire une parité de frontière sur le raisonnement le plus dur et les cas limites.
GPT-6 Astra et Claude Fable 5.1 sont absents de ce tableau de scores parce que le rapport DeepSeek ne publie pas pour eux les mêmes données de comparaison ligne par ligne. Ajouter des scores tirés de pages de fournisseurs séparées créerait un harnais commun faux. Les équipes devraient évaluer tous les candidats sur les mêmes tâches de dépôt, les mêmes outils, les mêmes délais, la même politique réseau et les mêmes contrôles d'acceptation.
La compatibilité d'API est large, mais pas identique
Le service officiel expose OpenAI Chat Completions, OpenAI Responses et une API compatible Anthropic. Cette largeur baisse le travail de migration, mais la compatibilité décrit la forme de la requête plutôt que des sémantiques de cycle de vie identiques.
| Surface | Comportement de DeepSeek V4.1 Flash | Conséquence pour la migration |
|---|---|---|
| Chat Completions | Flux, sortie JSON, appels de fonctions ; préfixe/FIM en mode sans réflexion | Les clients OpenAI existants sont le point de départ le plus simple |
| Responses | Sans état ; fonctions et images prises en charge | Persistez vous-même la conversation entière |
| Champs d'état Responses | previous_response_id, conversations, store, background et context management ne sont pas pris en charge ou sont ignorés |
Une réponse 200 ne prouve pas que ces fonctions ont pris effet |
| Outils hébergés | Web search, file search, code interpreter, computer use et les outils intégrés MCP sont ignorés ; la prise en charge des outils personnalisés est limitée | Exécutez les outils dans l'application et testez chaque champ demandé |
| Résumés de raisonnement | Le résumé et le contenu de raisonnement chiffré ne sont pas pris en charge | Ne dépendez pas des champs de passation de raisonnement à la façon d'OpenAI |
| Format Anthropic | La forme de message Anthropic est acceptée | Conservez les règles de raisonnement et d'état d'outil de DeepSeek plutôt que de supposer la sémantique de Claude |
| Vision | Les images sont acceptées dans l'entrée utilisateur et dans les sorties d'outils | Validez la taille de la charge, le mode de détail et le nombre d'images |
Le guide Responses de DeepSeek liste aussi des champs ignorés tels que metadata, prompt templates, truncation, service tier, safety identifier, prompt-cache key/retention et stream options. L'ignorance silencieuse est un risque de compatibilité : l'acceptation du schéma peut cacher un comportement manquant. Construisez une requête de conformité pour chaque fonction dont votre application dépend. Le guide de l'API compatible OpenAI explique pourquoi la forme du point d'accès et la capacité ont besoin de contrôles séparés.
Les modèles actuels d'OpenAI offrent un écosystème d'outils Responses natif plus large et des fonctions d'état géré. L'API native d'Anthropic a son propre contrat mûr de bloc de réflexion et d'usage d'outils. L'avantage de DeepSeek, c'est qu'un seul modèle accepte les trois dialectes courants ; son coût, c'est que l'intersection est plus petite que la surface native complète de l'un ou l'autre rival.
Limites de vision et économie des images
Le guide officiel de la vision prend en charge JPEG, PNG, GIF et WebP par base64, par URL externes ou par la Files API. Les images sont redimensionnées automatiquement vers environ 1,300×1,300 et utilisent au plus 1,024 tokens d'entrée chacune. Le détail low utilise une vue 512×512 ; high et original gardent plus de détail ; auto se comporte actuellement comme original.
| Limite | Valeur officielle |
|---|---|
| Corps de la requête | 48 MiB |
| Image en ligne ou récupérée à l'extérieur | 32 MiB chacune |
| Image référencée par ID de fichier | 64 MiB chacune |
| Images par requête | 600 |
| Octets d'image combinés | 64 MiB sans ID de fichier ; 200 MiB avec des ID de fichier |
| Grand côté | 8,192 px ; 4,096 px quand on envoie 15 images ou plus |
| Plafond de tokens visuels | 1,024 tokens par image après traitement |
Au maximum de 1,024 tokens visuels, une image non mise en cache contribue environ $0.0001536 hors pointe ou $0.0003072 en pointe aux tarifs d'entrée publiés, avant le texte d'accompagnement et la sortie. Cette arithmétique est utile pour des estimations d'échelle, mais le redimensionnement des images, le comportement du cache et l'usage réel de tokens visuels peuvent changer la facture. Plus d'images consomment aussi du contexte qui pourrait autrement tenir du texte ou un historique d'outils.
V4.1 Flash convient aux captures de documents, aux graphiques, à l'OCR et aux observations d'Agent visuel. Ce n'est pas un modèle de génération d'images. Pour des images générées, utilisez un modèle et un point d'accès conçus pour renvoyer des pixels plutôt que du texte.
Prix de l'API officielle, comparés
La page de prix DeepSeek a introduit les tarifs suivants à 04:00 UTC le 10 septembre. Les fenêtres de pointe en semaine sont 01:00–04:00 et 06:00–10:00 UTC ; tous les autres horaires de semaine et le week-end utilisent les tarifs hors pointe. Le cache de contexte de DeepSeek est automatique, donc « entrée en cache » veut dire un succès de cache rapporté, pas un drapeau de cache qui en forcerait un.
Les tarifs OpenAI viennent de sa comparaison actuelle des modèles ; les tarifs Anthropic viennent de sa page de prix. Les valeurs sont en USD par million de tokens. Anthropic facture aussi les écritures de cache ; elles sont omises ici parce que le tableau ne compare que l'entrée nouvelle, les lectures de cache et la sortie.
| Modèle | Contexte / sortie max | Entrée nouvelle ou manquée | Entrée en cache/lue | Sortie |
|---|---|---|---|---|
| DeepSeek V4.1 Flash, hors pointe | 1M / 384K | $0.15 | $0.003 | $0.60 |
| DeepSeek V4.1 Flash, pointe | 1M / 384K | $0.30 | $0.006 | $1.20 |
| DeepSeek V4.1 Flash sur Modelflare | limite du modèle 1M / 384K | $0.193548 | $0.003871 | $0.774194 |
| GPT-5.6 Luna | 1.05M / 128K | $0.20 | $0.02 | $1.20 |
| GPT-5.6 Terra | 1.05M / 128K | $2.00 | $0.20 | $12.00 |
| GPT-5.6 Sol | 1.05M / 128K | $4.00 | $0.40 | $20.00 |
| GPT-6 Astra | 1.05M / 128K | $10.00 | $1.00 | $50.00 |
| Claude Sonnet 5 | 1M / 128K | $2.00 | $0.20 | $10.00 |
| Claude Opus 5 | 1M / 128K | $5.00 | $0.50 | $25.00 |
| Claude Fable 5.1 | 1M / 128K | $10.00 | $0.25 | $50.00 |
Le prix n'est pas la valeur en soi. Des tokenizers différents peuvent facturer des comptes de tokens différents pour le même texte ; Anthropic note qu'une tokenisation plus récente peut produire environ 30% de tokens en plus sur certaines charges. Les modèles peuvent aussi exiger des longueurs de sortie, des essais et des réparations humaines différents. Comparez le coût par tâche acceptée, pas seulement la ligne au plus petit nombre d'entrée.
Le catalogue public actuel de Modelflare expose un tarif entre les deux bandes horaires de DeepSeek : il est d'environ 64.5% du tarif de pointe de première main, soit 35.5% plus bas pendant les fenêtres de pointe, tandis qu'il est d'environ 29.0% au-dessus du tarif hors pointe de DeepSeek. Le tarif de passerelle listé n'a donc aujourd'hui aucun ajustement de bande horaire ; les charges souples qui peuvent utiliser de façon fiable la fenêtre hors pointe de DeepSeek peuvent encore payer moins par l'API de première main.
OpenAI applique des tarifs plus hauts quand le contexte d'entrée dépasse 272K : toute la requête utilise 2× les prix d'entrée et d'entrée en cache et 1.5× les prix de sortie. Cette borne compte dans le scénario de long contexte ci-dessous. DeepSeek utilise des fenêtres de temps à la place ; les modèles à un million de tokens listés par Anthropic n'utilisent pas la même borne de 272K dans le tableau de prix cité.
Deux scénarios de coût reproductibles
Le scénario A est une requête avec 100K d'entrée non mise en cache et 10K de sortie. La formule est 0.1 × input rate + 0.01 × output rate. Elle suppose qu'il n'y a pas d'entrée en cache, d'outils, d'essais, de taxes ni de suppléments propres au fournisseur.
| Modèle | Coût du scénario A |
|---|---|
| DeepSeek V4.1 Flash, hors pointe | $0.021 |
| DeepSeek V4.1 Flash sur Modelflare | $0.0271 |
| GPT-5.6 Luna | $0.032 |
| DeepSeek V4.1 Flash, pointe | $0.042 |
| Claude Sonnet 5 | $0.300 |
| GPT-5.6 Terra | $0.320 |
| GPT-5.6 Sol | $0.600 |
| Claude Opus 5 | $0.750 |
| GPT-6 Astra / Claude Fable 5.1 | $1.500 |
Le scénario B est le coût marginal d'une requête à cache chaud avec 900K d'entrée en cache, 100K d'entrée nouvelle et 20K de sortie. Il exclut à dessein la requête antérieure qui a établi le cache. Formule : 0.9 × cache-read rate + 0.1 × input rate + 0.02 × output rate. Les modificateurs de long contexte d'OpenAI, appliqués à toute la requête, le sont parce que le contexte d'entrée totalise un million de tokens.
| Modèle | Coût marginal du scénario B |
|---|---|
| DeepSeek V4.1 Flash, hors pointe | $0.0297 |
| DeepSeek V4.1 Flash sur Modelflare | $0.0383 |
| DeepSeek V4.1 Flash, pointe | $0.0594 |
| GPT-5.6 Luna | $0.1120 |
| Claude Sonnet 5 | $0.5800 |
| GPT-5.6 Terra | $1.1200 |
| Claude Opus 5 | $1.4500 |
| GPT-5.6 Sol | $2.1200 |
| Claude Fable 5.1 | $2.2250 |
| GPT-6 Astra | $5.3000 |
La comparaison tient les quantités de tokens égales ; elle ne prétend pas une qualité égale. Le cache de DeepSeek est au mieux, tandis que la création de cache chez Anthropic a son propre prix d'écriture et sa propre durée de vie. Un test de charge équitable enregistre les tokens de succès et d'échec de cache, toutes les tentatives, la sortie totale y compris le raisonnement facturable, le temps écoulé, le taux d'acceptation et les minutes de correction humaine. Le guide de suivi des coûts fournit le cadre de comptabilité.
Les poids ouverts ne rendent pas l'auto-hébergement petit
La sortie Hugging Face est sous licence MIT et documente des chemins de service vLLM et SGLang. Dans l'instantané vérifié pour cet article, le dépôt contenait 48 fragments safetensor et environ 510.3 GB de fichiers Git-LFS au commit dba1be0a40aa45a94ad051997016db3960a90277. Ce compte d'octets est un artefact de téléchargement, pas de la RAM GPU mesurée.
Le système a encore un tronc de 552B, une mémoire Engram adressée par l'hôte de 196B, un routage d'experts, des chemins de cache FP4/FP8, une prélecture RDMA et un stockage KV persistant. La sortie de DeepSeek invite les équipes qui prévoient un déploiement à grande échelle avec 2,000 GPU plus un cluster de stockage à contacter la société. Cet exemple signale l'échelle du système de service complet ; ce n'est pas un minimum énoncé pour chaque déploiement. Des déploiements de recherche plus petits peuvent utiliser la quantification ou un parallélisme différent, mais ils ne devraient pas se déduire de l'économie de l'API du fournisseur.
Les poids ouverts donnent aux équipes l'accès au checkpoint, l'inspectabilité et le contrôle de la politique de déploiement. Ils ne reproduisent pas automatiquement la fusion de kernels de DeepSeek, la hiérarchie de cache, l'ordonnancement DSpark, le batching ni la latence de l'API publique. Comparez un plan d'auto-hébergement avec le débit mesuré, la reprise après échec, la capacité inactive, la bande passante de stockage et le travail d'exploitation.
DeepSeek V4.1 Flash sur Modelflare
DeepSeek V4.1 Flash est en ligne sur Modelflare. Le lancement confirmé par l'opérateur est visible indépendamment dans le catalogue de prix public de Modelflare et dans le catalogue d'origine. À 2026-09-10 15:21 UTC, les deux exposaient le nouvel enregistrement deepseek-v4.1-flash-0910 ; la configuration de production montrait une capacité deepseek-stable activée et une route activée annonçant le même modèle.
| Élément Modelflare | Valeur en ligne |
|---|---|
| ID de modèle à envoyer | deepseek-v4.1-flash-0910 |
| Disponibilité | En ligne dans le catalogue public et dans le groupe de routage activé |
| Groupe public | deepseek-stable |
| Prix d'entrée | $0.193548 / 1M tokens |
| Prix d'entrée en cache | $0.003871 / 1M tokens |
| Prix de sortie | $0.774194 / 1M tokens |
| Types de points d'accès | /v1/chat/completions et /v1/responses |
Les prix sont dérivés du coefficient d'entrée de base $0.322580645 de l'entrée en ligne, du ratio de groupe public 0.6, du ratio de cache 0.02 et du ratio de complétion 4×. Pour les deux charges calculées ci-dessus, les coûts Modelflare sont d'environ $0.0271 et $0.0383 respectivement. Utilisez la page de prix DeepSeek V4.1 Flash en ligne pour l'ID de modèle et le tarif actuels.
Les niveaux de preuve comptent encore. Le catalogue public et la route de production activée établissent la disponibilité du produit, et l'opérateur a explicitement confirmé le lancement. À 15:30 UTC, les enregistrements de production contenaient six appels Chat Completions terminés sous l'ID de modèle neuf exact, totalisant 216 tokens de prompt et 173 tokens de complétion. Cela vérifie la distribution authentifiée de Chat Completions et la sortie facturable. C'est encore un échantillon de lancement trop petit pour mesurer la latence ou la disponibilité, et cela ne prouve pas indépendamment le comportement Responses ou multimodal par cette route. Les équipes devraient lancer leur propre petite requête d'acceptation sur le point d'accès exact avant de déplacer du travail de production.
Là où DeepSeek V4.1 Flash a un avantage réel
Le modèle a un avantage cohérent quand les longues entrées, les tours d'outils fréquents et le budget comptent tous. L'architecture réduit la pression de préremplissage et de cache ; le prix de l'API transforme ces économies en un tarif public inhabituellement bas ; le plafond de sortie de 384K laisse de la marge pour de longs correctifs ou des rapports ; et le checkpoint garde ouvert un chemin d'auto-hébergement.
| Charge | Pourquoi V4.1 Flash est un candidat solide | Quoi mesurer |
|---|---|---|
| Agents de dépôt | Résultats DeepSWE et terminal forts, rapportés par l'éditeur, à bas tarifs de tokens | Modifications acceptées, taux de tests réussis, essais et temps de réparation |
| Synthèse de recherche longue | Entrée 1M, succès de cache bon marché et sortie 384K | Justesse des citations, rétention des exigences et sortie totale |
| Agents de documents visuels | Images natives, entraînement OCR/graphiques et API d'Agent courantes | Exactitude des champs, sensibilité au recadrage et au détail, usage de tokens visuels |
| Automatisation à haut volume | Prix de pointe et hors pointe bas ; plafond de concurrence de 2,500 requêtes | Temps de file, taux de 429, échecs d'outils et coût par succès |
| Déploiement contrôlé | Checkpoint MIT et chemins vLLM/SGLang documentés | Utilisation du matériel, bande passante cache/stockage et coût d'exploitation |
L'affirmation de production la plus solide est donc une capacité d'Agent à long contexte efficace en coût, pas « le meilleur modèle dans l'ensemble ». Si le modèle termine une tâche réelle en une exécution acceptée là où un petit modèle moins cher a besoin de plusieurs réparations, V4.1 gagne sur le résultat. Si un modèle fermé de frontière empêche un échec coûteux, son prix de token plus haut peut encore être économique.
Là où OpenAI ou Anthropic reste le choix plus sûr
Choisissez un modèle OpenAI quand l'application dépend de l'écosystème Responses complet, de l'état géré, des outils hébergés, ou d'un contrat propre à OpenAI que DeepSeek ignore. GPT-5.6 Luna est un concurrent de prix particulièrement proche pour les charges plus courtes et non mises en cache ; Terra, Sol et Astra échangent des prix affichés bien plus hauts contre des paliers de capacité différents et des fonctions de plateforme natives.
Choisissez un modèle Anthropic quand le contrat natif d'outils et de réflexion de Claude, les contrôles de cache, ou la performance mesurée sur votre travail d'Agent le plus dur comptent plus que le prix affiché du token. Dans le propre tableau de DeepSeek, Claude Opus 5 mène Terminal-Bench 3/4 et Chartography ; Claude Fable 5.1 est positionné pour le travail de long horizon le plus exigeant, quoiqu'il soit nettement plus cher par token nouveau et par token de sortie.
Pour les actions critiques pour la sûreté ou coûteuses, le choix de route devrait se fonder sur des modes d'échec évalués et des bornes de permission, pas sur la marque ni sur des moyennes de benchmark. Utilisez le guide de routage pour séparer le travail réessayable, les replis et les actions à effets de bord.
Liste de contrôle de déploiement
- Utilisez
deepseek-flashpour l'API de première main et notez à part toute correspondance propre à une passerelle. - Commencez à l'effort high, puis mesurez low et max sur le même ensemble de tâches acceptées ; ne mappez pas les noms d'un fournisseur à l'autre comme un calcul égal.
- Quand des outils sont utilisés en mode de réflexion, renvoyez le
reasoning_contentcomplet exactement comme exigé. - Auditez chaque champ Responses dont vous dépendez ; les paramètres rejetés et ceux ignorés en silence ont besoin d'un traitement différent.
- Journalisez les tokens de succès et d'échec de cache, les tokens de sortie et de raisonnement, les essais, la latence et l'acceptation finale.
- Concevez l'économie du cache autour des succès observés plutôt que d'une hypothèse de rétention fixe.
- Faites respecter les limites d'octets, de nombre, de dimension et de détail des images avant d'envoyer des requêtes multimodales.
- Gardez l'autorisation côté application, l'idempotence des outils et la validation de sortie indépendantes de la qualité du modèle.
- Revérifiez le prix par fenêtre de temps, les alias de modèle et les limites de concurrence avant le lancement.
- Lancez une vraie requête authentifiée sur la route exacte ; un catalogue de modèles ou un HTTP 200 seul n'est pas une preuve de capacité.
Questions fréquentes
DeepSeek V4.1 Flash est-il meilleur que GPT-6 Astra ou Claude Fable 5.1 ? Pas comme affirmation universelle. V4.1 Flash a un grand avantage de prix et de poids ouverts, et de forts scores d'Agent rapportés par le fournisseur. DeepSeek lui-même dit que les plus grands modèles fermés gardent un avantage sur le raisonnement le plus dur et les cas limites. Aucune comparaison Astra/Fable sur le même harnais n'est disponible dans le rapport V4.1.
Combien de paramètres DeepSeek V4.1 Flash a-t-il ? Le rapport liste un tronc de 552B paramètres plus 196B paramètres Engram. Il active environ 8B paramètres de tronc par token de préremplissage et 16B par token décodé. Dire seulement « 552B au total » omet Engram ; dire « 748B actifs » est faux aussi.
Quelles sont ses limites de contexte et de sortie ? Les limites officielles sont un million de tokens de contexte et jusqu'à 384K tokens de sortie. Les plongements d'images, le texte, l'historique d'outils et le raisonnement consomment tous les budgets concernés.
Pourquoi l'appelle-t-on Flash ? Le dessin vise un coût de service plus bas : activation asymétrique préremplissage/décodage, attention éparse compressée, KV global FP4, relecture persistante bornée et décodage spéculatif. « Flash » ne promet pas la latence la plus basse pour chaque prompt ou chaque état de file.
Le cache public dure-t-il 72 heures ? Ne le supposez pas. Le rapport technique décrit un dessin de déploiement avec une persistance du KV global d'au moins 72 heures. Le guide de l'API publique appelle le cache au mieux et dit que les entrées sont en général effacées après des heures ou des jours. La facturation devrait utiliser les champs de succès et d'échec observés.
L'API Responses est-elle un remplacement direct d'OpenAI Responses ? Elle accepte une forme familière, mais elle est sans état et ignore plusieurs champs OpenAI et outils hébergés. Testez le contrat de capacité précis dont vous avez besoin.
Peut-il générer des images ? Il comprend une entrée image et renvoie du texte. Ce n'est pas un modèle de génération d'images.
Puis-je appeler V4.1 Flash via Modelflare aujourd'hui ? Oui. Utilisez deepseek-v4.1-flash-0910 dans le groupe deepseek-stable avec Chat Completions ou Responses. C'est l'ID marqué par la sortie chez Modelflare ; l'alias de première main deepseek-flash est un contrat de fournisseur à part.
Sources, méthode et journal de mise à jour
Cet article donne la priorité aux sources de première main et sépare les faits documentés, les évaluations rapportées par DeepSeek, les exemples calculés et l'état observé du catalogue Modelflare. Aucun benchmark de modèle indépendant n'a été lancé. Le calcul des coûts est conservé dans l'artefact source compagnon, et chaque scénario énonce son vecteur de tokens et ses exclusions. La couverture sans mots est une illustration éditoriale générée par IA, dans le style visuel existant de Modelflare.
Références primaires : sortie DeepSeek V4.1 Flash, rapport technique, fiche du modèle, prix, réflexion, Responses, compatibilité Anthropic, vision, cache de contexte, comparaison des modèles OpenAI, prix Anthropic, et le catalogue public Modelflare.
Mise à jour du 2026-09-10 : revue du jour de première publication. Elle enregistre l'ID de modèle de première main, le prix effectif de pointe et hors pointe, l'avis de migration d'alias du 14 septembre, les limites d'API actuelles, l'architecture du rapport technique et les données de benchmark. Une mise à jour ultérieure le même jour ajoute le lancement confirmé sur Modelflare sous deepseek-v4.1-flash-0910, les prix de passerelle en ligne et les coûts de passerelle calculés. Revérifiez les faits changeants avant la mise en œuvre.