Haiku 5.5: Anthropic mengubah kemampuan model menjadi sistem pembagian kerja
Nilai Claude Haiku 5.5 bukan hanya karena ia menjawab lebih cepat dan lebih murah, melainkan karena ia mulai mengubah pemanggilan model menjadi infrastruktur yang dapat diterapkan dalam skala besar.
Haiku 5.5: Anthropic mengubah kemampuan model menjadi sistem pembagian kerja
Nilai Claude Haiku 5.5 bukan hanya karena ia menjawab lebih cepat dan lebih murah, melainkan karena ia mulai mengubah pemanggilan model menjadi infrastruktur yang dapat diterapkan dalam skala besar.
Anthropic merilis Claude Haiku 5.5 pada 7 Oktober 2026. Pertama, satu nama yang mudah tertukar: dalam materi resmi Anthropic yang dipublikasikan, nama modelnya adalah Claude Haiku 5.5, ID modelnya adalah claude-haiku-5-5, dan tidak ada model resmi bernama "Claude Hiya 5.5". Artikel ini menggunakan Haiku 5.5 secara konsisten.
Posisi yang diberikan Anthropic jelas: ini adalah model kecil untuk tugas dengan konkurensi tinggi, latensi rendah, dan peka terhadap biaya, cocok untuk klasifikasi, ekstraksi informasi, ringkasan, kompresi konteks, kueri basis data, tindakan browser, dan subtugas agen. Menurut pihak resmi, biaya berjalan rata-rata Haiku 5.5 sekitar 75% lebih rendah daripada Haiku 4.5; ini juga model pertama di lini Haiku yang menyediakan pengaturan effort yang dapat disesuaikan.
Ini mengubah pertanyaan tentang Haiku 5.5 dari «apakah ini lagi-lagi model kecil yang lebih kuat» menjadi pertanyaan yang lebih praktis: ketika sebuah model cukup murah untuk dipanggil dalam jumlah besar, apa yang berubah pada pembagian kerja model di produk AI?
Keluarga Claude 5.5 sedang membentuk pembagian kerja yang jelas
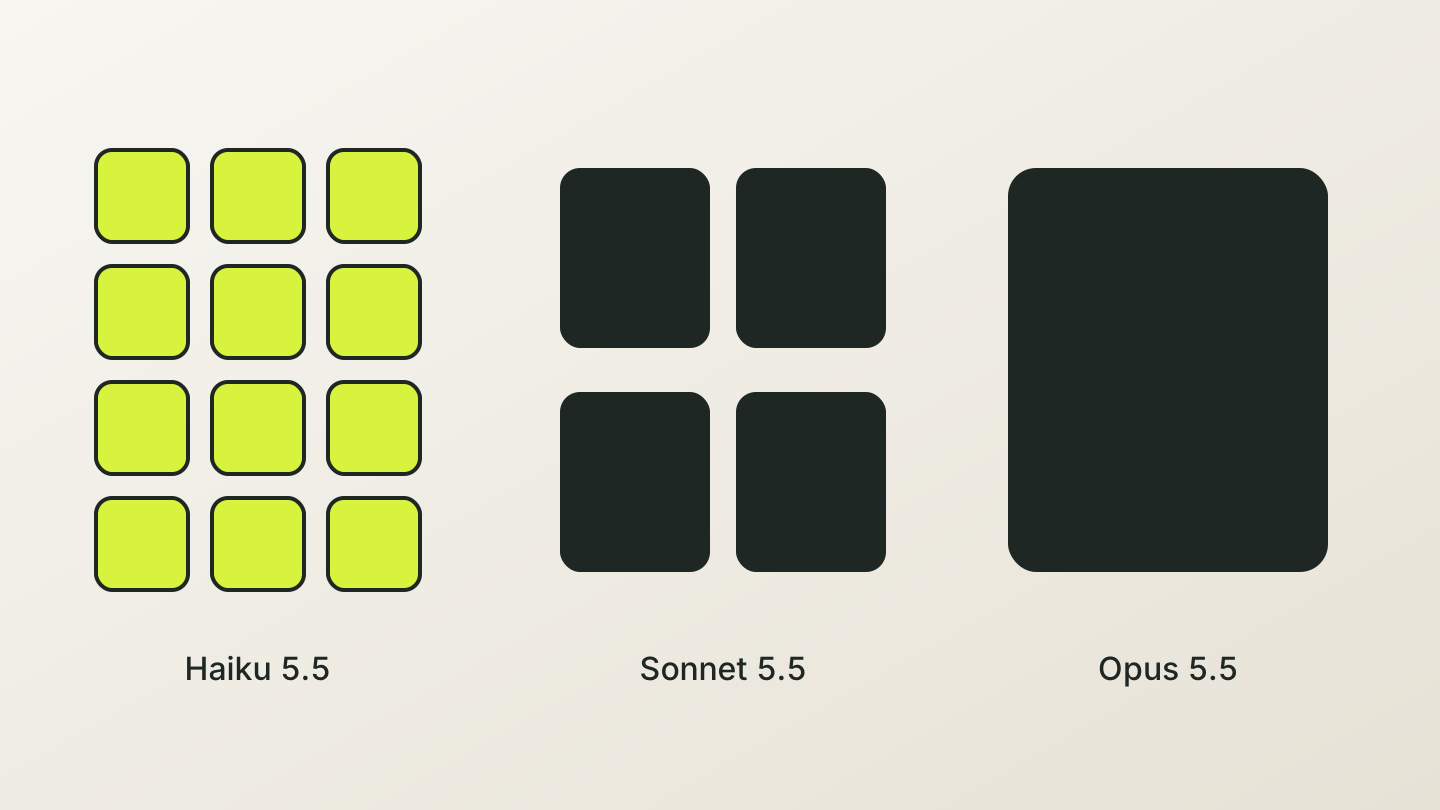
Jika hanya melihat nama model, mudah menganggap Opus, Sonnet, dan Haiku sebagai tiga posisi pada satu tangga kemampuan. Pemahaman yang lebih tepat adalah bahwa mereka sedang membentuk pembagian kerja model untuk beban kerja yang berbeda.
| Model | Peran yang lebih cocok | Tugas umum |
|---|---|---|
| Claude Opus 5.5 | Pakar masalah kompleks dan perencana jangka panjang | Agen kompleks, pengodean berdurasi panjang, penalaran sulit, keputusan kritis |
| Claude Sonnet 5.5 | Model utama untuk pekerjaan sehari-hari | Perubahan kode, pembuatan dokumen, analisis, kerja pengetahuan multi-langkah |
| Claude Haiku 5.5 | Lapisan eksekusi pemanggilan frekuensi tinggi | Klasifikasi, ekstraksi, ringkasan, kompresi, perutean, browser, dan tugas subagen |
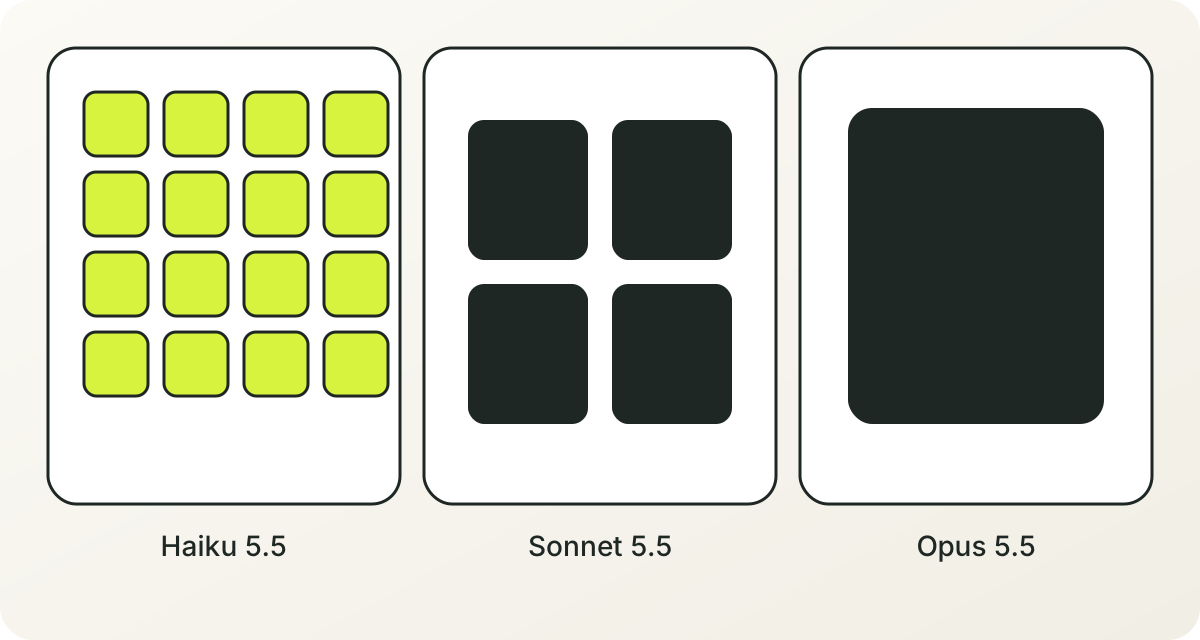
Ikhtisar model Anthropic juga memakai penempatan yang serupa: Opus 5.5 untuk pemrograman agen berdurasi panjang dan kerja pengetahuan, Sonnet 5.5 menekankan keseimbangan kecepatan dan kecerdasan, Haiku 5.5 untuk tugas klasifikasi, ekstraksi, dan perutean dengan konkurensi tinggi dan latensi rendah.
Artinya, keunggulan Haiku 5.5 tidak harus tampak sebagai «lebih kuat daripada model menengah dalam segala hal». Keunggulan itu lebih mungkin tampak di tempat lain: apakah ia dapat mengubah banyak tugas lokal yang semula tidak layak diotomatisasi karena biaya, latensi, atau throughput menjadi langkah sistem yang dapat terus berjalan.
Harga yang lebih rendah mengubah cara pemanggilan
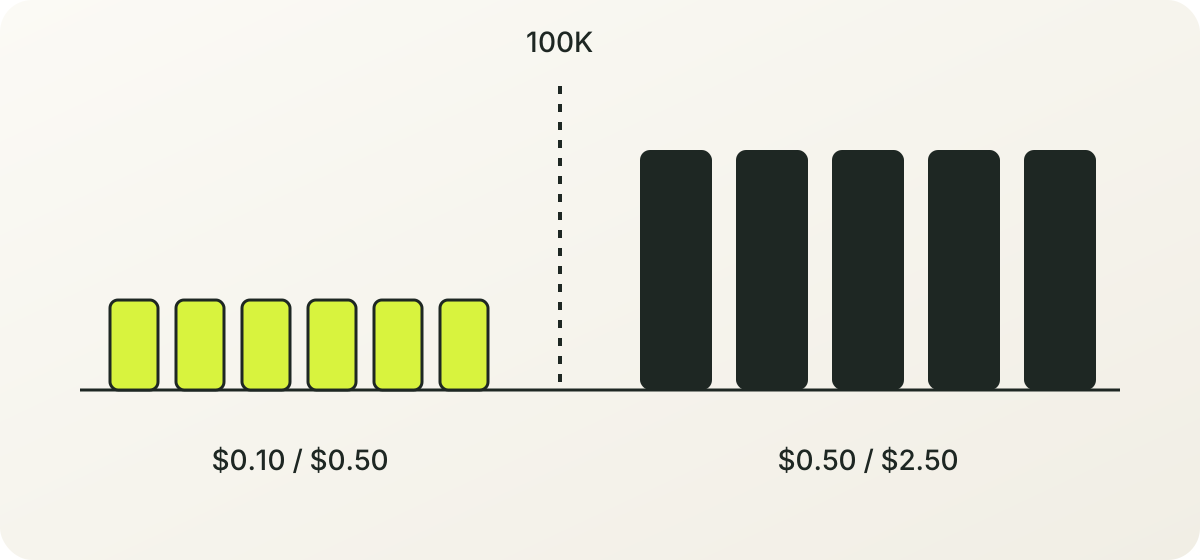
Harga resmi Haiku 5.5 perlu dipahami sebagai dua rentang. Untuk permintaan yang prompt masukannya tidak melebihi 100K tokens, harga masukan adalah $0.10 per juta tokens dan harga keluaran adalah $0.50 per juta tokens; setelah melewati 100K tokens, harganya masing-masing $0.50 dan $2.50.
| Ukuran permintaan | Masukan | Keluaran | Cache read |
|---|---|---|---|
| Tidak lebih dari 100K tokens | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| Lebih dari 100K tokens | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
Ada dua detail yang mudah terlewat di sini.
Pertama, turunnya harga satuan dan turunnya biaya nyata bukan hal yang sama. Pernyataan Anthropic «biaya berjalan rata-rata lebih rendah sekitar 75%» sudah memperhitungkan perubahan pemakaian tokens akibat tokenizer yang baru. Artinya, tidak bisa hanya membagi harga per juta tokens model lama dan baru, lalu menyimpulkan bahwa tagihan produk akan turun dengan rasio yang sama.
Kedua, apakah model berhasil menyelesaikan tugas memengaruhi biaya nyata. Satu pemanggilan bisa murah, tetapi jika perlu percobaan ulang, kembali ke Sonnet, atau menambah pemeriksaan manusia, biaya tugas pada akhirnya tetap bisa tinggi.
Karena itu, tim produk lebih baik memperhatikan ukuran ini:
Biaya tiap tugas yang berhasil
= total biaya model dan alat untuk menyelesaikan tugas ÷ jumlah tugas yang berhasil diselesaikan
Jika arsitektur yang berbeda dibandingkan lebih jauh, percobaan ulang, fallback, pemanggilan alat, dan pengambilalihan manusia juga harus masuk ke tagihan total.
Salah satu perubahan terpenting Haiku 5.5 adalah effort yang dapat disesuaikan
Haiku 5.5 adalah model pertama di lini Haiku yang menyediakan effort yang dapat disesuaikan. Pengaturan ini membuat «pemilihan model» bukan lagi satu-satunya sakelar biaya; di dalam model yang sama, sistem juga dapat mengubah besarnya upaya penalaran.
Ini dapat dipahami seperti mode berkendara sebuah mobil:
- Untuk klasifikasi sederhana dan konversi format, gunakan effort yang lebih rendah dan utamakan kecepatan serta biaya rendah.
- Untuk ekstraksi terstruktur dan kompresi teks panjang, gunakan effort sedang dan seimbangkan kualitas dengan biaya.
- Untuk tugas yang membutuhkan penilaian multi-langkah, naikkan effort.
- Jika tugas tetap gagal, naikkan ke Sonnet atau Opus.
Dari situ muncul rumus keputusan yang baru:
Hasil akhir = model × effort × konteks × alat × strategi percobaan ulang
Karena itu, saat membandingkan model selanjutnya, jangan hanya bertanya «siapa yang lebih kuat, Haiku 5.5 atau Sonnet 5.5». Perlu juga bertanya:
- Pada tugas yang sama, tingkat effort mana yang paling menguntungkan?
- Apakah kenaikan kualitas dari effort yang lebih tinggi menutupi biaya tambahan?
- Pada tugas sederhana, apakah effort yang lebih tinggi hanya memperpanjang waktu tunggu?
- Lebih menguntungkan membiarkan Haiku mencoba sekali lagi, atau memanggil Sonnet satu kali?
Itulah mengapa Haiku 5.5 lebih cocok dinilai dari biaya tingkat tugas, bukan dari kesan satu keluaran.
Agen dapat beralih dari «satu model besar mengerjakan semuanya» ke kolaborasi berlapis
Dulu struktur banyak agen kira-kira seperti ini: setelah pengguna mengajukan permintaan, satu model besar menangani perencanaan, pengambilan, pemanggilan alat, penyusunan hasil, dan jawaban akhir.
Permintaan pengguna → model besar merencanakan → model besar mencari → model besar meringkas → model besar menjawab
Bentuk ini sederhana, tetapi membuat setiap tindakan lokal memakai model mahal yang sama. Bagi agen yang perlu mencari puluhan dokumen, memproses ratusan catatan, atau berulang kali memanggil browser, biaya dan latensi cepat menumpuk.
Haiku 5.5 lebih cocok masuk ke arsitektur berlapis seperti ini:
Permintaan pengguna
   ↓
Sonnet atau Opus memecah tugas dan menyusun rencana
   ↓
Haiku 5.5 mencari, mengklasifikasi, mengekstrak, meringkas, dan melakukan pemanggilan alat satu langkah
   ↓
Sonnet atau Opus meninjau hasil dan membuat keputusan akhir
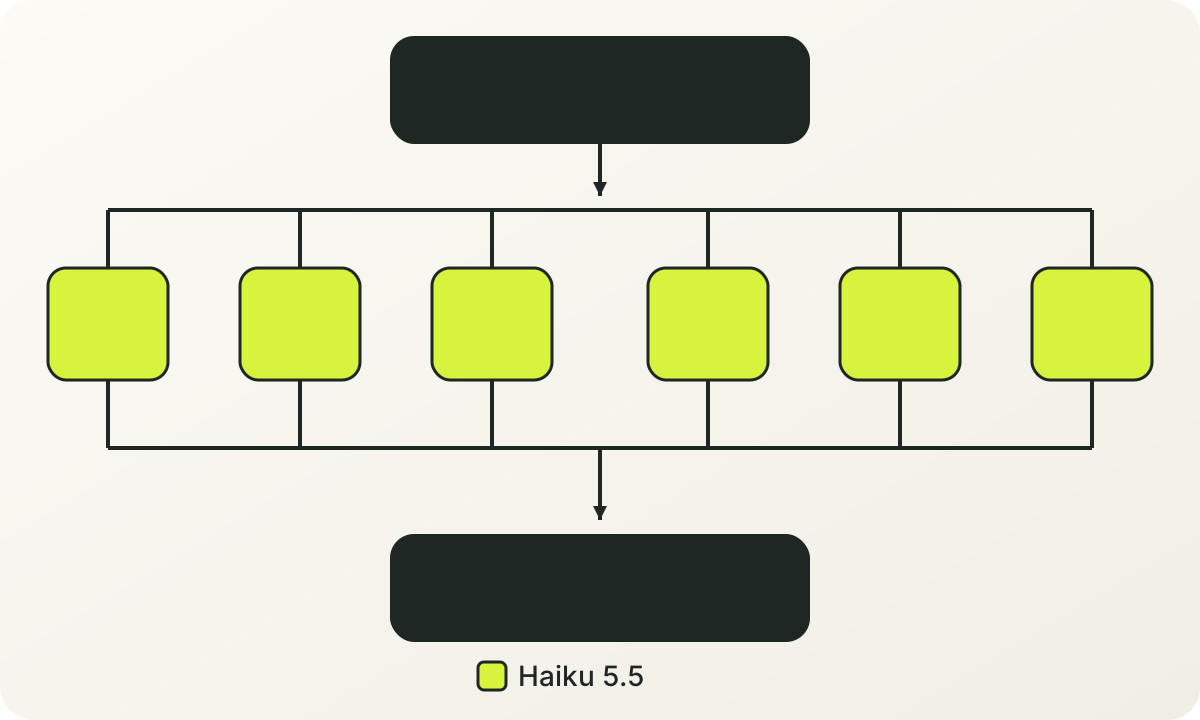
Dalam bentuk ini, nilai Haiku 5.5 bukan menyelesaikan tugas tersulit sendiri, melainkan menjadi «lapisan pekerja» agen. Ia menangani kerja lokal yang paling banyak jumlahnya, relatif jelas strukturnya, dan dapat diperiksa.
Pekerjaan yang cocok diserahkan ke Haiku 5.5
- Merutekan permintaan pengguna ke alur kerja yang berbeda.
- Mengekstrak bidang tetap dari satu dokumen atau beberapa dokumen.
- Mengklasifikasi tiket dan menetapkan prioritasnya.
- Mengompresi percakapan panjang menjadi konteks yang dibutuhkan giliran agen berikutnya.
- Menghapus duplikat hasil pencarian dan menulis ringkasan awal.
- Melakukan satu tindakan browser yang eksplisit.
- Memeriksa format kode, membuat tes sederhana, atau menjelaskan potongan kode lokal.
- Menyelesaikan sepotong kerja singkat sebagai subagen Sonnet atau Opus.
Pekerjaan yang tidak seharusnya diserahkan ke Haiku 5.5 secara bawaan
- Proyek kompleks yang membutuhkan perencanaan jangka panjang.
- Perubahan kode yang menyentuh banyak berkas, banyak dependensi, dan beberapa putaran umpan balik.
- Keputusan kritis yang satu kesalahannya membawa kerugian tinggi.
- Pekerjaan yang harus mempertahankan keadaan kompleks sepanjang proses yang panjang.
- Tugas tanpa cara verifikasi otomatis, yang hanya dapat mengandalkan penilaian manusia.
Intinya bukan memberi model label «bisa» atau «tidak bisa», melainkan menilai harga kegagalan tugas. Untuk tugas yang dapat diperiksa otomatis dan dicoba ulang setelah gagal, rasio harga terhadap kinerja Haiku 5.5 lebih menarik; untuk tugas yang harga kegagalannya tinggi, Sonnet atau Opus tetap lebih mantap.
Bagaimana pengembang biasa memilih di antara tiga tingkat model
Bisa mulai dengan perutean sederhana berdasarkan kompleksitas tugas dan harga kegagalan:
| Ciri tugas | Pilihan bawaan | Syarat naik tingkat |
|---|---|---|
| Format keluaran tetap dan dapat diverifikasi otomatis | Haiku 5.5 | Kesalahan format berulang atau bidang kunci hilang |
| Volume pemanggilan besar dan peka terhadap latensi | Haiku 5.5 | Latensi p95 atau tingkat kegagalan melewati ambang produk |
| Membutuhkan ringkasan, kompresi, klasifikasi, ekstraksi | Haiku 5.5 | Muncul penalaran lintas dokumen atau konflik konteks |
| Kerja pengetahuan biasa dan perubahan kode | Sonnet 5.5 | Rentang tugas panjang atau dibutuhkan beberapa putaran perencanaan |
| Agen kompleks dan pengodean jangka panjang | Sonnet 5.5 atau Opus 5.5 | Toleransi terhadap kesalahan sangat rendah atau dibutuhkan penalaran mendalam |
| Penilaian berisiko tinggi dan tinjauan akhir | Sonnet 5.5 atau Opus 5.5 | Putuskan menurut harga kesalahan dan kemampuan verifikasi |
Tabel ini tidak boleh dianggap jawaban yang tetap untuk selamanya. Sebelum benar-benar masuk ke lingkungan produksi, ukur kumpulan tugas sendiri dan temukan batas tiap tingkat model pada tingkat keberhasilan, latensi, dan biaya tiap tugas yang berhasil.
100K tokens adalah batas harga yang perlu diperhatikan
Harga yang diiklankan untuk Haiku 5.5 rendah, tetapi setelah 100K tokens harga naik dengan jelas. Untuk aplikasi dokumen panjang, repositori kode, dan percakapan panjang, tim tidak boleh hanya melihat harga awal model yang dipublikasikan.
Satu alur kerja konteks panjang dapat dipecah menjadi beberapa langkah:
- Bangun cache saat dokumen dibaca pertama kali.
- Gunakan Haiku 5.5 untuk mengompresi konteks.
- Serahkan ke Sonnet hanya bagian yang terkait dengan pertanyaan saat ini.
- Simpan hasil antara sebagai keadaan terstruktur.
- Hindari mengirim ulang seluruh riwayat pada setiap giliran.
Proses ini punya dua manfaat: ia menurunkan peluang melewati rentang harga 100K, dan membiarkan model yang berbeda memikul pekerjaan yang berbeda.
Karena itu, nilai konteks panjang Haiku 5.5 tidak bisa diukur hanya dengan «berapa banyak tokens yang dapat ia baca». Pertanyaan yang lebih praktis adalah:
- Berapa banyak bahan mentah yang harus dimasukkan ke model.
- Bahan mana yang harus dikompresi lebih dulu.
- Berapa tingkat mengenai cache.
- Apakah harga setelah melewati 100K masih dapat diterima.
- Dapatkah hilangnya informasi karena kompresi membuat tugas berikutnya gagal.
Rilis Haiku 5.5 juga mengubah titik berat evaluasi model
Halaman resmi sudah menyediakan hasil GDPval-AA, OSWorld, Humanity's Last Exam, Terminal-Bench, dan lainnya. Hasil itu membantu pembaca melihat kisaran kemampuan model secara kasar, tetapi tim produk tetap membutuhkan tes pada tugasnya sendiri.
Dalam sistem nyata, yang paling layak diamati bukan satu hasil model pada satu tolok ukur, melainkan kumpulan ukuran berikut:
- Tingkat keberhasilan tugas.
- Kualitas keluaran.
- Latensi p50 dan p95.
- Jumlah tokens masukan dan keluaran.
- Tingkat percobaan ulang.
- Tingkat kesalahan pemanggilan alat.
- Tingkat fallback.
- Tingkat pengambilalihan manusia.
- Biaya tiap tugas yang berhasil.
Perhatikan khususnya stabilitas saat dijalankan berulang. Satu jawaban yang bagus untuk Prompt yang sama hanya menunjukkan bahwa jalannya kali ini berhasil. Itu tidak langsung menunjukkan bahwa model akan secara stabil menyelesaikan jenis tugas yang sama di lingkungan produksi.
Cara pengujian yang lebih andal adalah:
- Siapkan satu set sampel independen untuk setiap jenis tugas.
- Jalankan dengan prompt sistem, konteks, definisi alat, dan wilayah yang sama.
- Ulangi setiap sampel beberapa kali.
- Nilai hasil dengan aturan, tes tersembunyi, atau tinjauan buta oleh manusia.
- Laporkan tingkat keberhasilan dan interval kepercayaan.
- Cantumkan kasus terburuk dan jenis kegagalan secara terpisah.
Metode ini pada akhirnya menggeser evaluasi model dari «keluaran mana yang terbaik» menjadi «dapatkah sistem ini terus menyelesaikan pekerjaan».
Apa arti Haiku 5.5 bagi pengguna perorangan
Pengguna perorangan belum tentu langsung merasakan perubahan harga satuan API, tetapi posisi Haiku 5.5 dapat dipahami dari tiga sudut.
Pertama, ia lebih cocok untuk tugas yang cepat, berulang, dan berbatas jelas, misalnya merapikan teks, mengekstrak informasi, membuat draf terstruktur, dan menangani banyak pertanyaan kecil.
Kedua, ia tidak harus cocok untuk menggantikan semua model yang lebih kuat. Penulisan kompleks, perencanaan jangka panjang, kode yang sulit, dan pekerjaan yang harus terus mempertahankan keadaan masih lebih bergantung pada Sonnet atau Opus.
Ketiga, perbedaan antar model akan semakin mirip «perbedaan cara kerja», bukan sekadar perbedaan tinggi dan rendah. Saat memilih model, lihat dulu frekuensi tugas, syarat latensi, harga kesalahan, dan cara verifikasi, baru kemudian kemampuan satu pemanggilan.
Yang harus dihitung ulang tim produk adalah ekonomi satu satuan tugas
Haiku 5.5 membuat lebih mudah mencoba langkah yang dulu tidak layak diotomatisasi:
- Satu lapisan klasifikasi masukan lagi.
- Satu putaran kompresi hasil pengambilan lagi.
- Satu subagen lagi yang khusus menangani dokumen.
- Satu pemeriksaan keluaran berbiaya rendah lagi.
- Satu verifikasi terstruktur lagi sebelum jawaban akhir.
Langkah baru ini sendiri menambah jumlah pemanggilan, tetapi jika mereka menurunkan tingkat kegagalan akhir, biaya produk secara keseluruhan tetap bisa turun.
Itulah sebabnya «harga model untuk satu pemanggilan» tidak cukup. Yang benar-benar perlu dibandingkan tim produk adalah ini:
Biaya satu pemanggilan
→ total biaya satu tugas
→ total biaya satu tugas yang berhasil
→ total biaya satu hasil yang dapat diserahkan
Ketika Haiku 5.5 cukup murah, sistem dapat menukar beberapa tugas kecil dengan keandalan akhir yang lebih tinggi. Perubahan ini memengaruhi rancangan agen, struktur laba produk, dan pekerjaan mana yang tim putuskan untuk diserahkan kepada model agar diselesaikan secara otomatis.
Penutup: Haiku 5.5 adalah perubahan arsitektur
Rilis Haiku 5.5 dapat dipahami sebagai peningkatan model kecil, dan juga sebagai langkah Anthropic yang mendorong bentuk produk model.
Ia menempatkan tiga pertanyaan pada satu lembar keputusan yang sama:
- Berapa banyak kecerdasan yang dibutuhkan tugas ini.
- Berapa banyak latensi yang dapat ditanggung tugas ini.
- Berapa banyak uang yang layak untuk tugas ini.
Ketika pemilihan model diletakkan bersama perutean tugas, effort, cache, percobaan ulang, dan pengambilalihan manusia, «model mana yang paling kuat» bukan lagi satu-satunya pertanyaan. Pertanyaan yang lebih penting menjadi:
Model mana yang harus menangani pemanggilan yang mana, dan bagaimana mendapatkan hasil yang cukup andal dengan biaya ujung ke ujung yang terendah?
Makna Haiku 5.5 mungkin terletak pada ini: ia membuat pertanyaan tersebut untuk pertama kalinya cukup murah sehingga layak ditanyakan dalam skala besar.