Haiku 5.5:Anthropic はモデル能力を分業システムへと変えつつある
Claude Haiku 5.5 の価値は、より速く、より安く答えることだけでなく、モデル呼び出しを大規模にデプロイできるインフラへと変え始めていることにあります。
Haiku 5.5:Anthropic はモデル能力を分業システムへと変えつつある
Claude Haiku 5.5 の価値は、より速く、より安く答えることだけでなく、モデル呼び出しを大規模にデプロイできるインフラへと変え始めていることにあります。
Anthropic は 2026年10月7日に Claude Haiku 5.5 をリリースしました。まず、混同しやすい名称を説明します。公開されている Anthropic の公式資料では、モデル名は Claude Haiku 5.5、モデル ID は claude-haiku-5-5 であり、「Claude Hiya 5.5」という名称の公式モデルはありません。この記事では一貫して Haiku 5.5 を使います。
Anthropic が与えた位置づけは明確です。これは、高同時実行、低遅延、コストに敏感な作業向けの小型モデルで、分類、情報抽出、要約、コンテキスト圧縮、データベース照会、ブラウザ操作、エージェントのサブタスクに向いています。公式では、Haiku 5.5 の平均実行コストは Haiku 4.5 より約 75% 低く、Haiku シリーズで初めて調整可能な effort 設定を備えたモデルでもある、としています。
これにより、Haiku 5.5 についての問いは「また一つ、より強い小型モデルなのか」から、より実務的な問いへ変わります。一つのモデルが大量に呼べるほど安くなったとき、AI 製品におけるモデルの分業はどう変わるのか。
Claude 5.5 ファミリーは、明確な分業を形づくりつつある
モデル名だけを見ると、Opus、Sonnet、Haiku を、同じ能力ランキング上の三つの位置だと理解しがちです。より正確には、異なるワークロードに向けた、一揃いのモデル分業が形づくられつつあります。
| モデル | より適した役割 | 典型的な作業 |
|---|---|---|
| Claude Opus 5.5 | 複雑な問題の専門家と長期の計画者 | 複雑なエージェント、長時間のコーディング、困難な推論、重要な意思決定 |
| Claude Sonnet 5.5 | 日常の仕事の主力モデル | コードの修正、文書の生成、分析、複数ステップの知識作業 |
| Claude Haiku 5.5 | 高頻度で呼ばれる実行層 | 分類、抽出、要約、圧縮、ルーティング、ブラウザとサブエージェントの作業 |
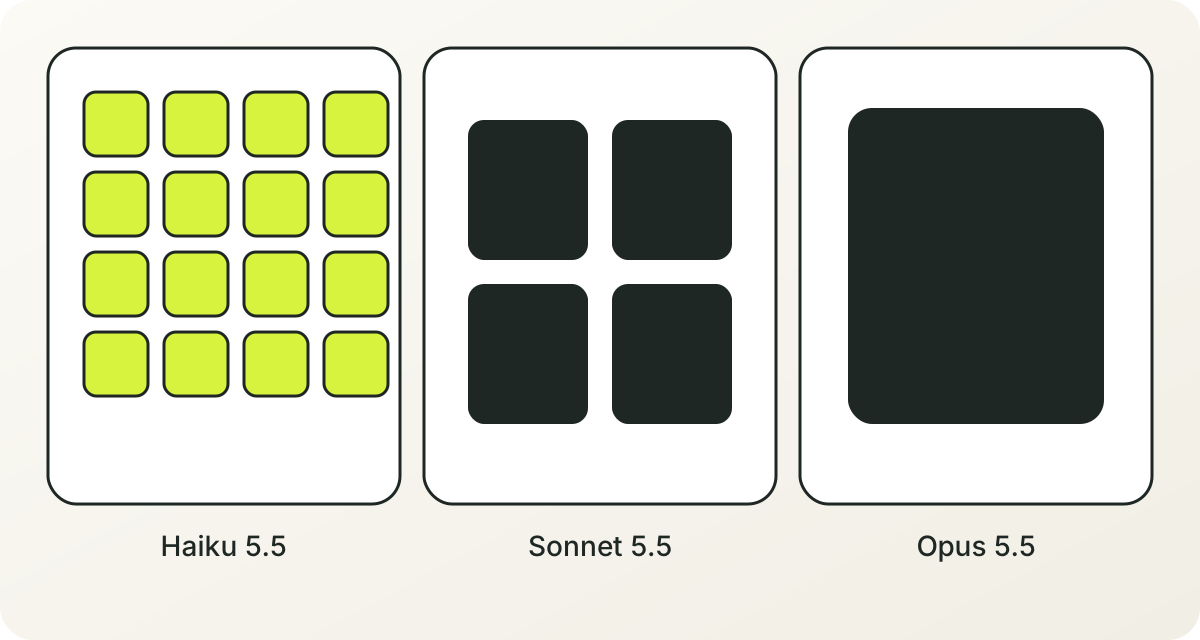
Anthropic のモデル概要も、似た位置づけを採っています。Opus 5.5 は長時間のエージェントによるコーディングと知識作業向け、Sonnet 5.5 は速度と知能のバランスを強調し、Haiku 5.5 は高同時実行かつ低遅延の分類、抽出、ルーティング作業向けです。
これは、Haiku 5.5 の競争力が、必ずしも「あらゆることで中型モデルより強い」こととして現れるわけではない、という意味です。より現れやすいのは別の場所です。コスト、遅延、またはスループットのために、もともと自動化する価値がなかった大量の局所的な作業を、継続して実行できるシステムの手順に変えられるか。
価格が下がって変わるのは、呼び出し方である
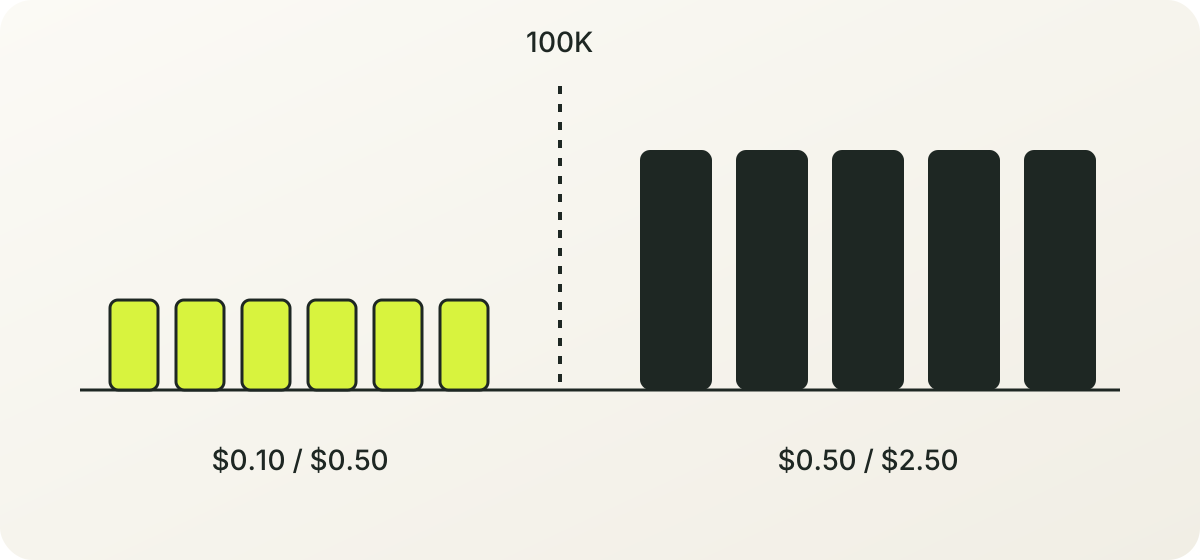
Haiku 5.5 の公式価格は、二つの区間に分けて理解する必要があります。入力プロンプトが 100K tokens を超えないリクエストでは、入力価格は 100万 tokens あたり $0.10、出力価格は 100万 tokens あたり $0.50 です。100K tokens を超えると、価格はそれぞれ $0.50 と $2.50 です。
| リクエストの規模 | 入力 | 出力 | Cache read |
|---|---|---|---|
| 100K tokens 以下 | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| 100K tokens 超 | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
ここに、見落としやすい細部が二つあります。
第一に、単価が下がることと、実際のコストが下がることは、同じではありません。Anthropic の「平均実行コストが約 75% 低い」には、新しい tokenizer がもたらす token 使用の変化が、すでに含まれています。つまり、新旧モデルの 100万 token あたりの単価を割るだけでは、製品の請求額が同じ割合で下がると推論することはできません。
第二に、モデルが作業を成功させて終えられるかどうかは、実際のコストに影響します。呼び出し一つは安くても、再試行、Sonnet へのフォールバック、人手の確認の追加が必要になるなら、最終的な作業コストはなお高くなり得ます。
したがって、製品チームがより注目すべきなのは、次の指標です。
成功した作業1件あたりのコスト
= 作業を終えるまでに生じたモデルとツールの総費用 ÷ 成功して完了した作業の数
異なるアーキテクチャをさらに比べるなら、再試行、fallback、ツール呼び出し、人手による引き継ぎも、総請求に含めるべきです。
Haiku 5.5 で最も重要な変化の一つは、effort が調整可能になったこと
Haiku 5.5 は、Haiku シリーズで初めて調整可能な effort を備えたモデルです。この設定によって、「モデルの選択」は唯一のコストのスイッチではなくなります。システムは、同じモデルの中で、推論への投入も調整できます。
車の運転モードのように理解できます。
- 単純な分類と形式の変換では、低めの effort を使い、速度と低コストを優先する。
- 構造化された抽出と長文の圧縮では、中程度の effort を使い、品質と費用のバランスを取る。
- 複数ステップの判断が必要な作業では、effort を上げる。
- それでも作業が失敗するなら、Sonnet または Opus へ上げる。
ここから、新しい決定の式が出てきます。
最終的な効果 = モデル × effort × コンテキスト × ツール × 再試行方針
したがって、これからモデルを比べるときは、「Haiku 5.5 と Sonnet 5.5 のどちらがより強いか」だけを問うのでは足りません。次も問う必要があります。
- 同じ作業で、どの effort の段階が最も割に合うか。
- effort を上げたときの品質の向上は、追加コストを賄えるか。
- 単純な作業では、effort を上げても待ち時間が延びるだけではないか。
- Haiku にもう一度試させる方が割に合うか、それとも Sonnet を一度呼ぶ方が割に合うか。
これが、Haiku 5.5 を一回の出力の印象ではなく、作業単位のコストで評価する方が適切な理由です。
エージェントは「一つの大モデルが全部やる」から層状の協働へ移るかもしれない
これまで多くのエージェントの構造は、次に近いものでした。ユーザーが依頼したあと、一つの大モデルが、計画、検索、ツール呼び出し、結果の整理、最終の回答を担います。
ユーザーの依頼 → 大モデルが計画 → 大モデルが検索 → 大モデルが要約 → 大モデルが出力
この構造は単純ですが、局所的な動作の一つ一つに、同じ高価なモデルを使わせます。数十件の文書を検索し、数百件の記録を処理し、あるいはブラウザを繰り返し呼ぶエージェントでは、コストと遅延はすぐに積み上がります。
Haiku 5.5 は、次のような層状のアーキテクチャに入る方が向いています。
ユーザーの依頼
   ↓
Sonnet または Opus が作業を分解し、計画を立てる
   ↓
Haiku 5.5 が検索、分類、抽出、要約、単一ステップのツール呼び出しを担う
   ↓
Sonnet または Opus が結果を審査し、最終決定を行う
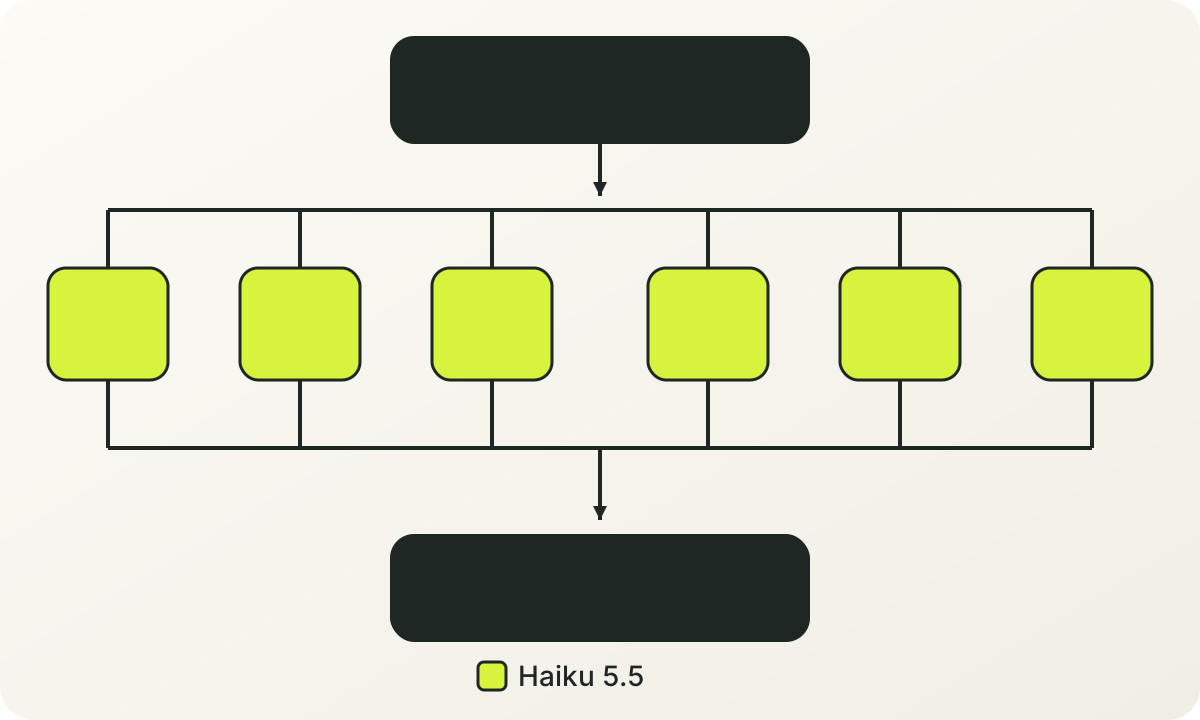
この構造では、Haiku 5.5 の価値は、最も複雑な作業を単独で終えることではありません。エージェントの「作業者の層」になることです。数が最も多く、構造が比較的はっきりしていて、検証できる局所的な仕事を扱います。
Haiku 5.5 に向いている仕事
- ユーザーの依頼を、異なるワークフローへルーティングする。
- 一つの文書、または数個の文書から、固定フィールドを抽出する。
- チケットを分類し、優先度を並べる。
- 長い対話を、次のラウンドのエージェントに必要なコンテキストへ圧縮する。
- 検索結果の重複を除き、初歩的な要約を作る。
- 明確なブラウザ操作を一度行う。
- コードの形式を検査する、簡単なテストを生成する、または局所的なコードを説明する。
- Sonnet または Opus のサブエージェントとして、短い一段の仕事を終える。
デフォルトでは Haiku 5.5 に渡すべきでない仕事
- 長期の計画を要する複雑なプロジェクト。
- 複数のファイル、複数の依存関係、複数ラウンドのフィードバックにまたがるコード修正。
- 一度の誤りが、比較的大きな損失をもたらす重要な決定。
- 長い作業過程のあいだ、複雑な状態を保つ必要がある仕事。
- 自動で検証する手段がなく、人の判断に頼るしかない作業。
ここでの要点は、モデルに「できる」か「できない」かのラベルを貼ることではありません。作業が失敗したあとの代償を評価することです。自動で検査でき、失敗したあと再試行できる作業では、Haiku 5.5 の費用対効果はより魅力的になります。失敗の代償が高い作業では、Sonnet または Opus の方がなお堅実です。
一般の開発者は三つの段階のモデルをどう選ぶべきか
まず、作業の複雑さと失敗の代償で、単純なルーティングができます。
| 作業の特徴 | デフォルトの選択 | 上の段階へ移す条件 |
|---|---|---|
| 出力形式が固定され、自動で検証できる | Haiku 5.5 | 形式の誤りが続く、または重要なフィールドが欠ける |
| 呼び出し量が多く、遅延に敏感 | Haiku 5.5 | p95 の遅延か失敗率が製品の閾値を超える |
| 要約、圧縮、分類、抽出が必要 | Haiku 5.5 | 文書をまたぐ推論、またはコンテキストの衝突が現れる |
| 通常の知識作業とコード修正 | Sonnet 5.5 | 作業のスパンが長い、または複数ラウンドの計画が必要 |
| 複雑なエージェントと長期のコーディング | Sonnet 5.5 または Opus 5.5 | 誤りへの許容が極めて低い、または深い推論が必要 |
| 高リスクの判断と最終審査 | Sonnet 5.5 または Opus 5.5 | 誤りの代償と検証能力から決める |
この表を、いつまでも固定された答えと見なすべきではありません。本番に入れる前に、自分の作業集合で測り、各段階のモデルが、成功率、遅延、成功した作業一つあたりのコストのどこで分かれるかを見つけるべきです。
100K tokens は、特に注意すべき価格の境界である
Haiku 5.5 の宣伝上の価格は低いものの、100K tokens を超えると価格ははっきり上がります。長い文書、コードのリポジトリ、長い対話のアプリケーションでは、チームはモデルの公開された開始価格だけを見てはいけません。
長いコンテキストのワークフローは、いくつかの手順に分けられます。
- 文書を初めて読むときに、キャッシュを作る。
- Haiku 5.5 でコンテキストを圧縮する。
- 今の問いに関係する断片だけを Sonnet に渡す。
- 中間結果を、構造化された状態として保存する。
- 毎ラウンド、履歴の全文を送り直すことを避ける。
この流れには二つの利点があります。100K の価格区間を跨ぐ確率を下げ、異なるモデルに異なる仕事を担わせることができます。
したがって、Haiku 5.5 の長いコンテキストの価値は、「最大で何 tokens 読めるか」だけでは測れません。より実務的な問いは、次です。
- どれだけの元の内容をモデルに入れる必要があるか。
- どの内容を先に圧縮すべきか。
- キャッシュのヒット率はどれくらいか。
- 100K を超えたあとの価格は、なお受け入れられるか。
- 圧縮による情報の損失が、その後の作業の失敗につながるか。
Haiku 5.5 のリリースは、モデル評価の重点も変える
公式ページは、すでに GDPval-AA、OSWorld、Humanity's Last Exam、Terminal-Bench などの複数の成績を出しています。これらは、読者がモデルのおおよその能力範囲を知る助けになります。ただし、製品チームはなお自分たちの作業でのテストを必要とします。
実際のシステムで最も観察する価値があるのは、一つのモデルがあるベンチマークで取った単一の成績ではありません。次の一組の指標です。
- 作業の成功率。
- 出力の品質。
- p50 と p95 の遅延。
- 入力と出力の token 数。
- 再試行率。
- ツール呼び出しのエラー率。
- fallback 率。
- 人手による引き継ぎの率。
- 成功した作業一つあたりのコスト。
特に注意すべきは、繰り返し実行したときの安定性です。同じ Prompt に一度きれいな回答が返っても、その実行が成功したことを示すだけです。本番環境で同種の作業を安定して終えることまでは、直接には示しません。
より信頼できるテストのやり方は、次のとおりです。
- 作業の種類ごとに、独立したサンプルの組を用意する。
- 同じシステムプロンプト、コンテキスト、ツール定義、地域の条件で実行する。
- 各サンプルを複数回繰り返す。
- 規則、隠されたテスト、または人手による盲検評価で結果を判断する。
- 成功率と信頼区間を報告する。
- 最悪の事例と失敗の類型を、別に列挙する。
この方法は、最終的にモデル評価を、「どの出力が一番よかったか」から、「このシステムは仕事を継続して終えられるか」へ移します。
個人のユーザーにとって、Haiku 5.5 は何を意味するか
個人のユーザーは、API の単価の変化を直接は感じないかもしれません。それでも、三つの角度から Haiku 5.5 の位置を理解できます。
第一に、速く、繰り返しがあり、境界が明確な作業により向いています。たとえば、文章を整理する、情報を抽出する、構造化された下書きを生成する、大量の小さな問いを処理する、といった作業です。
第二に、すべての上位モデルの代わりになるとは限りません。複雑な執筆、長期の計画、困難なコード、状態を途切れず保つ必要がある仕事は、なお Sonnet または Opus により依存します。
第三に、モデルのあいだの差は、ますます「働き方の差」のようになり、単純な上下の差ではなくなります。モデルを選ぶときは、まず作業の頻度、遅延への要求、誤りの代償、検証の手段を見て、そのあとモデルの一回あたりの能力を見ます。
製品チームが計算し直すべきなのは、作業単位の経済学である
Haiku 5.5 は、これまで自動化する価値がなかった多くの手順を、試しやすくします。
- 入力の分類を、一段増やす。
- 検索結果の圧縮を、もう一周増やす。
- 文書を専門に処理するサブエージェントを、一つ増やす。
- 低コストの出力検査を、一度増やす。
- 最終回答の前に、構造化された検証を一度加える。
これらの新しい手順そのものは、呼び出し回数を増やします。しかし最終的な失敗率を下げられるなら、製品全体のコストはかえって下がることがあります。
これが、「一回あたりのモデル価格」では足りない理由です。製品チームが本当に比べる必要があるのは、次です。
一回の呼び出しのコスト
→ 一つの作業の総コスト
→ 成功した一つの作業の総コスト
→ 引き渡せる一つの結果の総コスト
Haiku 5.5 が十分に安いとき、システムは複数の小さな作業と引き換えに、より高い最終的な信頼性を得られる可能性があります。この変化は、エージェントの設計、製品の利益の構造、そしてチームがどの仕事をモデルに自動で任せるかに影響します。
結び:Haiku 5.5 はアーキテクチャの変化である
Haiku 5.5 のリリースは、小型モデルの一度のアップグレードとして理解することもでき、Anthropic がモデル製品の形態を一度推し進めたこととして理解することもできます。
三つの問いを、同じ意思決定の表に載せます。
- この作業には、どれだけの知能が必要か。
- この作業は、どれだけの遅延に耐えられるか。
- この作業には、どれだけの金額を払う価値があるか。
モデルの選択が、作業のルーティング、effort、キャッシュ、再試行、人手による引き継ぎと一緒に置かれるとき、「どのモデルが最も強いか」は唯一の問いではなくなります。より重要な問いは、次のように変わります。
どのモデルがどの種類の呼び出しを扱うべきで、十分な信頼性のある結果を、エンドツーエンドで最も低いコストでどう得るのか?
Haiku 5.5 の意義は、この問いを初めて十分に安くし、大規模に一度問う価値があるものにした、という点にあるのかもしれません。