Haiku 5.5: a Anthropic está a transformar a capacidade dos modelos num sistema de divisão do trabalho
O valor do Claude Haiku 5.5 não está apenas em responder mais depressa e de forma mais barata, mas em começar a transformar as chamadas ao modelo numa infraestrutura que pode ser implantada em grande escala.
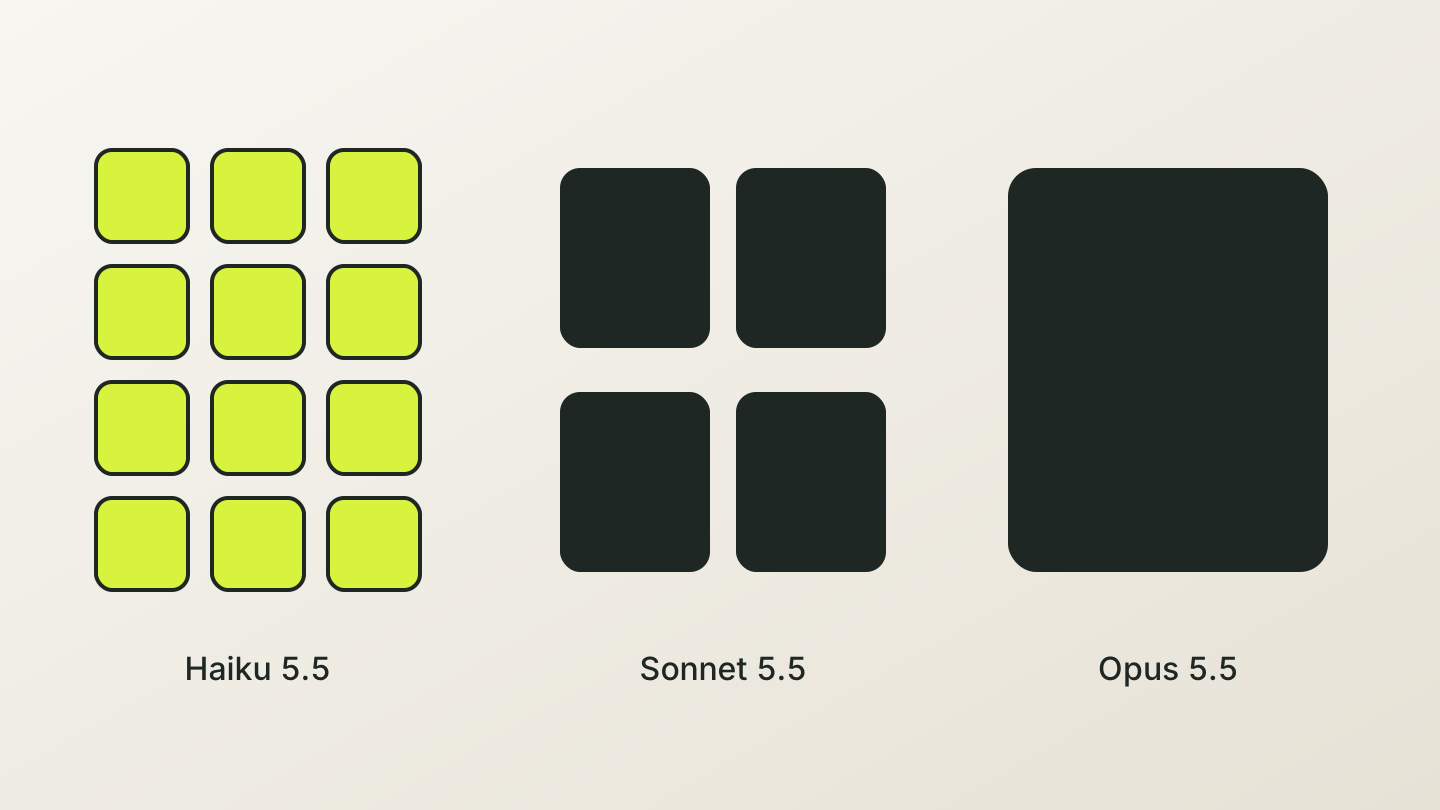
Haiku 5.5: a Anthropic está a transformar a capacidade dos modelos num sistema de divisão do trabalho
O valor do Claude Haiku 5.5 não está apenas em responder mais depressa e de forma mais barata, mas em começar a transformar as chamadas ao modelo numa infraestrutura que pode ser implantada em grande escala.
A Anthropic lançou o Claude Haiku 5.5 em 7 de outubro de 2026. Convém esclarecer primeiro um nome fácil de confundir: nos materiais públicos oficiais da Anthropic, o nome do modelo é Claude Haiku 5.5 e o ID do modelo é claude-haiku-5-5. Não existe um modelo oficial chamado "Claude Hiya 5.5". Este artigo usa Haiku 5.5 em todo o texto.
O posicionamento da Anthropic é explícito. É um modelo pequeno para tarefas de alta concorrência, baixa latência e sensíveis ao custo, adequado a classificação, extração de informação, resumo, compressão de contexto, consultas a bases de dados, ações no navegador e subtarefas de agente. Segundo a fonte oficial, o custo médio de execução do Haiku 5.5 é cerca de 75% mais baixo do que o do Haiku 4.5. É também o primeiro modelo da série Haiku com um ajuste de effort regulável.
Isto muda a pergunta sobre o Haiku 5.5, de «é mais um modelo pequeno mais forte?», para uma mais prática: quando um modelo é barato o suficiente para ser chamado em grande número, o que muda na divisão do trabalho entre modelos dentro de um produto de IA?
A família Claude 5.5 está a formar uma divisão do trabalho clara
Se se olha apenas para os nomes, é fácil entender Opus, Sonnet e Haiku como três lugares numa mesma tabela de capacidade. Uma leitura mais precisa é que estão a formar uma divisão do trabalho entre modelos, orientada a cargas de trabalho diferentes.
| Modelo | Papel mais adequado | Tarefas típicas |
|---|---|---|
| Claude Opus 5.5 | Especialista em problemas complexos e planificador de longo horizonte | Agentes complexos, programação prolongada, raciocínio difícil, decisões críticas |
| Claude Sonnet 5.5 | Modelo principal do trabalho quotidiano | Alterações de código, geração de documentos, análise, trabalho de conhecimento em vários passos |
| Claude Haiku 5.5 | Camada de execução de chamadas frequentes | Classificação, extração, resumo, compressão, encaminhamento, navegador e tarefas de subagente |
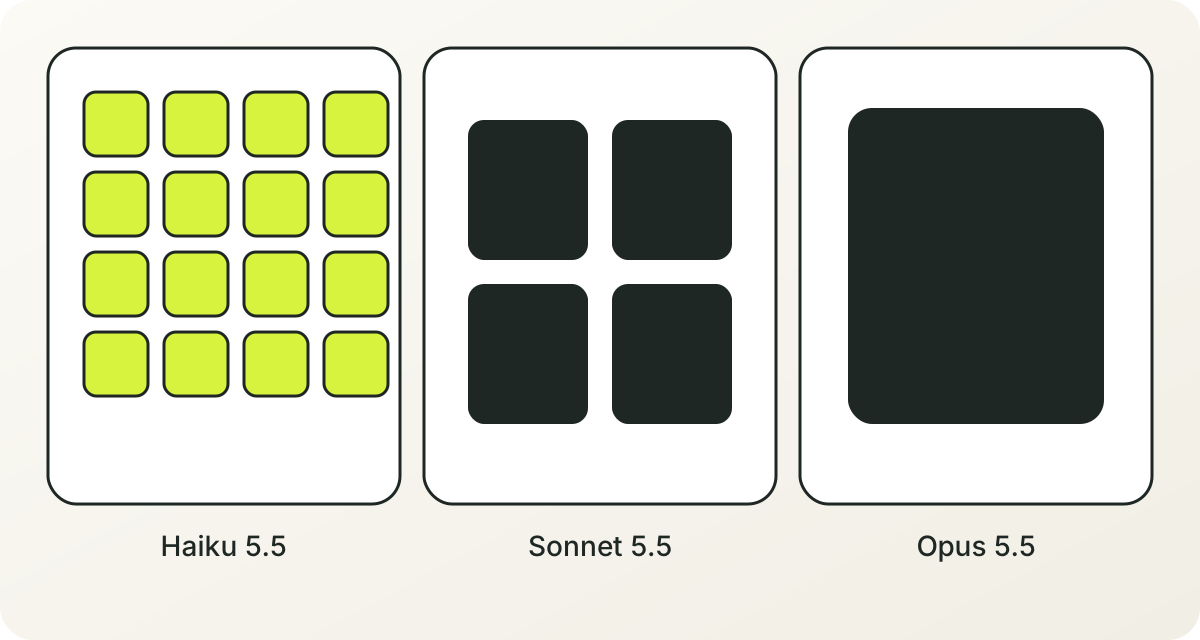
A visão geral de modelos da Anthropic usa um posicionamento semelhante. O Opus 5.5 destina-se à programação de agentes de longa duração e ao trabalho de conhecimento. O Sonnet 5.5 sublinha o equilíbrio entre velocidade e inteligência. O Haiku 5.5 destina-se a tarefas de classificação, extração e encaminhamento de alta concorrência e baixa latência.
Isto significa que a vantagem do Haiku 5.5 não tem de aparecer como «mais forte do que um modelo médio em tudo». É mais provável que apareça noutro lugar: se consegue transformar um grande número de tarefas locais que não valiam a pena ser automatizadas, por causa do custo, da latência ou da capacidade de processamento, em passos de sistema que podem continuar a correr.
Um preço mais baixo muda a forma de fazer as chamadas
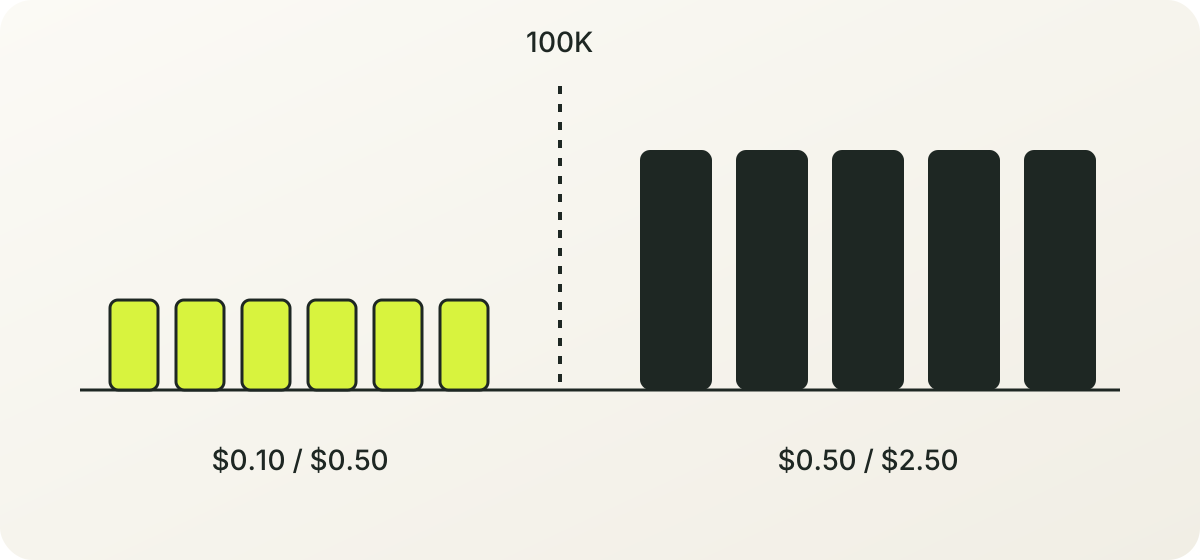
O preço oficial do Haiku 5.5 tem de ser entendido em dois intervalos. Para os pedidos cujo prompt de entrada não ultrapassa os 100K tokens, o preço de entrada é $0.10 por milhão de tokens e o de saída é $0.50 por milhão de tokens. Acima de 100K tokens, esses preços passam a ser $0.50 e $2.50.
| Dimensão do pedido | Entrada | Saída | Cache read |
|---|---|---|---|
| Até 100K tokens | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| Acima de 100K tokens | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
Há dois pormenores fáceis de ignorar.
Primeiro, uma descida do preço unitário e uma descida do custo real não são a mesma coisa. O «custo médio de execução cerca de 75% mais baixo» da Anthropic já inclui a mudança no uso de tokens trazida pelo novo tokenizer. Não basta dividir o preço por milhão de tokens do modelo novo pelo do antigo para inferir que a fatura do produto desce na mesma proporção.
Segundo, o facto de o modelo concluir ou não a tarefa com sucesso altera o custo real. Uma chamada pode ser barata, mas, se precisar de novas tentativas, de um fallback para Sonnet ou de mais revisão humana, o custo final da tarefa pode continuar alto.
Por isso, as equipas de produto deviam prestar mais atenção a esta medida:
Custo por tarefa bem-sucedida
= despesa total em modelos e ferramentas para concluir as tarefas ÷ número de tarefas concluídas com sucesso
Se se comparam arquiteturas com mais detalhe, também há que meter na fatura total as novas tentativas, o fallback, as chamadas a ferramentas e a tomada de controlo humana.
Uma das mudanças mais importantes do Haiku 5.5 é o effort tornar-se regulável
O Haiku 5.5 é o primeiro modelo da série Haiku a oferecer um effort regulável. Esse ajuste faz com que a «escolha de modelo» deixe de ser o único interruptor de custo. O sistema também pode ajustar, dentro do mesmo modelo, quanto raciocínio investe.
Pode entender-se como os modos de condução de um carro:
- Para classificação simples e conversão de formato, usar um effort mais baixo e dar prioridade à velocidade e ao baixo custo.
- Para extração estruturada e compressão de textos longos, usar um effort médio e equilibrar qualidade e despesa.
- Para tarefas que precisam de julgamento em vários passos, aumentar o effort.
- Se a tarefa continuar a falhar, passar então para Sonnet ou Opus.
Isto dá uma fórmula de decisão nova:
Resultado final = modelo × effort × contexto × ferramentas × política de nova tentativa
Por isso, ao comparar modelos daqui em diante, não basta perguntar «quem é mais forte, Haiku 5.5 ou Sonnet 5.5». Também é preciso perguntar:
- Na mesma tarefa, que nível de effort compensa mais?
- A subida de qualidade de um effort mais alto cobre o custo extra?
- Numa tarefa simples, aumentar o effort apenas prolonga o tempo de espera?
- Compensa mais deixar o Haiku tentar mais uma vez, ou chamar o Sonnet uma única vez?
Por isso o Haiku 5.5 avalia-se melhor pelo custo ao nível da tarefa do que pela impressão de uma única saída.
Os agentes podem passar de «um modelo grande que faz tudo» a uma colaboração em camadas
Antes, a estrutura de muitos agentes parecia-se com isto: depois de o utilizador fazer um pedido, um modelo grande encarrega-se de planear, recuperar, chamar as ferramentas, organizar os resultados e dar a resposta final.
Pedido do utilizador → o modelo grande planeia → o modelo grande pesquisa → o modelo grande resume → o modelo grande responde
Essa estrutura é simples, mas faz com que cada ação local use o mesmo modelo caro. Para um agente que tem de pesquisar dezenas de documentos, processar centenas de registos ou chamar o navegador repetidamente, o custo e a latência acumulam-se depressa.
O Haiku 5.5 encaixa melhor numa arquitetura em camadas como esta:
Pedido do utilizador
   ↓
Sonnet ou Opus decompõe a tarefa e elabora o plano
   ↓
Haiku 5.5 pesquisa, classifica, extrai, resume e faz chamadas a ferramentas de um só passo
   ↓
Sonnet ou Opus revê os resultados e toma a decisão final
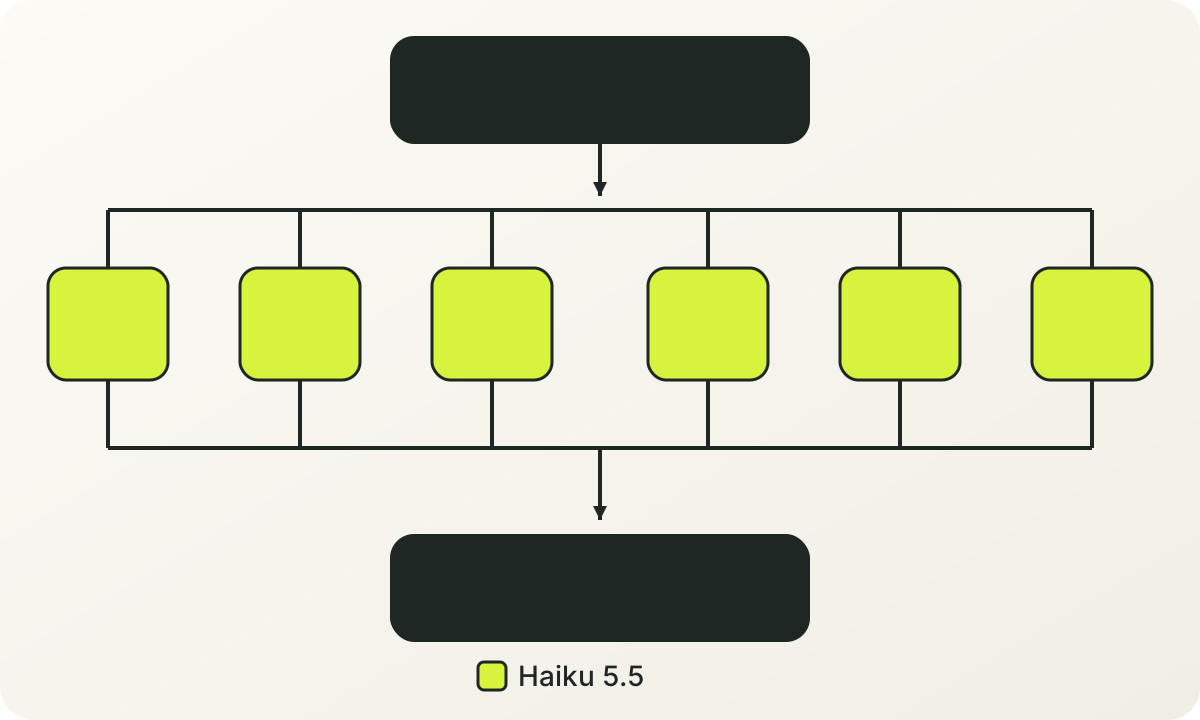
Nesta estrutura, o valor do Haiku 5.5 não é concluir sozinho a tarefa mais complexa, mas tornar-se a «camada de trabalhadores» do agente. Trata do trabalho local mais numeroso, de estrutura relativamente clara e que pode ser verificado.
Trabalho que convém entregar ao Haiku 5.5
- Encaminhar o pedido do utilizador para fluxos de trabalho diferentes.
- Extrair campos fixos de um documento ou de alguns documentos.
- Classificar tickets e ordená-los por prioridade.
- Comprimir uma conversa longa no contexto de que a volta seguinte do agente precisa.
- Tirar duplicados dos resultados de pesquisa e fazer um resumo preliminar.
- Executar uma ação explícita no navegador.
- Verificar o formato do código, gerar um teste simples ou explicar um trecho local de código.
- Concluir um pequeno trecho de trabalho como subagente de Sonnet ou Opus.
Trabalho que não deve ser entregue ao Haiku 5.5 por predefinição
- Projetos complexos que precisam de planeamento de longo horizonte.
- Alterações de código que tocam em vários ficheiros, várias dependências e várias rondas de comentários.
- Decisões críticas em que um único erro traz uma perda elevada.
- Trabalho que tem de manter um estado complexo ao longo de um processo longo.
- Tarefas sem meio de verificação automática, que só podem depender de um julgamento humano.
O essencial não é colar ao modelo a etiqueta «consegue» ou «não consegue», mas avaliar o custo de a tarefa falhar. Nas tarefas que podem ser verificadas automaticamente e repetidas depois de uma falha, a relação entre preço e resultado do Haiku 5.5 torna-se mais atrativa. Nas tarefas em que a falha sai muito cara, Sonnet ou Opus continuam a ser a opção mais segura.
Como pode um programador comum escolher entre os três modelos
Pode começar-se com um encaminhamento simples segundo a complexidade da tarefa e o custo da falha:
| Traço da tarefa | Escolha predefinida | Condição para subir |
|---|---|---|
| Formato de saída fixo e verificável de forma automática | Haiku 5.5 | Erros de formato seguidos, ou falta um campo essencial |
| Muito volume de chamadas e sensibilidade à latência | Haiku 5.5 | A latência p95 ou a taxa de falhas ultrapassa o limiar do produto |
| É preciso resumo, compressão, classificação ou extração | Haiku 5.5 | Surge raciocínio entre documentos ou um conflito de contexto |
| Trabalho de conhecimento corrente e alterações de código | Sonnet 5.5 | A tarefa abrange um horizonte longo ou precisa de várias rondas de planeamento |
| Agentes complexos e programação de longo horizonte | Sonnet 5.5 ou Opus 5.5 | A tolerância ao erro é muito baixa, ou é preciso raciocínio profundo |
| Julgamento de alto risco e revisão final | Sonnet 5.5 ou Opus 5.5 | Decide-se segundo o custo do erro e a capacidade de verificação |
Esta tabela não deve ser tomada como uma resposta fixa para sempre. Antes de passar mesmo à produção, há que medir, com o próprio conjunto de tarefas, o ponto em que cada nível de modelo se separa na taxa de sucesso, na latência e no custo por tarefa bem-sucedida.
100K tokens é uma fronteira de preço a que é preciso prestar atenção
O preço anunciado do Haiku 5.5 é muito baixo, mas depois de 100K tokens o preço sobe de forma clara. Em aplicações de documentos longos, repositórios de código e conversas longas, a equipa não pode olhar apenas para o preço de partida publicado do modelo.
Um fluxo de trabalho de contexto longo pode dividir-se nestes passos:
- Criar a cache na primeira leitura do documento.
- Usar o Haiku 5.5 para comprimir o contexto.
- Entregar ao Sonnet apenas os trechos relacionados com a pergunta atual.
- Guardar os resultados intermédios como estado estruturado.
- Evitar voltar a enviar o histórico completo em cada volta.
Este fluxo tem duas vantagens. Baixa a probabilidade de cruzar o intervalo de preço dos 100K, e deixa que modelos diferentes assumam trabalhos diferentes.
Por isso, o valor de contexto longo do Haiku 5.5 não se pode medir apenas com «quantos tokens consegue ler no máximo». As perguntas mais práticas são:
- Quanto conteúdo em bruto é preciso meter no modelo.
- Que conteúdo deve ser comprimido primeiro.
- Qual é a taxa de acertos da cache.
- Se o preço acima de 100K continua aceitável.
- Se a perda de informação devida à compressão pode fazer falhar uma tarefa posterior.
O lançamento do Haiku 5.5 também muda o foco da avaliação de modelos
A página oficial já oferece várias pontuações, entre elas GDPval-AA, OSWorld, Humanity's Last Exam e Terminal-Bench. Ajudam o leitor a ter uma ideia do intervalo aproximado de capacidade do modelo, mas a equipa de produto continua a precisar de testes sobre as suas próprias tarefas.
Num sistema real, o que mais merece observação não é a pontuação isolada de um modelo num benchmark, mas este conjunto de medidas:
- Taxa de sucesso da tarefa.
- Qualidade da saída.
- Latência p50 e p95.
- Número de tokens de entrada e de saída.
- Taxa de nova tentativa.
- Taxa de erro nas chamadas a ferramentas.
- Taxa de fallback.
- Taxa de tomada de controlo humana.
- Custo por tarefa bem-sucedida.
Há que prestar atenção especial à estabilidade entre repetições. Uma resposta atraente a um mesmo Prompt só mostra que essa execução teve sucesso. Não mostra diretamente que o modelo vá concluir de forma estável o mesmo tipo de tarefa em produção.
Uma forma de teste mais fiável é esta:
- Preparar um conjunto de amostras independentes para cada tipo de tarefa.
- Executá-las com o mesmo prompt de sistema, o mesmo contexto, as mesmas definições de ferramentas e a mesma região.
- Repetir cada amostra várias vezes.
- Julgar os resultados com regras, testes ocultos ou uma revisão humana cega.
- Reportar a taxa de sucesso e o intervalo de confiança.
- Listar à parte os piores casos e os tipos de falha.
Este método acaba por levar a avaliação do modelo de «qual saída foi a melhor» para «se este sistema consegue continuar a concluir o trabalho».
O que significa o Haiku 5.5 para um utilizador individual
Um utilizador individual talvez não sinta de forma direta a mudança do preço unitário da API, mas pode entender o lugar do Haiku 5.5 a partir de três ângulos.
Primeiro, encaixa melhor em tarefas rápidas, repetidas e de limite claro, como organizar texto, extrair informação, gerar um rascunho estruturado e tratar um grande número de problemas pequenos.
Segundo, não tem de substituir todos os modelos mais avançados. A escrita complexa, o planeamento de longo horizonte, o código difícil e o trabalho que precisa de manter o estado de forma contínua continuam a depender mais de Sonnet ou Opus.
Terceiro, a diferença entre modelos parece-se cada vez mais com uma «diferença de modo de trabalhar», e não com uma simples diferença de mais alto ou mais baixo. Ao escolher um modelo, há que olhar primeiro para a frequência da tarefa, a latência que exige, o custo de um erro e o meio de verificação, e só depois para a capacidade de uma única chamada.
Para uma equipa de produto, o que é preciso recalcular é a economia por unidade de tarefa
O Haiku 5.5 torna mais fácil experimentar muitos passos que antes não valiam a pena ser automatizados:
- Mais uma camada de classificação da entrada.
- Mais uma passagem que comprime os resultados da recuperação.
- Mais um subagente, dedicado aos documentos.
- Mais uma verificação, de baixo custo, da saída.
- Mais uma verificação estruturada antes da resposta final.
Esses passos acrescentados aumentam por si mesmos o número de chamadas. Se conseguirem baixar a taxa final de falhas, o custo do produto no conjunto pode na mesma descer.
Por isso o «preço de uma única chamada ao modelo» não chega. O que uma equipa de produto tem de comparar de verdade é:
Custo de uma chamada
→ custo total de uma tarefa
→ custo total de uma tarefa bem-sucedida
→ custo total de um resultado entregável
Quando o Haiku 5.5 é barato o suficiente, o sistema pode ter capacidade de trocar várias tarefas pequenas por uma fiabilidade final mais alta. Essa mudança afeta o desenho do agente, a estrutura de margem do produto e que trabalho a equipa decide entregar ao modelo para que o conclua automaticamente.
Fecho: o Haiku 5.5 é uma mudança de arquitetura
O lançamento do Haiku 5.5 pode entender-se como uma melhoria de um modelo pequeno. Também pode entender-se como um avanço da Anthropic na forma do produto de modelos.
Põe três perguntas na mesma folha de decisão:
- Quanta inteligência precisa esta tarefa.
- Quanta latência pode esta tarefa suportar.
- Quanto dinheiro merece esta tarefa.
Quando a escolha de modelo se junta ao encaminhamento de tarefas, ao effort, à cache, às novas tentativas e à tomada de controlo humana, «qual modelo é o mais forte» deixa de ser a única pergunta. A pergunta mais importante passa a ser:
Que modelo deve tratar cada tipo de chamada, e como se obtém um resultado suficientemente fiável ao custo de ponta a ponta mais baixo?
O sentido do Haiku 5.5 talvez esteja em tornar esta pergunta, pela primeira vez, barata o suficiente para merecer ser feita em grande escala.