Haiku 5.5: Anthropic превращает способность модели в систему разделения труда
Ценность Claude Haiku 5.5 не только в том, что он отвечает быстрее и дешевле, а в том, что он начинает превращать вызовы модели в инфраструктуру, которую можно развёртывать в большом масштабе.
Haiku 5.5: Anthropic превращает способность модели в систему разделения труда
Ценность Claude Haiku 5.5 не только в том, что он отвечает быстрее и дешевле, а в том, что он начинает превращать вызовы модели в инфраструктуру, которую можно развёртывать в большом масштабе.
Anthropic выпустила Claude Haiku 5.5 7 октября 2026 года. Сначала о названии, которое легко перепутать: в публичных официальных материалах Anthropic название модели — Claude Haiku 5.5, идентификатор модели — claude-haiku-5-5, и официальной модели с именем "Claude Hiya 5.5" нет. В этой статье везде используется Haiku 5.5.
Позиция Anthropic однозначна: это небольшая модель для задач с большим числом одновременных запросов, низкой задержкой и чувствительностью к стоимости, подходящая для классификации, извлечения информации, суммаризации, сжатия контекста, запросов к базам данных, действий в браузере и подзадач агента. По заявлению компании, средняя стоимость работы Haiku 5.5 примерно на 75% ниже, чем у Haiku 4.5; это также первая модель семейства Haiku с настраиваемым параметром effort.
Из-за этого вопрос о Haiku 5.5 меняется с «это ещё одна более сильная маленькая модель?» на более практический: когда модель достаточно дешёвая, чтобы её вызывали в больших объёмах, что меняется в разделении труда между моделями в AI-продукте?
Семейство Claude 5.5 формирует ясное разделение труда
Если смотреть только на названия моделей, легко принять Opus, Sonnet и Haiku за три места на одной шкале способностей. Точнее понимать так: они формируют разделение труда между моделями под разные рабочие нагрузки.
| Модель | Более подходящая роль | Типичные задачи |
|---|---|---|
| Claude Opus 5.5 | Эксперт по сложным задачам и планировщик на длинном горизонте | Сложные агенты, длительное программирование, трудные рассуждения, критические решения |
| Claude Sonnet 5.5 | Основная модель для повседневной работы | Изменения кода, генерация документов, анализ, многошаговая работа со знаниями |
| Claude Haiku 5.5 | Исполнительный слой частых вызовов | Классификация, извлечение, суммаризация, сжатие, маршрутизация, браузер и задачи субагентов |
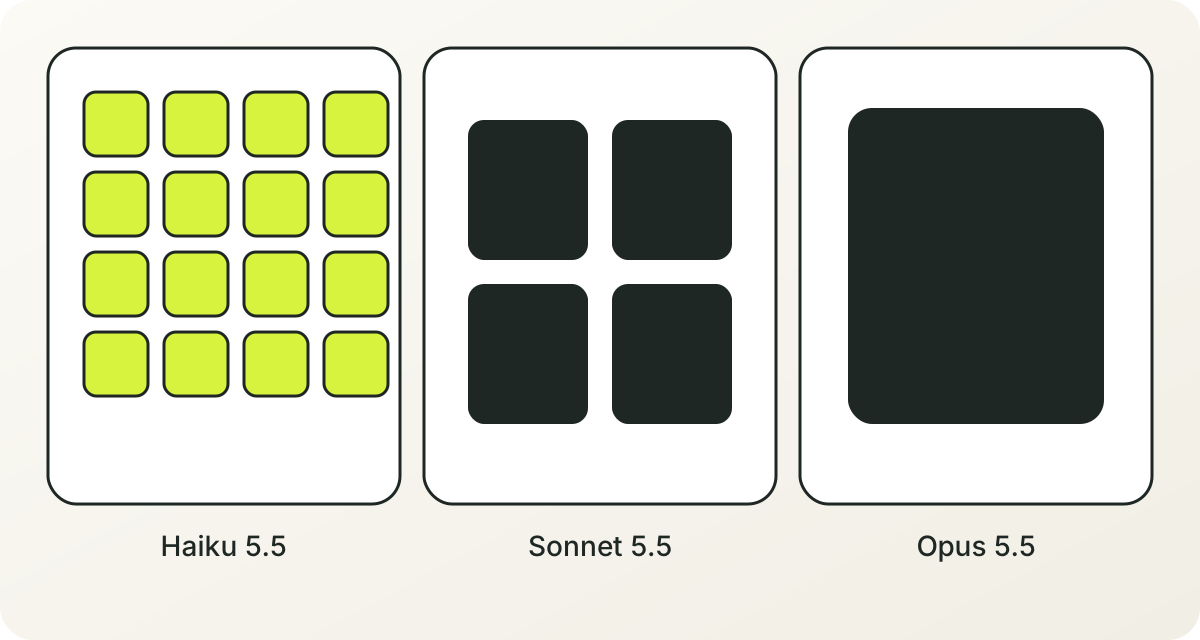
Обзор моделей Anthropic использует похожее размещение: Opus 5.5 — для длительного агентного программирования и работы со знаниями, Sonnet 5.5 подчёркивает баланс скорости и интеллекта, Haiku 5.5 — для классификации, извлечения и маршрутизации при большом числе одновременных запросов и низкой задержке.
Это значит, что преимущество Haiku 5.5 не обязательно выглядит как «сильнее средней модели во всём». Оно скорее проявляется в другом: может ли она превратить множество локальных задач, которые раньше не стоило автоматизировать из-за стоимости, задержки или пропускной способности, в шаги системы, способные работать постоянно.
Снижение цены меняет способ вызовов
Официальную цену Haiku 5.5 нужно понимать как два диапазона. Для запросов, входной prompt которых не превышает 100K tokens, цена входа — $0.10 за миллион tokens, цена выхода — $0.50 за миллион tokens; после превышения 100K tokens цены составляют $0.50 и $2.50.
| Размер запроса | Вход | Выход | Cache read |
|---|---|---|---|
| Не более 100K tokens | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| Более 100K tokens | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
Здесь легко упустить две детали.
Во-первых, снижение цены за единицу и снижение реальной стоимости — не одно и то же. Формулировка Anthropic «средняя стоимость работы ниже примерно на 75%» уже учитывает изменение расхода tokens из-за нового tokenizer. Иначе говоря, нельзя просто разделить цены старой и новой модели за миллион tokens и сделать вывод, что счёт продукта снизится в той же пропорции.
Во-вторых, на реальную стоимость влияет то, успешно ли модель завершает задачу. Один вызов может быть дешёвым, но если нужны повторы, откат к Sonnet или дополнительная ручная проверка, итоговая стоимость задачи всё равно может оказаться высокой.
Поэтому продуктовой команде важнее следить за таким показателем:
Стоимость каждой успешной задачи
= общие расходы на модели и инструменты, чтобы завершить задачи ÷ число успешно завершённых задач
Если сравнивать архитектуры дальше, в общий счёт также нужно включить повторы, fallback, вызовы инструментов и передачу человеку.
Одно из важнейших изменений Haiku 5.5 — настраиваемый effort
Haiku 5.5 — первая модель семейства Haiku с настраиваемым effort. Эта настройка делает «выбор модели» не единственным переключателем стоимости: внутри одной и той же модели система может менять объём рассуждения.
Это можно понимать как режимы вождения автомобиля:
- Для простой классификации и преобразования формата используйте более низкий effort и отдавайте приоритет скорости и низкой стоимости.
- Для структурированного извлечения и сжатия длинного текста используйте средний effort и балансируйте качество и расходы.
- Для задач, которым нужно многошаговое суждение, повышайте effort.
- Если задача по-прежнему не удаётся, переходите к Sonnet или Opus.
Отсюда новая формула решения:
Итоговый результат = модель × effort × контекст × инструменты × стратегия повторов
Поэтому при дальнейшем сравнении моделей нельзя спрашивать только «кто сильнее, Haiku 5.5 или Sonnet 5.5?». Нужно спрашивать ещё:
- На одной и той же задаче какой уровень effort выгоднее?
- Покрывает ли прирост качества от более высокого effort дополнительную стоимость?
- На простой задаче более высокий effort только удлиняет ожидание?
- Выгоднее дать Haiku ещё одну попытку или один раз вызвать Sonnet?
Поэтому Haiku 5.5 лучше оценивать по стоимости на уровне задачи, а не по впечатлению от одного вывода.
Агенты могут перейти от «одна большая модель делает всё» к слоистому сотрудничеству
Раньше структура многих агентов была примерно такой: после запроса пользователя одна большая модель планирует, ищет, вызывает инструменты, приводит результаты в порядок и даёт итоговый ответ.
Запрос пользователя → большая модель планирует → большая модель ищет → большая модель суммирует → большая модель отвечает
Такая структура проста, но каждый локальный шаг использует одну и ту же дорогую модель. Для агента, которому нужно искать десятки документов, обрабатывать сотни записей или многократно вызывать браузер, стоимость и задержка быстро накапливаются.
Haiku 5.5 лучше входит в такую слоистую архитектуру:
Запрос пользователя
   ↓
Sonnet или Opus разбирает задачу и составляет план
   ↓
Haiku 5.5 ищет, классифицирует, извлекает, суммирует и делает одношаговые вызовы инструментов
   ↓
Sonnet или Opus проверяет результаты и принимает итоговое решение
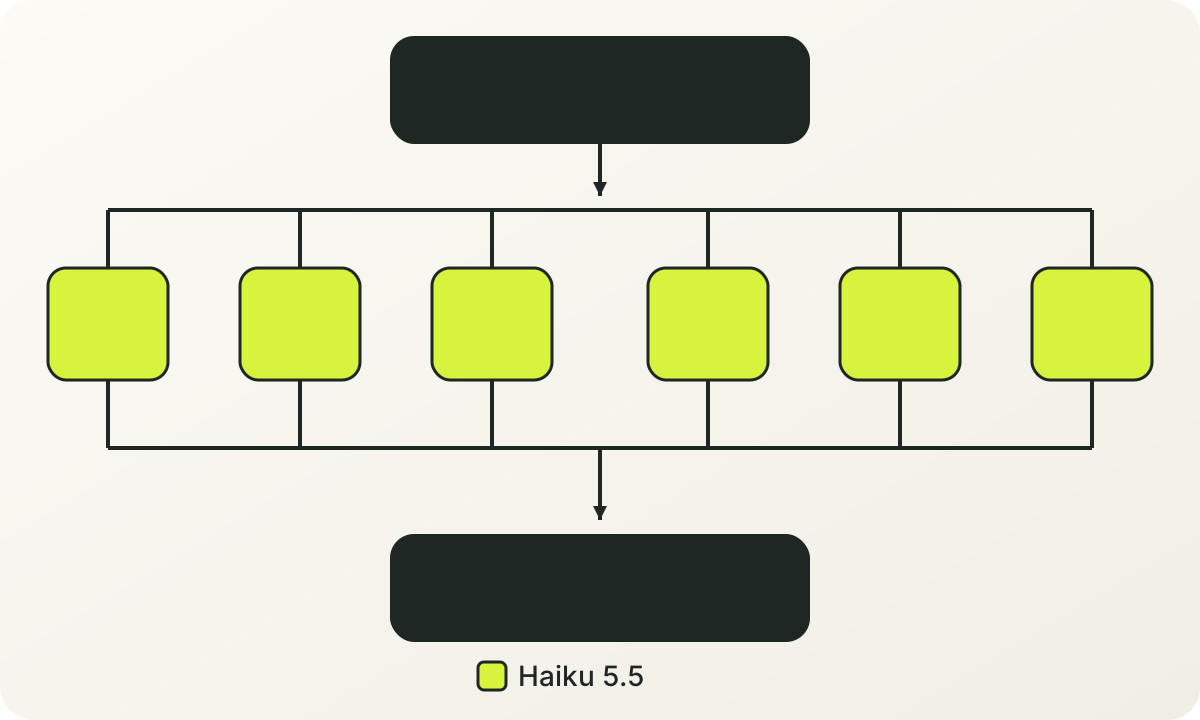
В такой структуре ценность Haiku 5.5 не в том, чтобы самостоятельно выполнить самую сложную задачу, а в том, чтобы стать «рабочим слоем» агента. Он берёт локальную работу, которой больше всего, которая относительно ясна по структуре и которую можно проверить.
Какая работа подходит для Haiku 5.5
- Направлять запрос пользователя в разные рабочие процессы.
- Извлекать фиксированные поля из одного документа или нескольких документов.
- Классифицировать заявки и задавать их приоритет.
- Сжимать длинный диалог в контекст, нужный следующему ходу агента.
- Убирать дубликаты из результатов поиска и писать первичное резюме.
- Выполнять одно явное действие в браузере.
- Проверять форматирование кода, генерировать простой тест или объяснять локальный фрагмент кода.
- Как субагент Sonnet или Opus завершать короткий участок работы.
Какую работу не следует по умолчанию отдавать Haiku 5.5
- Сложные проекты, которым нужно планирование на длинном горизонте.
- Изменения кода, которые затрагивают много файлов, много зависимостей и несколько кругов обратной связи.
- Критические решения, где одна ошибка приносит заметный ущерб.
- Работа, которой нужно удерживать сложное состояние на протяжении долгого процесса.
- Задачи без автоматической проверки, где остаётся полагаться только на человеческое суждение.
Суть не в том, чтобы наклеить на модель ярлык «может» или «не может», а в том, чтобы оценить цену неудачи задачи. Для задач, которые можно проверить автоматически и повторить после неудачи, соотношение цены и качества у Haiku 5.5 привлекательнее; для задач, где цена неудачи высока, Sonnet или Opus по-прежнему надёжнее.
Как обычному разработчику выбирать среди трёх уровней моделей
Можно начать с простой маршрутизации по сложности задачи и цене неудачи:
| Признак задачи | Выбор по умолчанию | Условие перехода выше |
|---|---|---|
| Фиксированный формат вывода, можно проверить автоматически | Haiku 5.5 | Повторяющиеся ошибки формата или отсутствует ключевое поле |
| Большой объём вызовов, чувствительность к задержке | Haiku 5.5 | Задержка p95 или доля неудач превышает порог продукта |
| Нужны суммаризация, сжатие, классификация, извлечение | Haiku 5.5 | Появляется рассуждение между документами или конфликт контекста |
| Обычная работа со знаниями и изменения кода | Sonnet 5.5 | Задача охватывает длинный горизонт или нужно несколько кругов планирования |
| Сложные агенты и программирование на длинном горизонте | Sonnet 5.5 или Opus 5.5 | Очень низкая терпимость к ошибкам или нужно глубокое рассуждение |
| Высокорисковое суждение и итоговая проверка | Sonnet 5.5 или Opus 5.5 | Решать по цене ошибки и по возможности проверки |
Эту таблицу не следует считать ответом, который фиксирован навсегда. Перед настоящим запуском в производственную среду нужно на собственном наборе задач найти границу каждого уровня модели по доле успеха, задержке и стоимости каждой успешной задачи.
100K tokens — ценовая граница, за которой нужно следить
Заявленная цена Haiku 5.5 низкая, но после 100K tokens она заметно вырастает. Командам, которые делают приложения на длинных документах, репозиториях кода и длинных диалогах, нельзя смотреть только на опубликованную стартовую цену модели.
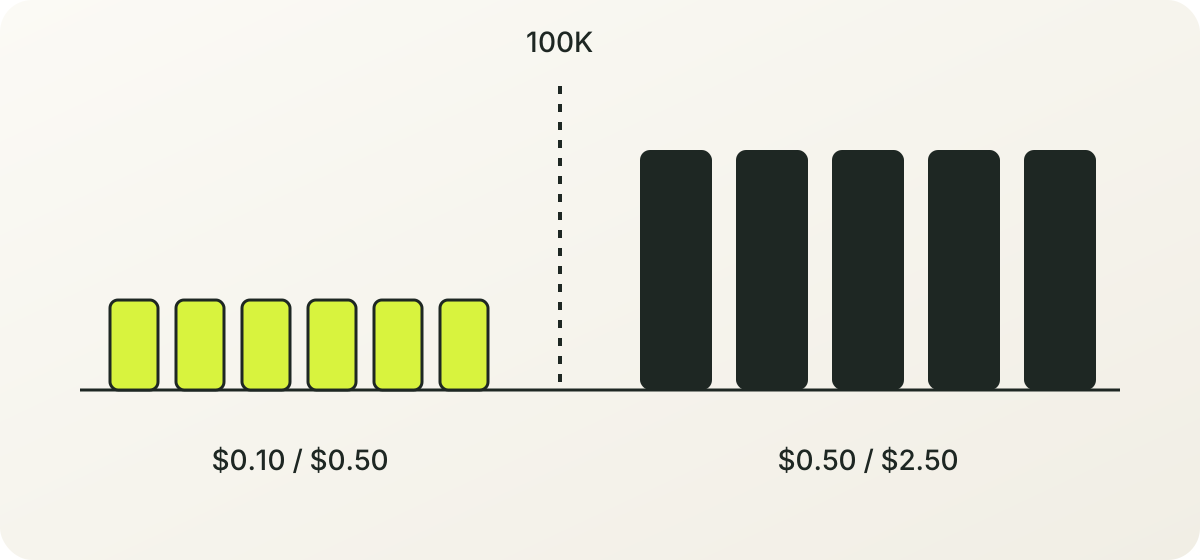
Рабочий процесс с длинным контекстом можно разбить на несколько шагов:
- При первом чтении документа создайте кэш.
- Сожмите контекст с помощью Haiku 5.5.
- Передавайте Sonnet только фрагменты, относящиеся к текущему вопросу.
- Сохраняйте промежуточные результаты как структурированное состояние.
- Не отправляйте полную историю заново на каждом ходе.
У этого процесса два плюса: он снижает вероятность пересечь ценовой диапазон 100K и позволяет разным моделям нести разную работу.
Поэтому ценность длинного контекста у Haiku 5.5 нельзя измерять только тем, «сколько tokens она может прочитать». Более практичные вопросы такие:
- Сколько исходного материала нужно поместить в модель.
- Какой материал следует сжать первым.
- Какова доля попаданий в кэш.
- Приемлема ли цена после превышения 100K.
- Может ли потеря информации из-за сжатия привести к неудаче последующей задачи.
Выпуск Haiku 5.5 также меняет акцент оценки моделей
На официальной странице уже есть результаты GDPval-AA, OSWorld, Humanity's Last Exam, Terminal-Bench и другие. Они помогают читателю увидеть примерный диапазон способностей модели, но продуктовой команде по-прежнему нужны тесты на собственных задачах.
В реальной системе наблюдать стоит не один результат модели на каком-то одном бенчмарке, а следующий набор показателей:
- Доля успешных задач.
- Качество вывода.
- Задержка p50 и p95.
- Число входных и выходных tokens.
- Доля повторов.
- Доля ошибок вызова инструментов.
- Доля fallback.
- Доля передачи человеку.
- Стоимость каждой успешной задачи.
Особенно важна стабильность при повторных запусках. Один красивый ответ на один и тот же Prompt показывает только, что этот запуск удался. Он не показывает напрямую, что в производственной среде модель будет стабильно выполнять задачи того же типа.
Более надёжный способ тестирования такой:
- Подготовьте независимый набор образцов для каждого вида задач.
- Запускайте их при одном и том же системном prompt, контексте, определениях инструментов и регионе.
- Повторяйте каждый образец несколько раз.
- Оценивайте результаты правилами, скрытыми тестами или слепой проверкой человеком.
- Сообщайте долю успеха и доверительный интервал.
- Отдельно перечисляйте худшие случаи и типы неудач.
Этот метод в итоге переводит оценку модели с вопроса «какой вывод был лучшим» на вопрос «может ли эта система продолжать выполнять работу».
Что Haiku 5.5 значит для индивидуального пользователя
Индивидуальный пользователь может не ощутить напрямую изменение цены единицы API, но место Haiku 5.5 можно понять с трёх сторон.
Во-первых, он лучше подходит для быстрых, повторяющихся задач с ясной границей, например для упорядочивания текста, извлечения информации, генерации структурированного черновика и обработки большого числа мелких вопросов.
Во-вторых, он не обязательно подходит для замены всех более сильных моделей. Сложное письмо, планирование на длинном горизонте, трудный код и работа, которой нужно непрерывно удерживать состояние, по-прежнему больше зависят от Sonnet или Opus.
В-третьих, различия между моделями всё больше похожи на «различия в способе работы», а не на простое различие выше или ниже. Выбирая модель, сначала смотрите на частоту задачи, требования к задержке, цену ошибки и способ проверки, и только потом — на способность одного вызова.
Продуктовой команде нужно заново считать экономику единицы задачи
Haiku 5.5 облегчает попытки шагов, которые раньше не стоило автоматизировать:
- Ещё один слой классификации входа.
- Ещё один проход сжатия результатов поиска.
- Ещё один субагент, который специально обрабатывает документы.
- Ещё одна дешёвая проверка вывода.
- Ещё одна структурированная проверка перед итоговым ответом.
Сами эти новые шаги увеличивают число вызовов, но если они снижают итоговую долю неудач, общая стоимость продукта всё же может снизиться.
Поэтому одной «цены модели за один вызов» недостаточно. Продуктовой команде на самом деле нужно сравнивать вот это:
Стоимость одного вызова
→ общая стоимость одной задачи
→ общая стоимость одной успешной задачи
→ общая стоимость одного результата, который можно сдать
Когда Haiku 5.5 достаточно дёшев, система может обменять несколько малых задач на более высокую итоговую надёжность. Такое изменение влияет на проектирование агентов, структуру прибыли продукта и на то, какую работу команда решает отдать модели для автоматического выполнения.
Заключение: Haiku 5.5 — это изменение архитектуры
Выпуск Haiku 5.5 можно понимать как обновление маленькой модели, а можно — как шаг Anthropic вперёд в форме продукта моделей.
Он помещает три вопроса на один лист решений:
- Сколько интеллекта нужно этой задаче.
- Какую задержку эта задача может выдержать.
- Сколько денег стоит эта задача.
Когда выбор модели стоит рядом с маршрутизацией задач, effort, кэшем, повторами и передачей человеку, «какая модель самая сильная» перестаёт быть единственным вопросом. Более важный вопрос становится таким:
Какая модель должна обрабатывать какой вызов и как при наименьшей сквозной стоимости получить достаточно надёжный результат?
Смысл Haiku 5.5, возможно, в том, что он впервые делает этот вопрос достаточно дешёвым, чтобы его стоило задавать в большом масштабе.