Haiku 5.5: Anthropic đang biến năng lực mô hình thành một hệ thống phân công
Giá trị của Claude Haiku 5.5 không chỉ nằm ở việc nó trả lời nhanh hơn và rẻ hơn, mà ở chỗ nó bắt đầu biến việc gọi mô hình thành hạ tầng có thể được triển khai trên quy mô lớn.
Haiku 5.5: Anthropic đang biến năng lực mô hình thành một hệ thống phân công
Giá trị của Claude Haiku 5.5 không chỉ nằm ở việc nó trả lời nhanh hơn và rẻ hơn, mà ở chỗ nó bắt đầu biến việc gọi mô hình thành hạ tầng có thể được triển khai trên quy mô lớn.
Anthropic phát hành Claude Haiku 5.5 vào ngày 7 tháng 10 năm 2026. Trước hết cần nói rõ một tên dễ nhầm: trong tài liệu chính thức công khai của Anthropic, tên mô hình là Claude Haiku 5.5, ID mô hình là claude-haiku-5-5, và không có mô hình chính thức nào mang tên "Claude Hiya 5.5". Bài này thống nhất dùng Haiku 5.5.
Cách Anthropic đặt vị trí cho nó rất rõ. Đây là mô hình nhỏ cho tác vụ đồng thời cao, độ trễ thấp và nhạy với chi phí, phù hợp với phân loại, trích xuất thông tin, tóm tắt, nén ngữ cảnh, truy vấn cơ sở dữ liệu, thao tác trình duyệt và tác vụ con của Agent. Theo công bố chính thức, chi phí vận hành trung bình của Haiku 5.5 thấp hơn Haiku 4.5 khoảng 75%. Đây cũng là mô hình đầu tiên trong dòng Haiku có thiết lập effort điều chỉnh được.
Điều đó đổi câu hỏi về Haiku 5.5, từ “đây có phải lại là một mô hình nhỏ mạnh hơn”, thành một câu hỏi thực tế hơn: khi một mô hình rẻ đến mức có thể được gọi với số lượng lớn, sự phân công mô hình trong một sản phẩm AI sẽ thay đổi thế nào?
Dòng Claude 5.5 đang hình thành một sự phân công rõ
Nếu chỉ nhìn tên mô hình, rất dễ hiểu Opus, Sonnet và Haiku là ba vị trí trên cùng một bảng xếp hạng năng lực. Cách hiểu chính xác hơn là chúng đang hình thành một sự phân công mô hình cho các khối lượng công việc khác nhau.
| Mô hình | Vai trò phù hợp hơn | Tác vụ điển hình |
|---|---|---|
| Claude Opus 5.5 | Chuyên gia cho vấn đề phức tạp và người lập kế hoạch dài hạn | Agent phức tạp, lập trình kéo dài, suy luận khó, quyết định then chốt |
| Claude Sonnet 5.5 | Mô hình chủ lực cho công việc hằng ngày | Sửa mã, tạo tài liệu, phân tích, công việc tri thức nhiều bước |
| Claude Haiku 5.5 | Tầng thực thi được gọi với tần suất cao | Phân loại, trích xuất, tóm tắt, nén, định tuyến, trình duyệt và tác vụ của tác nhân con |
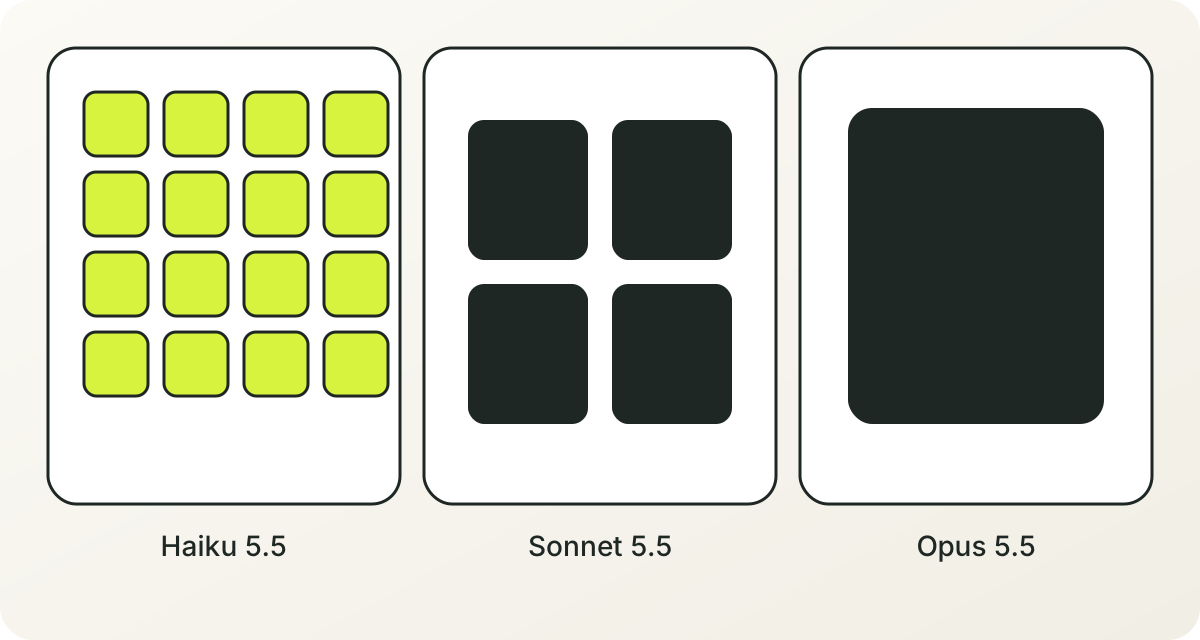
Phần tổng quan mô hình của Anthropic cũng dùng cách đặt vị trí tương tự. Opus 5.5 hướng tới lập trình Agent kéo dài và công việc tri thức. Sonnet 5.5 nhấn mạnh cân bằng giữa tốc độ và trí tuệ. Haiku 5.5 hướng tới phân loại, trích xuất và định tuyến với đồng thời cao, độ trễ thấp.
Điều đó có nghĩa lợi thế của Haiku 5.5 không nhất thiết thể hiện ở chỗ “mạnh hơn mô hình cỡ trung trong mọi việc”. Nó có nhiều khả năng thể hiện ở chỗ khác: liệu nó có biến được nhiều tác vụ cục bộ, vốn không đáng tự động hóa vì chi phí, độ trễ hoặc thông lượng, thành những bước hệ thống có thể chạy liên tục hay không.
Giá giảm làm thay đổi cách gọi
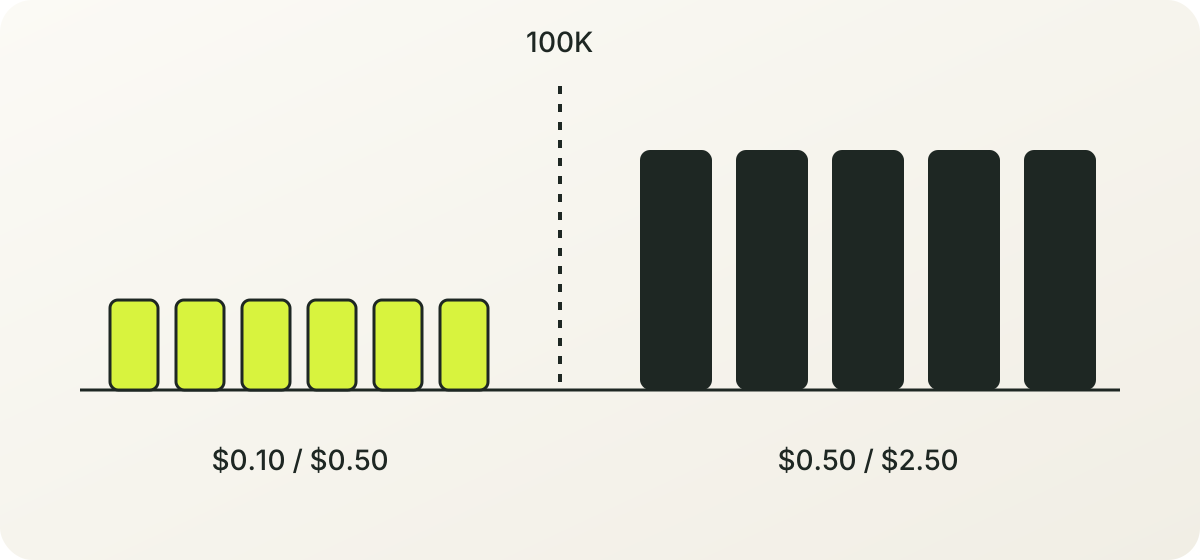
Giá chính thức của Haiku 5.5 cần được hiểu theo hai khoảng. Với yêu cầu có lời nhắc đầu vào không vượt quá 100K tokens, giá đầu vào là $0.10 cho mỗi triệu tokens và giá đầu ra là $0.50 cho mỗi triệu tokens. Vượt quá 100K tokens, các mức giá đó lần lượt là $0.50 và $2.50.
| Quy mô yêu cầu | Đầu vào | Đầu ra | Cache read |
|---|---|---|---|
| Không quá 100K tokens | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| Trên 100K tokens | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
Có hai chi tiết dễ bị bỏ qua.
Thứ nhất, đơn giá giảm và chi phí thực giảm không phải cùng một việc. Câu “chi phí vận hành trung bình thấp hơn khoảng 75%” của Anthropic đã tính đến thay đổi lượng dùng token do tokenizer mới. Nghĩa là không thể chỉ lấy đơn giá mỗi triệu token của mô hình mới và mô hình cũ đem chia cho nhau, rồi suy ra hóa đơn sản phẩm sẽ giảm cùng tỷ lệ đó.
Thứ hai, việc mô hình có hoàn thành tác vụ thành công hay không sẽ ảnh hưởng đến chi phí thực. Một lệnh gọi có thể rất rẻ, nhưng nếu nó cần thử lại, fallback sang Sonnet, hoặc thêm kiểm tra của người, chi phí cuối của tác vụ vẫn có thể cao.
Vì vậy, đội sản phẩm nên chú ý chỉ số này hơn.
Chi phí cho mỗi tác vụ thành công
= tổng chi phí mô hình và công cụ phát sinh khi hoàn thành tác vụ ÷ số tác vụ hoàn thành thành công
Nếu muốn so sánh thêm các kiến trúc khác nhau, còn phải đưa thử lại, fallback, lệnh gọi công cụ và việc người tiếp quản vào tổng hóa đơn.
Một trong những thay đổi quan trọng nhất của Haiku 5.5 là effort điều chỉnh được
Haiku 5.5 là mô hình đầu tiên trong dòng Haiku có effort điều chỉnh được. Thiết lập này khiến “chọn mô hình” không còn là công tắc chi phí duy nhất. Hệ thống còn có thể điều chỉnh lượng suy luận bỏ ra bên trong cùng một mô hình.
Có thể hiểu nó như các chế độ lái của một chiếc xe.
- Với phân loại đơn giản và chuyển đổi định dạng, dùng effort thấp hơn, ưu tiên tốc độ và chi phí thấp.
- Với trích xuất có cấu trúc và nén văn bản dài, dùng effort trung bình, cân bằng chất lượng và chi phí.
- Với tác vụ cần phán đoán nhiều bước, hãy nâng effort.
- Nếu tác vụ vẫn thất bại, hãy nâng lên Sonnet hoặc Opus.
Điều này mang đến một công thức quyết định mới.
Hiệu quả cuối = mô hình × effort × ngữ cảnh × công cụ × chiến lược thử lại
Vì vậy, khi so sánh mô hình về sau, không thể chỉ hỏi “Haiku 5.5 và Sonnet 5.5 bên nào mạnh hơn”, mà còn phải hỏi:
- Trên cùng một tác vụ, mức effort nào đáng giá nhất?
- Phần chất lượng tăng thêm khi nâng effort có bù được chi phí thêm không?
- Với tác vụ đơn giản, nâng effort có chỉ kéo dài thời gian chờ không?
- Để Haiku thử thêm một lần có lợi hơn, hay gọi Sonnet một lần có lợi hơn?
Đây cũng là lý do Haiku 5.5 phù hợp hơn khi được đánh giá bằng chi phí ở cấp tác vụ, chứ không phải bằng cảm nhận về một lần đầu ra.
Agent có thể đi từ “một mô hình lớn gánh hết” sang cộng tác theo tầng
Trước đây cấu trúc của nhiều Agent gần như thế này: sau khi người dùng đưa ra yêu cầu, một mô hình lớn đảm nhận lập kế hoạch, truy xuất, gọi công cụ, sắp xếp kết quả và câu trả lời cuối.
Yêu cầu của người dùng → mô hình lớn lập kế hoạch → mô hình lớn tìm kiếm → mô hình lớn tóm tắt → mô hình lớn xuất kết quả
Cấu trúc này đơn giản, nhưng khiến mọi hành động cục bộ đều dùng cùng một mô hình đắt. Với một Agent phải tìm hàng chục tài liệu, xử lý hàng trăm bản ghi hoặc gọi trình duyệt lặp lại, chi phí và độ trễ sẽ cộng dồn rất nhanh.
Haiku 5.5 phù hợp hơn khi đi vào kiểu kiến trúc phân tầng sau.
Yêu cầu của người dùng
   ↓
Sonnet hoặc Opus tách tác vụ và lập kế hoạch
   ↓
Haiku 5.5 đảm nhận tìm kiếm, phân loại, trích xuất, tóm tắt và lệnh gọi công cụ một bước
   ↓
Sonnet hoặc Opus rà soát kết quả và hoàn tất quyết định cuối
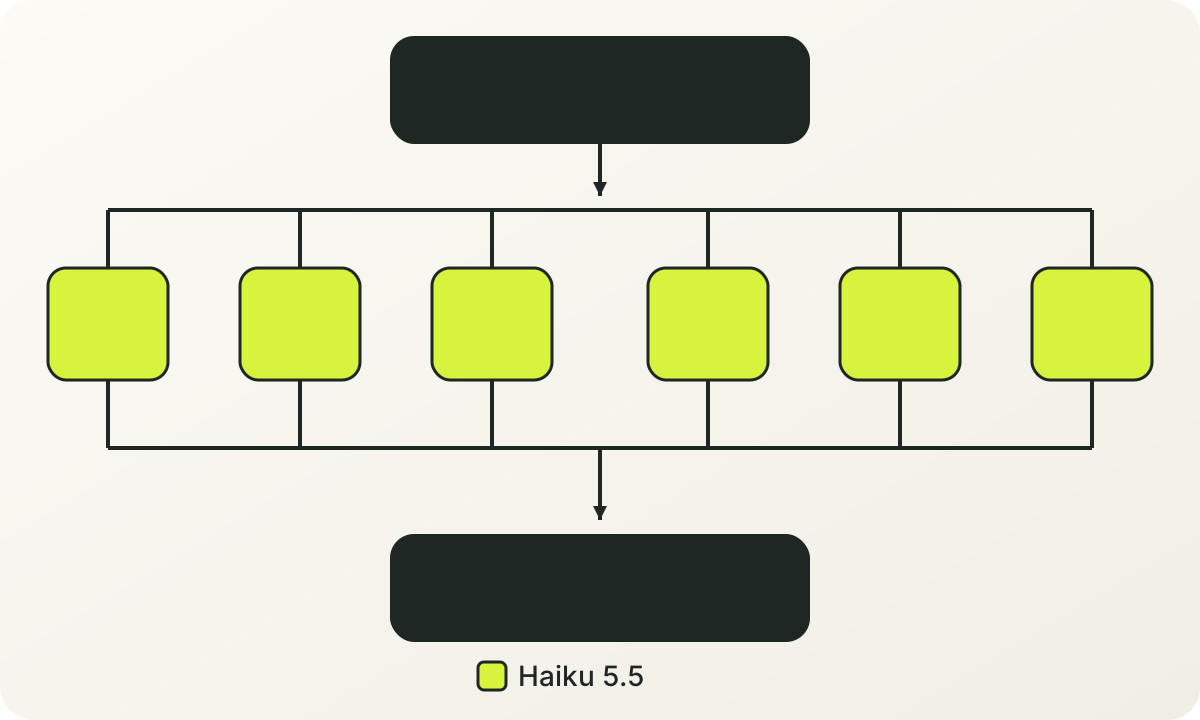
Trong cấu trúc này, giá trị của Haiku 5.5 không phải là tự hoàn thành tác vụ phức tạp nhất, mà là trở thành “tầng công nhân” của Agent. Nó xử lý phần việc cục bộ có số lượng nhiều nhất, cấu trúc tương đối rõ và có thể kiểm chứng.
Việc phù hợp để giao cho Haiku 5.5
- Định tuyến yêu cầu của người dùng vào các quy trình khác nhau.
- Trích xuất các trường cố định từ một hoặc vài tài liệu.
- Phân loại phiếu yêu cầu và sắp xếp mức ưu tiên.
- Nén một hội thoại dài thành ngữ cảnh mà lượt Agent tiếp theo cần.
- Khử trùng lặp kết quả tìm kiếm và viết bản tóm tắt sơ bộ.
- Thực hiện một thao tác trình duyệt rõ ràng.
- Kiểm tra định dạng mã, tạo một bài kiểm tra đơn giản, hoặc giải thích một đoạn mã cục bộ.
- Hoàn thành một đoạn việc ngắn với vai trò tác nhân con của Sonnet hoặc Opus.
Việc không nên mặc định giao cho Haiku 5.5
- Dự án phức tạp cần lập kế hoạch dài hạn.
- Sửa mã liên quan đến nhiều tệp, nhiều phụ thuộc và nhiều vòng phản hồi.
- Quyết định then chốt mà một lỗi gây tổn thất cao.
- Việc phải giữ trạng thái phức tạp xuyên suốt một quá trình làm việc rất dài.
- Tác vụ không có cách kiểm tra tự động, chỉ có thể dựa vào phán đoán của người.
Điểm then chốt ở đây không phải là dán nhãn “làm được” hoặc “không làm được” cho mô hình, mà là đánh giá cái giá sau khi tác vụ thất bại. Với tác vụ có thể kiểm tra tự động và thử lại sau khi thất bại, tỷ lệ giữa giá và kết quả của Haiku 5.5 hấp dẫn hơn. Với tác vụ mà cái giá của thất bại cao, Sonnet hoặc Opus vẫn vững hơn.
Nhà phát triển thông thường nên chọn ba mức mô hình như thế nào
Có thể bắt đầu bằng một lối định tuyến đơn giản theo độ phức tạp của tác vụ và cái giá của thất bại.
| Đặc điểm tác vụ | Lựa chọn mặc định | Điều kiện nâng cấp |
|---|---|---|
| Định dạng đầu ra cố định, có thể kiểm tra tự động | Haiku 5.5 | Lỗi định dạng liên tiếp hoặc thiếu trường then chốt |
| Lượng gọi lớn, nhạy với độ trễ | Haiku 5.5 | Độ trễ p95 hoặc tỷ lệ thất bại vượt ngưỡng của sản phẩm |
| Cần tóm tắt, nén, phân loại, trích xuất | Haiku 5.5 | Xuất hiện suy luận xuyên tài liệu hoặc xung đột ngữ cảnh |
| Công việc tri thức thông thường và sửa mã | Sonnet 5.5 | Tác vụ kéo dài hoặc cần nhiều vòng lập kế hoạch |
| Agent phức tạp và lập trình dài hạn | Sonnet 5.5 hoặc Opus 5.5 | Mức chịu lỗi rất thấp hoặc cần suy luận sâu |
| Phán đoán rủi ro cao và rà soát cuối | Sonnet 5.5 hoặc Opus 5.5 | Quyết định theo cái giá của lỗi và khả năng kiểm chứng |
Bảng này không nên bị xem là câu trả lời cố định mãi mãi. Trước khi thực sự đưa vào vận hành, hãy dùng tập tác vụ của chính mình để đo điểm phân tách của từng mức mô hình về tỷ lệ thành công, độ trễ và chi phí cho mỗi tác vụ thành công.
100K tokens là ranh giới giá cần đặc biệt chú ý
Giá được quảng bá của Haiku 5.5 rất thấp, nhưng sau 100K tokens giá sẽ tăng rõ rệt. Với ứng dụng tài liệu dài, kho mã và hội thoại dài, đội ngũ không thể chỉ nhìn giá khởi điểm đã công bố của mô hình.
Một quy trình ngữ cảnh dài có thể tách thành vài bước.
- Lập cache khi đọc tài liệu lần đầu.
- Dùng Haiku 5.5 để nén ngữ cảnh.
- Chỉ đưa cho Sonnet những đoạn liên quan đến câu hỏi hiện tại.
- Lưu kết quả trung gian thành trạng thái có cấu trúc.
- Tránh gửi lại toàn bộ lịch sử ở mỗi lượt.
Quy trình này có hai lợi ích. Nó hạ xác suất vượt khoảng giá 100K, và để các mô hình khác nhau gánh các phần việc khác nhau.
Vì vậy, giá trị ngữ cảnh dài của Haiku 5.5 không thể chỉ đo bằng “đọc được nhiều nhất bao nhiêu tokens”. Câu hỏi thực tế hơn là:
- Cần đưa bao nhiêu nội dung gốc vào mô hình.
- Nội dung nào nên được nén trước.
- Tỷ lệ trúng cache là bao nhiêu.
- Giá sau khi vượt 100K có còn chấp nhận được không.
- Thông tin mất đi vì nén có khiến tác vụ sau đó thất bại không.
Việc phát hành Haiku 5.5 cũng đổi trọng tâm của việc đánh giá mô hình
Trang chính thức đã cung cấp nhiều kết quả, trong đó có GDPval-AA, OSWorld, Humanity's Last Exam và Terminal-Bench. Chúng giúp người đọc nắm phạm vi năng lực khái quát của mô hình, nhưng đội sản phẩm vẫn cần bài kiểm tra trên tác vụ của chính mình.
Trong hệ thống thực, điều đáng quan sát nhất không phải một điểm đơn lẻ của một mô hình trên một chuẩn, mà là nhóm chỉ số sau.
- Tỷ lệ thành công của tác vụ.
- Chất lượng đầu ra.
- Độ trễ p50 và p95.
- Số token đầu vào và đầu ra.
- Tỷ lệ thử lại.
- Tỷ lệ lỗi khi gọi công cụ.
- Tỷ lệ fallback.
- Tỷ lệ người tiếp quản.
- Chi phí cho mỗi tác vụ thành công.
Đặc biệt cần chú ý độ ổn định khi chạy lặp lại. Cùng một Prompt nhận được một câu trả lời đẹp chỉ cho thấy lần chạy đó đã thành công. Nó không trực tiếp cho thấy mô hình sẽ hoàn thành ổn định loại tác vụ đó trong môi trường vận hành.
Một cách kiểm tra đáng tin hơn là:
- Chuẩn bị một nhóm mẫu độc lập cho mỗi loại tác vụ.
- Chạy trong cùng điều kiện lời nhắc hệ thống, ngữ cảnh, định nghĩa công cụ và khu vực.
- Lặp lại mỗi mẫu nhiều lần.
- Phán xét kết quả bằng quy tắc, bài kiểm tra được giấu, hoặc đánh giá mù của người.
- Báo cáo tỷ lệ thành công và khoảng tin cậy.
- Liệt kê riêng các ca tệ nhất và các loại thất bại.
Cách này cuối cùng đưa việc đánh giá mô hình từ “lần đầu ra nào là tốt nhất” thành “hệ thống này có tiếp tục hoàn thành công việc được không”.
Với người dùng cá nhân, Haiku 5.5 có nghĩa là gì
Người dùng cá nhân chưa chắc cảm nhận trực tiếp sự thay đổi đơn giá API, nhưng có thể hiểu vị trí của Haiku 5.5 từ ba góc.
Thứ nhất, nó phù hợp hơn với tác vụ nhanh, lặp lại và có ranh giới rõ, ví dụ sắp xếp văn bản, trích xuất thông tin, tạo bản nháp có cấu trúc và xử lý một lượng lớn câu hỏi nhỏ.
Thứ hai, nó không nhất thiết phù hợp để thay mọi mô hình cao cấp. Viết phức tạp, lập kế hoạch dài hạn, mã khó và việc phải giữ trạng thái liên tục vẫn phụ thuộc nhiều hơn vào Sonnet hoặc Opus.
Thứ ba, khác biệt giữa các mô hình sẽ ngày càng giống “khác biệt về cách làm việc”, chứ không phải khác biệt đơn giản về cao thấp. Khi chọn một mô hình, hãy nhìn trước tần suất của tác vụ, yêu cầu về độ trễ, cái giá của lỗi và cách kiểm chứng, rồi mới nhìn năng lực của một lần gọi.
Với đội sản phẩm, điều thực sự cần tính lại là kinh tế của một đơn vị tác vụ
Haiku 5.5 khiến nhiều bước trước đây không đáng tự động hóa trở nên dễ thử hơn.
- Thêm một tầng phân loại đầu vào.
- Thêm một lượt nén kết quả truy xuất.
- Thêm một tác nhân con chuyên xử lý tài liệu.
- Thêm một lần kiểm tra đầu ra với chi phí thấp.
- Thêm một lần kiểm chứng có cấu trúc trước câu trả lời cuối.
Những bước thêm này tự chúng làm tăng số lần gọi. Nhưng nếu chúng hạ được tỷ lệ thất bại cuối, chi phí của cả sản phẩm vẫn có thể giảm.
Đây cũng là lý do “giá của một lần gọi mô hình” không đủ dùng. Điều đội sản phẩm thực sự cần so sánh là:
Chi phí một lần gọi
→ tổng chi phí của một tác vụ
→ tổng chi phí của một tác vụ thành công
→ tổng chi phí của một kết quả có thể bàn giao
Khi Haiku 5.5 đủ rẻ, hệ thống có thể dùng nhiều tác vụ nhỏ để đổi lấy độ tin cậy cuối cao hơn. Thay đổi này ảnh hưởng đến thiết kế Agent, cấu trúc lợi nhuận của sản phẩm, và việc đội ngũ quyết định phần việc nào nên giao cho mô hình tự hoàn thành.
Lời kết: Haiku 5.5 là một thay đổi về kiến trúc
Việc phát hành Haiku 5.5 có thể được hiểu là một lần nâng cấp mô hình nhỏ, cũng có thể được hiểu là Anthropic đẩy hình thái sản phẩm mô hình tiến thêm một bước.
Nó đặt ba câu hỏi lên cùng một bảng quyết định.
- Tác vụ này cần bao nhiêu trí tuệ.
- Tác vụ này chịu được bao nhiêu độ trễ.
- Tác vụ này đáng bỏ bao nhiêu tiền.
Khi việc chọn mô hình được đặt cùng định tuyến tác vụ, effort, cache, thử lại và việc người tiếp quản, “mô hình nào mạnh nhất” không còn là câu hỏi duy nhất. Câu hỏi quan trọng hơn trở thành:
Mô hình nào nên xử lý loại lệnh gọi nào, và làm thế nào để có một kết quả đủ tin cậy với chi phí đầu-cuối thấp nhất?
Ý nghĩa của Haiku 5.5 có thể chính là việc nó khiến câu hỏi này lần đầu trở nên đủ rẻ để đáng được hỏi trên quy mô lớn.