Haiku 5.5:Anthropic 正在把模型能力變成一套分工系統
Claude Haiku 5.5 的價值,不只在於它回答得更快、更便宜,而在於它開始讓模型調用變成一種可以被大規模部署的基礎設施。
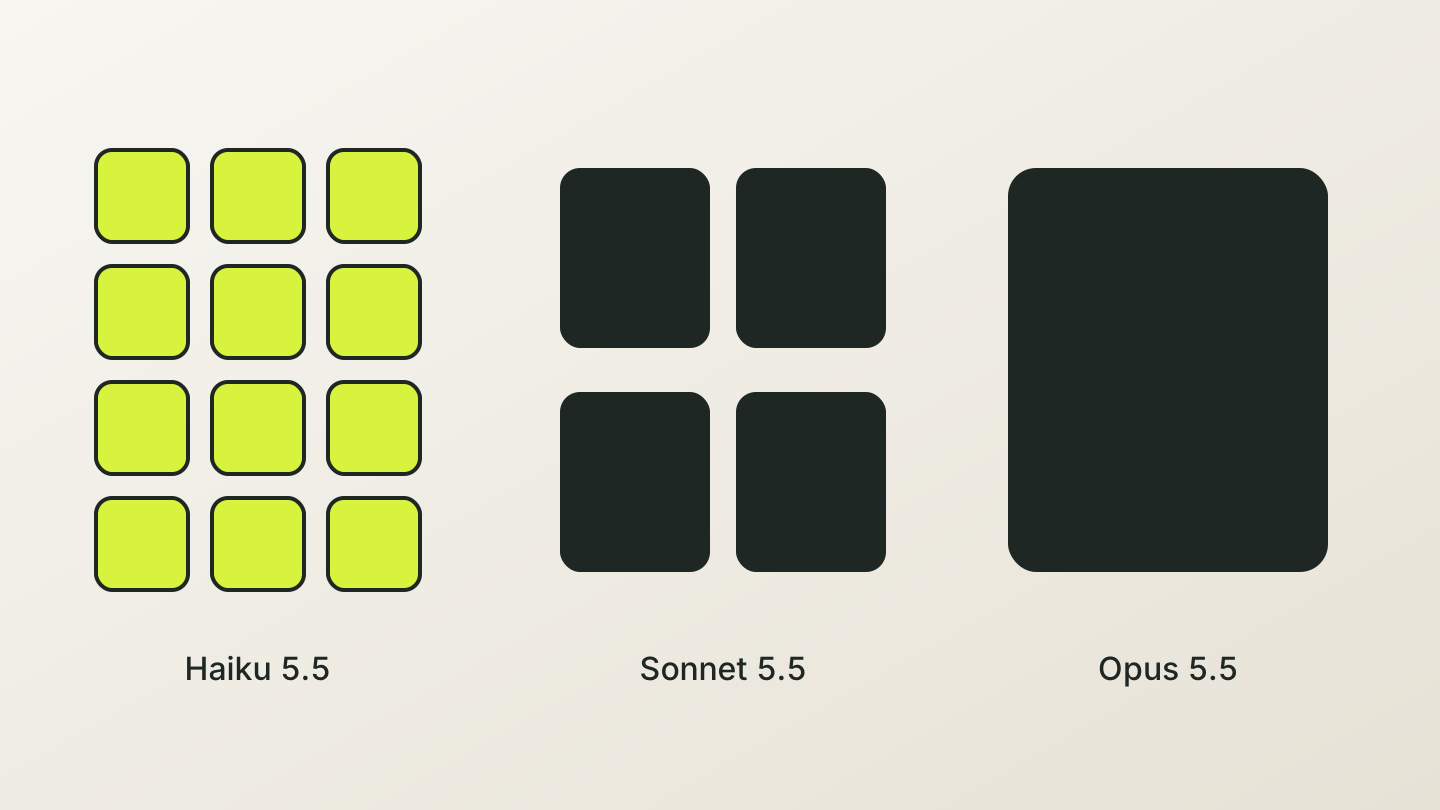
Haiku 5.5:Anthropic 正在把模型能力變成一套分工系統
Claude Haiku 5.5 的價值,不只在於它回答得更快、更便宜,而在於它開始讓模型調用變成一種可以被大規模部署的基礎設施。
Anthropic 在 2026 年 10 月 7 日發布了 Claude Haiku 5.5。先說明一個容易混淆的名稱:公開的 Anthropic 官方資料裡,模型名稱是 Claude Haiku 5.5,模型 ID 是 claude-haiku-5-5,並沒有名為「Claude Hiya 5.5」的官方模型。本文統一使用 Haiku 5.5。
Anthropic 給它的定位很明確:這是面向高併發、低延遲、成本敏感任務的小模型,適合分類、資訊抽取、摘要、上下文壓縮、資料庫查詢、瀏覽器操作和 Agent 子任務。官方稱,Haiku 5.5 的平均運行成本比 Haiku 4.5 低約 75%;它也是 Haiku 系列首次提供可調 effort 設定的模型。
這讓 Haiku 5.5 的問題從「它是不是又一個更強的小模型」,變成了一個更實際的問題:當一個模型便宜到可以被大量調用時,AI 產品的模型分工會發生什麼變化?
Claude 5.5 家族正在形成清晰的分工
如果只看模型名稱,很容易把 Opus、Sonnet 和 Haiku 理解成同一條能力排行榜上的三個位置。更準確的理解是,它們正在形成一套面向不同工作負載的模型分工。
| 模型 | 更適合的角色 | 典型任務 |
|---|---|---|
| Claude Opus 5.5 | 複雜問題的專家和長程規劃者 | 複雜 Agent、長時間編碼、困難推理、關鍵決策 |
| Claude Sonnet 5.5 | 日常工作的主力模型 | 程式碼修改、文件生成、分析、多步知識工作 |
| Claude Haiku 5.5 | 高頻調用的執行層 | 分類、抽取、摘要、壓縮、路由、瀏覽器和子代理任務 |
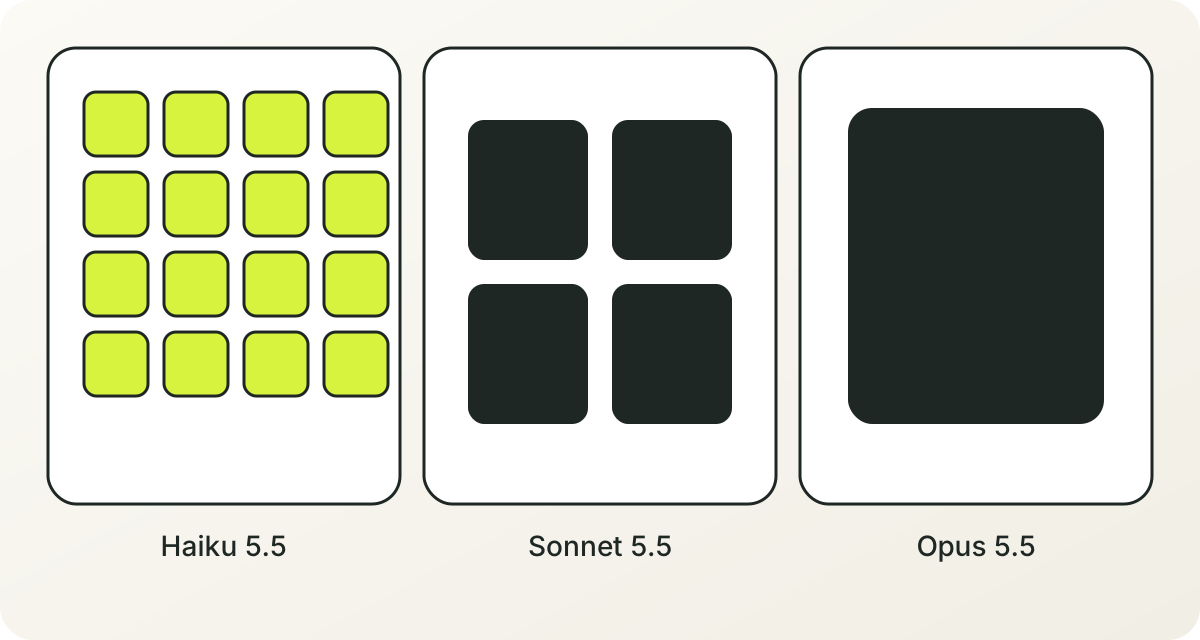
Anthropic 的模型總覽也採用了類似的定位:Opus 5.5 面向長時間 Agent 程式設計和知識工作,Sonnet 5.5 強調速度與智能的平衡,Haiku 5.5 面向高併發、低延遲的分類、抽取和路由任務。
這意味著,Haiku 5.5 的競爭力不一定體現為「在所有事情上都比中型模型強」。它更可能體現在另一個地方:它能否把大量原本因為成本、延遲或吞吐而不值得自動化的局部任務,變成可以持續運行的系統步驟。
價格下降,改變的是調用方式
Haiku 5.5 的官方價格需要分成兩個區間理解。對於輸入提示不超過 100K tokens 的請求,輸入價格是每百萬 tokens 0.10 美元,輸出價格是每百萬 tokens 0.50 美元;超過 100K tokens 後,價格分別為 0.50 美元和 2.50 美元。
| 請求規模 | 輸入 | 輸出 | Cache read |
|---|---|---|---|
| 不超過 100K tokens | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| 超過 100K tokens | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
這裡有兩個容易被忽略的細節。
第一,單價下降和真實成本下降不是同一件事。Anthropic 的「平均運行成本低約 75%」已經考慮了新 tokenizer 帶來的 token 使用變化。也就是說,不能只拿新舊模型的每百萬 token 單價相除,就推斷產品帳單會下降同樣的比例。
第二,模型是否成功完成任務,會影響真實成本。一次調用很便宜,但如果它需要重試、回退到 Sonnet、增加人工檢查,最終的任務成本仍然可能很高。
因此,產品團隊更應該關注這個指標:
每個成功任務的成本
= 完成任務產生的總模型與工具費用 ÷ 成功完成的任務數量
如果要進一步比較不同架構,還應該把重試、fallback、工具調用和人工接管納入總帳單。
Haiku 5.5 最重要的變化之一,是 effort 變得可調
Haiku 5.5 是 Haiku 系列第一次提供可調 effort 的模型。這個設定讓「模型選擇」不再是唯一的成本開關,系統還可以在同一個模型裡調整推理投入。
可以把它理解成一輛車的駕駛模式:
- 對簡單分類和格式轉換,使用較低的 effort,優先追求速度和低成本;
- 對結構化抽取和長文壓縮,使用中等 effort,平衡品質與費用;
- 對需要多步判斷的任務,提高 effort;
- 如果任務仍然失敗,再升級到 Sonnet 或 Opus。
這帶來一個新的決策公式:
最終效果 = 模型 × effort × 上下文 × 工具 × 重試策略
因此,今後比較模型時,不能只問「Haiku 5.5 和 Sonnet 5.5 誰更強」,還要問:
- 在相同任務上,哪個 effort 檔位最劃算?
- 提高 effort 帶來的品質提升,是否能覆蓋額外成本?
- 對簡單任務而言,提高 effort 是否只是延長等待時間?
- 是讓 Haiku 多嘗試一次更劃算,還是直接調用一次 Sonnet 更劃算?
這也是為什麼 Haiku 5.5 更適合用任務級成本來評估,而不是用一次輸出的觀感來評估。
Agent 可能會從「一個大模型包打天下」變成分層協作
過去很多 Agent 的結構都類似於:使用者提出請求之後,由一個大模型負責規劃、檢索、調用工具、整理結果和最終回答。
使用者請求 → 大模型規劃 → 大模型搜尋 → 大模型總結 → 大模型輸出
這種結構簡單,但會讓每一個局部動作都使用同樣昂貴的模型。對於一個需要搜尋幾十份文件、處理幾百條記錄或反覆調用瀏覽器的 Agent 來說,成本和延遲很快就會累積起來。
Haiku 5.5 更適合進入下面這類分層架構:
使用者請求
   ↓
Sonnet 或 Opus 負責拆解任務和制定計畫
   ↓
Haiku 5.5 負責搜尋、分類、抽取、摘要和單步工具調用
   ↓
Sonnet 或 Opus 負責審查結果並完成最終決策
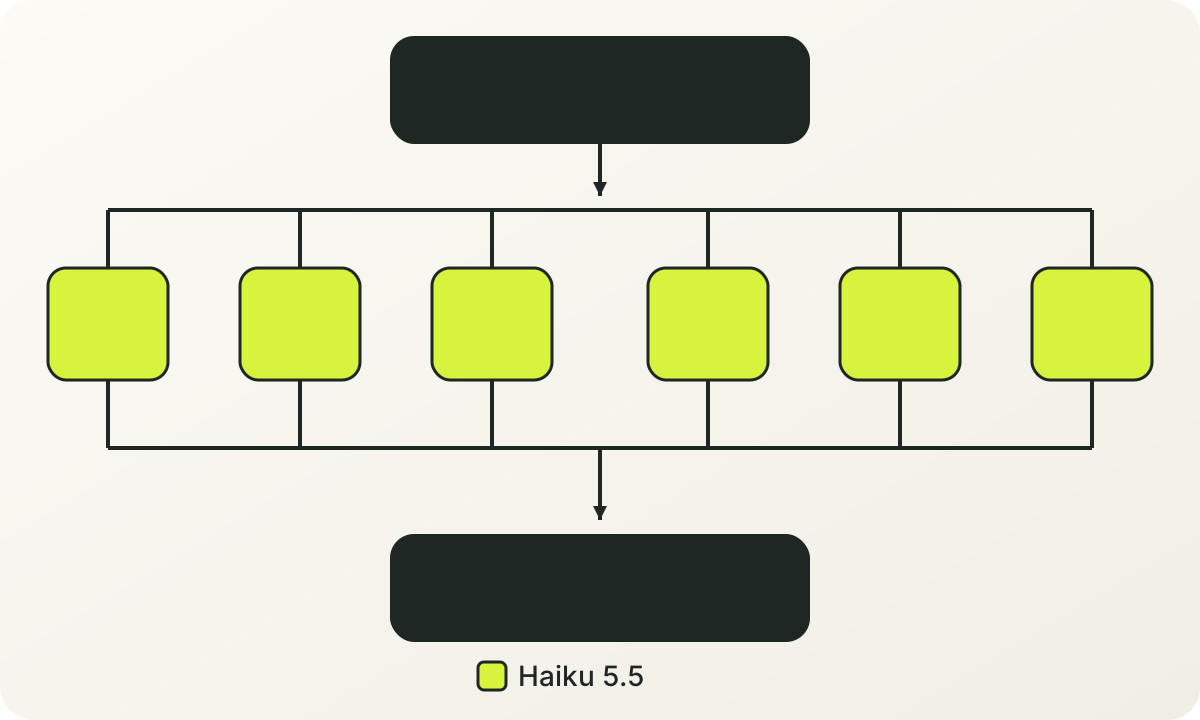
在這種結構裡,Haiku 5.5 的價值不是獨立完成最複雜的任務,而是成為 Agent 的「工人層」。它處理數量最多、結構相對清晰、可以被驗證的局部工作。
哪些工作適合交給 Haiku 5.5
- 把使用者請求路由到不同工作流;
- 從一份或幾份文件中抽取固定欄位;
- 對工單進行分類和優先順序排序;
- 把長對話壓縮成下一輪 Agent 所需的上下文;
- 對搜尋結果做去重和初步摘要;
- 進行一次明確的瀏覽器操作;
- 檢查程式碼格式、生成簡單測試或解釋局部程式碼;
- 作為 Sonnet 或 Opus 的子代理完成一小段工作。
哪些工作不應該預設交給 Haiku 5.5
- 需要長程規劃的複雜專案;
- 涉及多個檔案、多個相依性和多輪回饋的程式碼修改;
- 一次錯誤會帶來較高損失的關鍵決策;
- 需要在很長的工作過程中保持複雜狀態;
- 沒有自動驗證手段、只能依賴人工判斷的任務。
這裡的關鍵不是給模型貼上「能做」或「不能做」的標籤,而是評估任務失敗後的代價。對於可以自動檢查、失敗後可以重試的任務,Haiku 5.5 的性價比會更有吸引力;對於失敗代價很高的任務,Sonnet 或 Opus 仍然更穩妥。
普通開發者應該怎樣選擇三檔模型
可以先用任務複雜度和失敗代價做一個簡單路由:
| 任務特徵 | 預設選擇 | 升級條件 |
|---|---|---|
| 輸出格式固定、可自動驗證 | Haiku 5.5 | 連續格式錯誤或關鍵欄位缺失 |
| 調用量大、延遲敏感 | Haiku 5.5 | p95 延遲或失敗率超過產品閾值 |
| 需要摘要、壓縮、分類、抽取 | Haiku 5.5 | 出現跨文件推理或上下文衝突 |
| 一般知識工作和程式碼修改 | Sonnet 5.5 | 任務跨度較長或需要多輪規劃 |
| 複雜 Agent 和長程編碼 | Sonnet 5.5 或 Opus 5.5 | 對錯誤容忍度極低或需要深度推理 |
| 高風險判斷和最終審核 | Sonnet 5.5 或 Opus 5.5 | 根據錯誤代價和驗證能力決定 |
這張表不應該被當成永遠固定的答案。真正投入生產前,應該用自己的任務集測出每一檔模型在成功率、延遲和每個成功任務成本上的分界點。
100K tokens 是一個需要特別留意的價格邊界
Haiku 5.5 的宣傳價格很低,但 100K tokens 之後價格會明顯上升。對於長文件、程式碼儲存庫和長對話應用,團隊不能只看模型的公開起步價格。
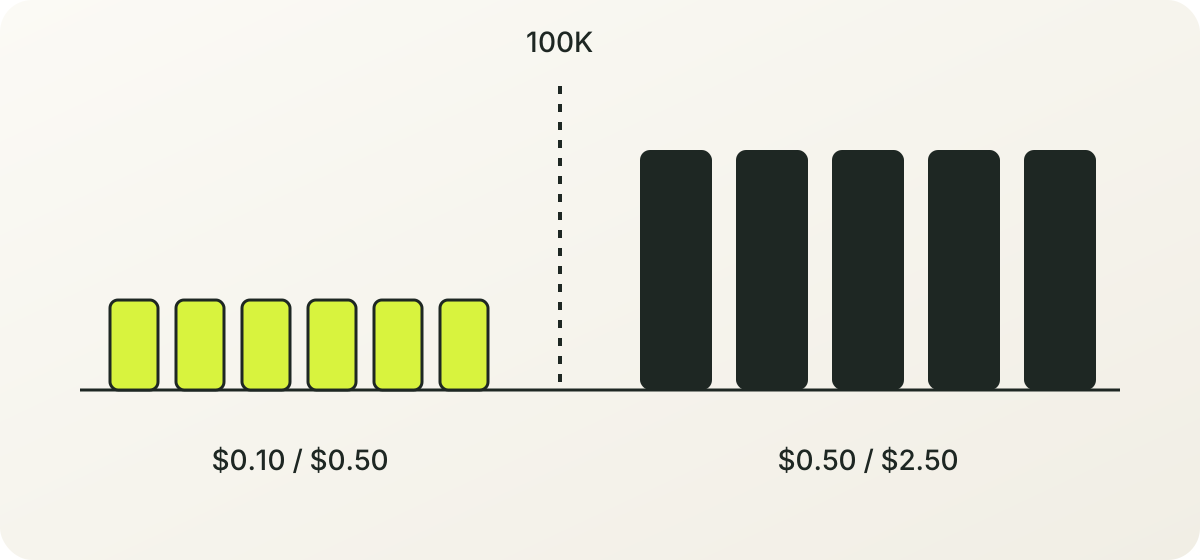
可以把一條長上下文工作流拆成幾個步驟:
- 首次讀取文件時建立快取;
- 用 Haiku 5.5 做上下文壓縮;
- 只把與當前問題有關的片段交給 Sonnet;
- 將中間結果儲存為結構化狀態;
- 避免每一輪都重新傳送完整歷史。
這個流程有兩個好處:它降低了跨過 100K 價格區間的機率,也讓不同模型可以承擔不同工作。
因此,Haiku 5.5 的長上下文價值不能只用「最多能讀多少 tokens」衡量。更實際的問題是:
- 需要把多少原始內容放進模型;
- 哪些內容應該先被壓縮;
- 快取命中率是多少;
- 超過 100K 後的價格是否仍然可以接受;
- 壓縮帶來的資訊損失是否會導致後續任務失敗。
Haiku 5.5 的發布,也改變了模型評測的重點
官方頁面已經提供了 GDPval-AA、OSWorld、Humanity's Last Exam、Terminal-Bench 等多項成績。它們可以幫助讀者瞭解模型的大致能力範圍,但產品團隊仍然需要自己的任務測試。
在真實系統裡,最值得觀察的不是一個模型在某個基準上的單項成績,而是下面這組指標:
- 任務成功率;
- 輸出品質;
- p50 和 p95 延遲;
- 輸入與輸出 token 數;
- 重試率;
- 工具調用錯誤率;
- fallback 率;
- 人工接管率;
- 每個成功任務的成本。
尤其要注意重複運行的穩定性。同一個 Prompt 得到一次漂亮回答,只能說明這次運行成功了;它不能直接說明模型在生產環境中會穩定完成同類任務。
一個更可靠的測試方式是:
- 為每一類任務準備一組獨立樣本;
- 在相同系統提示、上下文、工具定義和地區條件下運行;
- 每個樣本重複多次;
- 使用規則、隱藏測試或人工盲評判斷結果;
- 報告成功率和信賴區間;
- 單獨列出最差案例與失敗類型。
這套方法最終會把模型評測從「哪次輸出最好」變成「這個系統能否持續完成工作」。
對個人使用者來說,Haiku 5.5 意味著什麼
個人使用者未必會直接感受到 API 單價變化,但可以從三個角度理解 Haiku 5.5 的位置。
第一,它更適合快速、重複和邊界清晰的任務,例如整理文字、提取資訊、生成結構化草稿和處理大量小問題。
第二,它不一定適合取代所有高階模型。複雜寫作、長程規劃、困難程式碼和需要連續保持狀態的工作,仍然更依賴 Sonnet 或 Opus。
第三,模型之間的差異會越來越像「工作方式差異」,而不是簡單的高低差異。選擇一個模型時,應該先看任務的頻率、延遲要求、錯誤代價和驗證手段,再看模型的單次能力。
對產品團隊來說,真正需要重新計算的是單位任務經濟學
Haiku 5.5 讓許多過去不值得自動化的步驟變得更容易嘗試:
- 多一層輸入分類;
- 多一輪檢索結果壓縮;
- 多一個專門處理文件的子代理;
- 多一次低成本的輸出檢查;
- 在最終回答前增加一次結構化驗證。
這些新增步驟本身會增加調用次數,但如果它們能夠降低最終失敗率,整體產品成本可能反而下降。
這也是「單次模型價格」不夠用的原因。產品團隊真正需要比較的是:
單次調用成本
→ 一次任務的總成本
→ 一個成功任務的總成本
→ 一次可交付結果的總成本
當 Haiku 5.5 足夠便宜時,系統可能有能力用多個小任務換取更高的最終可靠性。這種變化會影響 Agent 的設計、產品的利潤結構,以及團隊決定哪些工作應該交給模型自動完成。
結語:Haiku 5.5 是一項架構變化
Haiku 5.5 的發布可以被理解成一次小模型升級,也可以被理解成 Anthropic 對模型產品形態的一次推進。
它把三個問題放到了同一張決策表上:
- 這個任務需要多少智能;
- 這個任務能夠承受多少延遲;
- 這個任務值得花多少錢。
當模型選擇與任務路由、effort、快取、重試和人工接管放在一起時,「哪個模型最強」就不再是唯一問題。更重要的問題變成了:
哪一個模型應該處理哪一種調用,怎樣用最低的端到端成本得到一個足夠可靠的結果?
Haiku 5.5 的意義,可能正在於它讓這個問題第一次變得足夠便宜,值得被大規模地問一遍。