Haiku 5.5:Anthropic 正在把模型能力变成一套分工系统
Claude Haiku 5.5 的价值,不只在于它回答得更快、更便宜,而在于它开始让模型调用变成一种可以被大规模部署的基础设施。
Haiku 5.5:Anthropic 正在把模型能力变成一套分工系统
Claude Haiku 5.5 的价值,不只在于它回答得更快、更便宜,而在于它开始让模型调用变成一种可以被大规模部署的基础设施。
Anthropic 在 2026 年 10 月 7 日发布了 Claude Haiku 5.5。先说明一个容易混淆的名称:公开的 Anthropic 官方资料里,模型名称是 Claude Haiku 5.5,模型 ID 是 claude-haiku-5-5,并没有名为“Claude Hiya 5.5”的官方模型。本文统一使用 Haiku 5.5。
Anthropic 给它的定位很明确:这是面向高并发、低延迟、成本敏感任务的小模型,适合分类、信息抽取、摘要、上下文压缩、数据库查询、浏览器操作和 Agent 子任务。官方称,Haiku 5.5 的平均运行成本比 Haiku 4.5 低约 75%;它也是 Haiku 系列首次提供可调 effort 设置的模型。
这让 Haiku 5.5 的问题从“它是不是又一个更强的小模型”,变成了一个更实际的问题:当一个模型便宜到可以被大量调用时,AI 产品的模型分工会发生什么变化?
Claude 5.5 家族正在形成清晰的分工
如果只看模型名称,很容易把 Opus、Sonnet 和 Haiku 理解成同一条能力排行榜上的三个位置。更准确的理解是,它们正在形成一套面向不同工作负载的模型分工。
| 模型 | 更适合的角色 | 典型任务 |
|---|---|---|
| Claude Opus 5.5 | 复杂问题的专家和长程规划者 | 复杂 Agent、长时间编码、困难推理、关键决策 |
| Claude Sonnet 5.5 | 日常工作的主力模型 | 代码修改、文档生成、分析、多步知识工作 |
| Claude Haiku 5.5 | 高频调用的执行层 | 分类、抽取、摘要、压缩、路由、浏览器和子代理任务 |
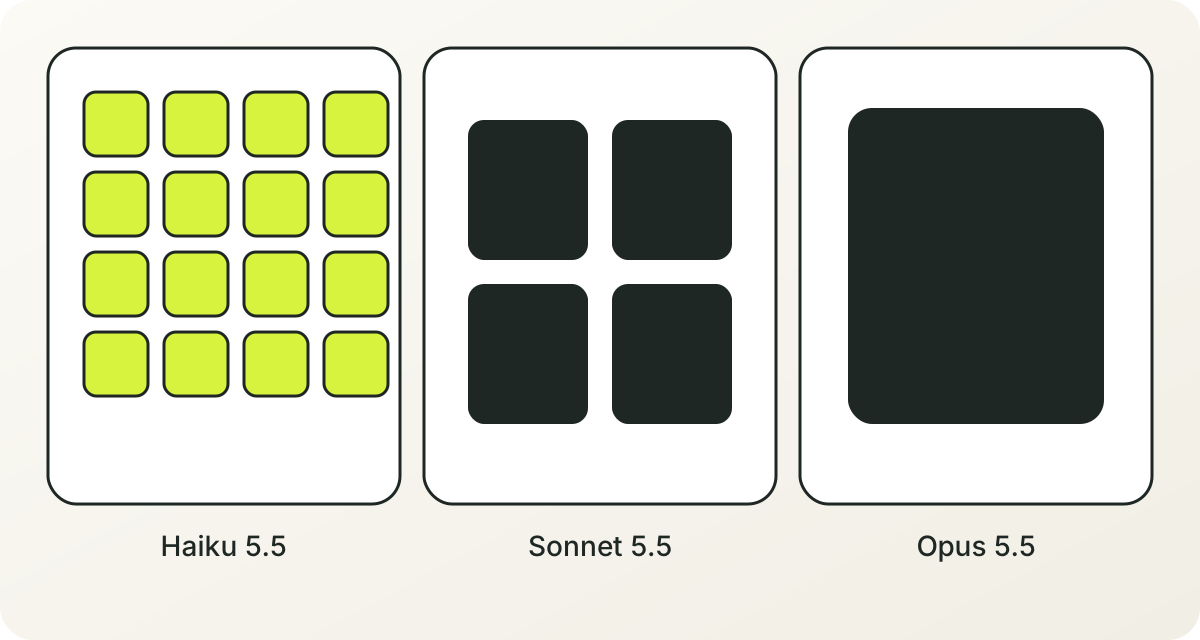
Anthropic 的模型总览也采用了类似的定位:Opus 5.5 面向长时间 Agent 编程和知识工作,Sonnet 5.5 强调速度与智能的平衡,Haiku 5.5 面向高并发、低延迟的分类、抽取和路由任务。
这意味着,Haiku 5.5 的竞争力不一定体现为“在所有事情上都比中型模型强”。它更可能体现在另一个地方:它能否把大量原本因为成本、延迟或吞吐而不值得自动化的局部任务,变成可以持续运行的系统步骤。
价格下降,改变的是调用方式
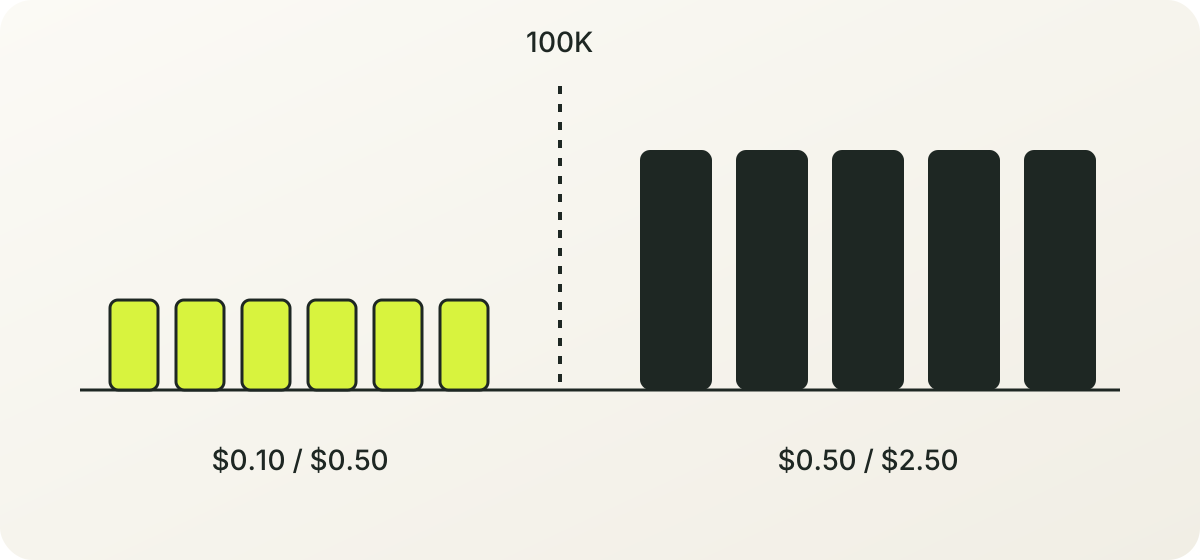
Haiku 5.5 的官方价格需要分成两个区间理解。对于输入提示不超过 100K tokens 的请求,输入价格是每百万 tokens 0.10 美元,输出价格是每百万 tokens 0.50 美元;超过 100K tokens 后,价格分别为 0.50 美元和 2.50 美元。
| 请求规模 | 输入 | 输出 | Cache read |
|---|---|---|---|
| 不超过 100K tokens | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| 超过 100K tokens | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
这里有两个容易被忽略的细节。
第一,单价下降和真实成本下降不是同一件事。Anthropic 的“平均运行成本低约 75%”已经考虑了新 tokenizer 带来的 token 使用变化。也就是说,不能只拿新旧模型的每百万 token 单价相除,就推断产品账单会下降同样的比例。
第二,模型是否成功完成任务,会影响真实成本。一个调用很便宜,但如果它需要重试、回退到 Sonnet、增加人工检查,最终的任务成本仍然可能很高。
因此,产品团队更应该关注这个指标:
每个成功任务的成本
= 完成任务产生的总模型与工具费用 ÷ 成功完成的任务数量
如果要进一步比较不同架构,还应该把重试、fallback、工具调用和人工接管纳入总账单。
Haiku 5.5 最重要的变化之一,是 effort 变得可调
Haiku 5.5 是 Haiku 系列第一次提供可调 effort 的模型。这个设置让“模型选择”不再是唯一的成本开关,系统还可以在同一个模型里调整推理投入。
可以把它理解成一辆车的驾驶模式:
- 对简单分类和格式转换,使用较低的 effort,优先追求速度和低成本;
- 对结构化抽取和长文压缩,使用中等 effort,平衡质量与费用;
- 对需要多步判断的任务,提高 effort;
- 如果任务仍然失败,再升级到 Sonnet 或 Opus。
这带来一个新的决策公式:
最终效果 = 模型 × effort × 上下文 × 工具 × 重试策略
因此,今后比较模型时,不能只问“Haiku 5.5 和 Sonnet 5.5 谁更强”,还要问:
- 在相同任务上,哪个 effort 档位最划算?
- 提高 effort 带来的质量提升,是否能覆盖额外成本?
- 对简单任务而言,提高 effort 是否只是延长等待时间?
- 是让 Haiku 多尝试一次更划算,还是直接调用一次 Sonnet 更划算?
这也是为什么 Haiku 5.5 更适合用任务级成本来评估,而不是用一次输出的观感来评估。
Agent 可能会从“一个大模型包打天下”变成分层协作
过去很多 Agent 的结构都类似于:用户提出请求之后,由一个大模型负责规划、检索、调用工具、整理结果和最终回答。
用户请求 → 大模型规划 → 大模型搜索 → 大模型总结 → 大模型输出
这种结构简单,但会让每一个局部动作都使用同样昂贵的模型。对于一个需要搜索几十份文档、处理几百条记录或反复调用浏览器的 Agent 来说,成本和延迟很快就会累积起来。
Haiku 5.5 更适合进入下面这类分层架构:
用户请求
   ↓
Sonnet 或 Opus 负责拆解任务和制定计划
   ↓
Haiku 5.5 负责搜索、分类、抽取、摘要和单步工具调用
   ↓
Sonnet 或 Opus 负责审查结果并完成最终决策
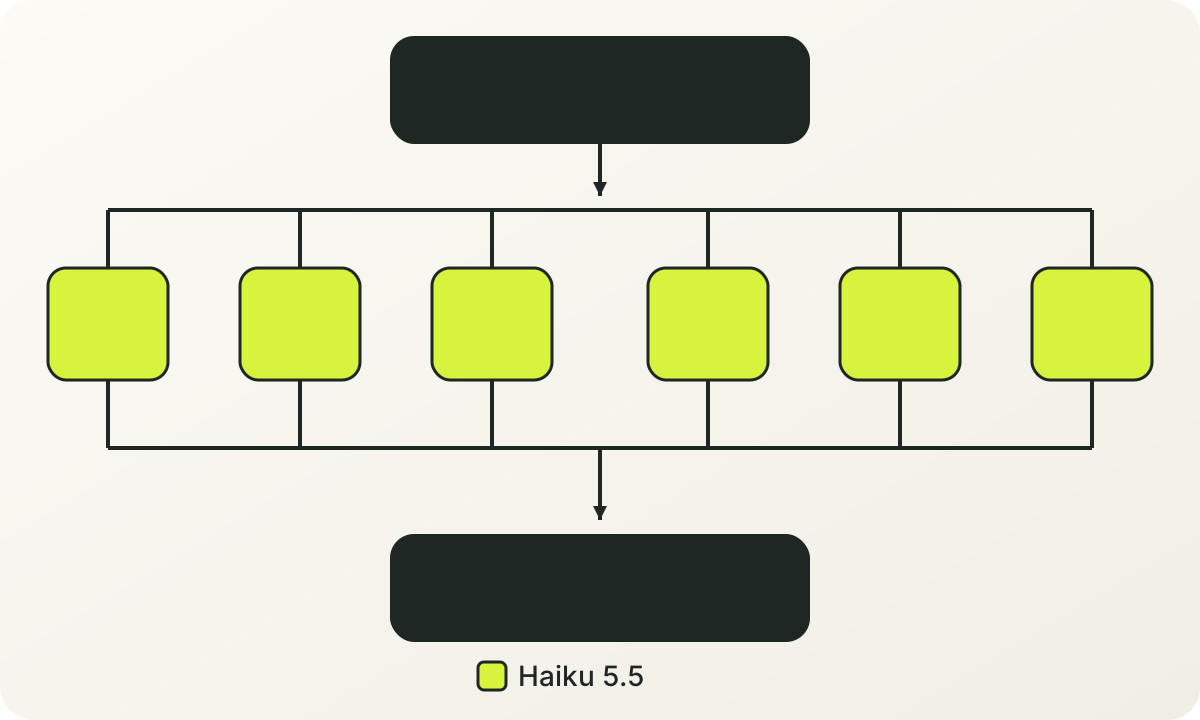
在这种结构里,Haiku 5.5 的价值不是独立完成最复杂的任务,而是成为 Agent 的“工人层”。它处理数量最多、结构相对清晰、可以被验证的局部工作。
哪些工作适合交给 Haiku 5.5
- 把用户请求路由到不同工作流;
- 从一份或几份文档中抽取固定字段;
- 对工单进行分类和优先级排序;
- 把长对话压缩成下一轮 Agent 所需的上下文;
- 对搜索结果做去重和初步摘要;
- 进行一次明确的浏览器操作;
- 检查代码格式、生成简单测试或解释局部代码;
- 作为 Sonnet 或 Opus 的子代理完成一小段工作。
哪些工作不应该默认交给 Haiku 5.5
- 需要长程规划的复杂项目;
- 涉及多个文件、多个依赖和多轮反馈的代码修改;
- 一次错误会带来较高损失的关键决策;
- 需要在很长的工作过程中保持复杂状态;
- 没有自动验证手段、只能依赖人工判断的任务。
这里的关键不是给模型贴上“能做”或“不能做”的标签,而是评估任务失败后的代价。对于可以自动检查、失败后可以重试的任务,Haiku 5.5 的性价比会更有吸引力;对于失败代价很高的任务,Sonnet 或 Opus 仍然更稳妥。
普通开发者应该怎样选择三档模型
可以先用任务复杂度和失败代价做一个简单路由:
| 任务特征 | 默认选择 | 升级条件 |
|---|---|---|
| 输出格式固定、可自动验证 | Haiku 5.5 | 连续格式错误或关键字段缺失 |
| 调用量大、延迟敏感 | Haiku 5.5 | p95 延迟或失败率超过产品阈值 |
| 需要摘要、压缩、分类、抽取 | Haiku 5.5 | 出现跨文档推理或上下文冲突 |
| 一般知识工作和代码修改 | Sonnet 5.5 | 任务跨度较长或需要多轮规划 |
| 复杂 Agent 和长程编码 | Sonnet 5.5 或 Opus 5.5 | 对错误容忍度极低或需要深度推理 |
| 高风险判断和最终审核 | Sonnet 5.5 或 Opus 5.5 | 根据错误代价和验证能力决定 |
这张表不应该被当成永远固定的答案。真正投入生产前,应该用自己的任务集测出每一档模型在成功率、延迟和每个成功任务成本上的分界点。
100K tokens 是一个需要特别留意的价格边界
Haiku 5.5 的宣传价格很低,但 100K tokens 之后价格会明显上升。对于长文档、代码仓库和长对话应用,团队不能只看模型的公开起步价格。
可以把一条长上下文工作流拆成几个步骤:
- 首次读取文档时建立缓存;
- 用 Haiku 5.5 做上下文压缩;
- 只把与当前问题有关的片段交给 Sonnet;
- 将中间结果保存为结构化状态;
- 避免每一轮都重新发送完整历史。
这个流程有两个好处:它降低了跨过 100K 价格区间的概率,也让不同模型可以承担不同工作。
因此,Haiku 5.5 的长上下文价值不能只用“最多能读多少 tokens”衡量。更实际的问题是:
- 需要把多少原始内容放进模型;
- 哪些内容应该先被压缩;
- 缓存命中率是多少;
- 超过 100K 后的价格是否仍然可以接受;
- 压缩带来的信息损失是否会导致后续任务失败。
Haiku 5.5 的发布,也改变了模型评测的重点
官方页面已经提供了 GDPval-AA、OSWorld、Humanity's Last Exam、Terminal-Bench 等多项成绩。它们可以帮助读者了解模型的大致能力范围,但产品团队仍然需要自己的任务测试。
在真实系统里,最值得观察的不是一个模型在某个基准上的单项成绩,而是下面这组指标:
- 任务成功率;
- 输出质量;
- p50 和 p95 延迟;
- 输入与输出 token 数;
- 重试率;
- 工具调用错误率;
- fallback 率;
- 人工接管率;
- 每个成功任务的成本。
尤其要注意重复运行的稳定性。同一个 Prompt 得到一次漂亮回答,只能说明这次运行成功了;它不能直接说明模型在生产环境中会稳定完成同类任务。
一个更可靠的测试方式是:
- 为每一类任务准备一组独立样本;
- 在相同系统提示、上下文、工具定义和地区条件下运行;
- 每个样本重复多次;
- 使用规则、隐藏测试或人工盲评判断结果;
- 报告成功率和置信区间;
- 单独列出最差案例与失败类型。
这套方法最终会把模型评测从“哪次输出最好”变成“这个系统能否持续完成工作”。
对个人用户来说,Haiku 5.5 意味着什么
个人用户未必会直接感受到 API 单价变化,但可以从三个角度理解 Haiku 5.5 的位置。
第一,它更适合快速、重复和边界清晰的任务,例如整理文本、提取信息、生成结构化草稿和处理大量小问题。
第二,它不一定适合替代所有高级模型。复杂写作、长程规划、困难代码和需要连续保持状态的工作,仍然更依赖 Sonnet 或 Opus。
第三,模型之间的差异会越来越像“工作方式差异”,而不是简单的高低差异。选择一个模型时,应该先看任务的频率、延迟要求、错误代价和验证手段,再看模型的单次能力。
对产品团队来说,真正需要重新计算的是单位任务经济学
Haiku 5.5 让许多过去不值得自动化的步骤变得更容易尝试:
- 多一层输入分类;
- 多一轮检索结果压缩;
- 多一个专门处理文档的子代理;
- 多一次低成本的输出检查;
- 在最终回答前增加一次结构化验证。
这些新增步骤本身会增加调用次数,但如果它们能够降低最终失败率,整体产品成本可能反而下降。
这也是“单次模型价格”不够用的原因。产品团队真正需要比较的是:
单次调用成本
→ 一次任务的总成本
→ 一个成功任务的总成本
→ 一次可交付结果的总成本
当 Haiku 5.5 足够便宜时,系统可能有能力用多个小任务换取更高的最终可靠性。这种变化会影响 Agent 的设计、产品的利润结构,以及团队决定哪些工作应该交给模型自动完成。
结语:Haiku 5.5 是一项架构变化
Haiku 5.5 的发布可以被理解成一次小模型升级,也可以被理解成 Anthropic 对模型产品形态的一次推进。
它把三个问题放到了同一张决策表上:
- 这个任务需要多少智能;
- 这个任务能够承受多少延迟;
- 这个任务值得花多少钱。
当模型选择与任务路由、effort、缓存、重试和人工接管放在一起时,“哪个模型最强”就不再是唯一问题。更重要的问题变成了:
哪一个模型应该处理哪一种调用,怎样用最低的端到端成本得到一个足够可靠的结果?
Haiku 5.5 的意义,可能正在于它让这个问题第一次变得足够便宜,值得被大规模地问一遍。