Kimi K3.1 Pro 详解:模型参数、能力特征、价格与同类模型对比
依据官方资料详细介绍 Kimi K3.1 Pro 与 Highspeed:百万上下文、已公开架构、推理与工具参数、美元及人民币价格,对比 Claude、GLM、DeepSeek,并提供可复算的 token 成本示例。
Kimi K3.1 Pro 是月之暗面面向编程、视觉与 3D 工作、多步骤研究任务推出的新旗舰模型,于 2026 年 10 月 23 日发布。它拥有三万亿级参数规模、1,048,576 tokens 上下文窗口,并始终开启推理。国际 API 标价为输入 $2、输出 $10/百万 tokens;Highspeed 高速版为 $4 / $20。按普通未缓存输入和输出单价比较,标准版与 Claude Sonnet 5.5 相同,是 Claude Opus 5.5 对应价格的一半。来源:官方模型列表、Kimi 国际价格、Claude 价格。
真正值得关心的是,这些价格对应什么能力,放进实际工作流又需要多少预算。本文分别介绍模型规格、API 参数、官方评测,以及可复算的 token 成本。**费用示例是按公开价格计算的假设场景,Modelflare 没有为本文实际运行模型对比评测。**涉及官方成绩时,均注明发布者和适用条件。
事实和价格核查时间为 2026 年 10 月 23 日约 18:03 UTC。当时 Modelflare 公开目录中有 kimi-k3,尚无两个 K3.1 型号。本文介绍官方新模型,不代表 Modelflare 已经上线 K3.1 调用。
1. K3.1 到底是哪一个型号?
| 项目 | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| 官方开放平台 API ID | kimi-k3.1-pro |
kimi-k3.1-pro-highspeed |
| Kimi Code ID | k3.1-pro |
k3.1-pro-highspeed |
| 产品定位 | 旗舰推理与智能体任务 | 官方称智能水平相同,输出更快 |
| 上下文窗口 | 1,048,576 tokens | 1,048,576 tokens |
| 思考模式 | 始终开启 | 始终开启 |
| 推理强度 | low、high、max;默认 max |
相同 |
| 相对输出速度 | 比较基准 | 官方称约为标准版的 2–3 倍 |
| 稳定输出 tokens/秒 | 本文没有实测结果 | 本文没有实测结果 |
| API 参数约束 | 两个版本共用约束 | 与标准版相同 |
来源:模型列表、模型参数参考、Kimi Code 模型配置。编程订阅和按量 API 使用不同的 ID 与计费体系;界面上显示的“K3.1 Pro”也不能直接当作 API 标识符。
Highspeed 主要改变的是速度与价格选择,不能据此推导出另一个质量档位。如果任务的大部分时间用于编译、检索文档或渲染场景,模型输出加快,并不会同步缩短这些外部操作。选型时应测量拿到可用结果的总时间,而不只是文字生成速度。
2. 参数与架构:哪些已经公开,哪些尚不能确定?
官方发布博客将 K3.1 Pro 描述为基于 K3、增加强化学习投入的后训练版本,并表示将在 11 月 4 日前发布完整模型权重。宣布开放权重的计划,与核查当天已经存在可下载 checkpoint,是两回事。
“三万亿级”是规模描述,不是精确到 3,000,000,000,000 个参数的声明。为了理解其技术背景,可以参考上一代 K3 checkpoint 的官方模型卡:
| 架构字段 | 已公开的 K3 基线;不作为独立核实的 K3.1 checkpoint 规格 |
|---|---|
| 架构 | 混合专家模型,Mixture of Experts,MoE |
| 总参数 | 2.8T,即 2.8 万亿 |
| 激活参数 | 104B,即 1,040 亿 |
| Transformer 层数 | 93 |
| 稠密层数 | 1 |
| 注意力组成 | 69 层 KDA + 24 层 Gated MLA |
| 注意力隐藏维度 | 7,168 |
| 注意力头数 | 96 |
| 潜在 MoE 维度 | 3,584 |
| 单专家隐藏维度 | 3,072 |
| 专家数量 | 896 |
| 每 token 选中专家数 | 16 |
| 共享专家数 | 2 |
| 词表规模 | 160K |
理解 MoE 时,必须区分总参数与激活参数:模型可以保留很大的总容量,而每个 token 只使用其中一部分。这不意味着激活参数为 104B 的模型,存储需求就等同于总参数为 104B 的模型。权重显存、运行时激活、缓存、并行通信及服务开销需要分别计算。
对于 K3.1 本身,本文不把精确激活参数量、新专家数量、层结构修订、训练 token 总量、知识截止时间、量化格式、最终权重许可证或最低 GPU 配置写成既定事实。这些需要相应的正式发布产物支持。上一代架构可以解释模型家族,不能直接改名充当新模型卡。
3. 核心能力,以及它们对实际任务的意义
编程与长程智能体
Kimi 将该模型定位于真实代码库修复和更大规模的工程任务,也包括网页与游戏开发。官方快速入门提到了 Unity、Unreal Engine、Godot 和 Three.js。这类能力依赖工具环境:项目文件、引擎、依赖和执行权限需要由运行环境提供。
我们的评估建议是,给模型一个确实存在缺陷的项目、边界明确的修改目标,以及事先独立定义的验收条件。观察它是否找到正确模块、保留无关行为、处理失败命令,并最终交付可审阅的结果。单独看一段生成代码是否漂亮,无法回答这些问题。
3D 创作与空间推理
同一份快速入门强调了通过 Blender、CAD 等工具脚本完成建模,以及理解草图和参考图。这与“一个通用 API 直接返回图片或视频文件”不同。最终产物可能是脚本、参数化几何体、可编辑场景,或者由外部专业软件生成的资产。
评估机械零件时,应该给出单位、尺寸、公差和导出格式;评估视觉资产时,应说明相机、材质、面数预算和目标渲染器。看起来逼真的预览,与可用于制造的对象,具有不同验收标准。这些是建议的评估任务,并非 Modelflare 已经测出的模型成绩。
金融研究与电子表格
Kimi 同时强调金融研究和建模能力。实用的评估应检查数据来源与工作簿行为:数据是否对应正确报告期,公式是否保持关联,修改假设后相关表格是否同步更新。应要求保留来源链,并区分估算值和正式披露数据。
能组装出工作簿,不等于投资结论已被验证。本文关注的是文档分析、数值推理,以及借助工具交付可核验成果的能力。
视觉上下文与结构化工作流
K3.1 的快速入门给出了图片与视频输入、工具调用、结构化输出等用法。图片接入有一个值得特别检查的限制:该型号要求使用 base64 数据或已上传的 ms:// 文件引用,不应因为旧版通用视觉示例出现公网图片链接,就假设任意远程 URL 都可用。
应用设计上,应让模型负责理解证据和提出工具动作,由应用校验参数、执行已允许的操作并返回结果。一个 JSON 即使语法完全正确,其中的事实也仍可能有误;Schema 校验与证据核查解决的是不同问题。
4. 官方评测成绩应当怎么读?
下面数字是月之暗面公布的评测结果,不是 Modelflare 独立复现。官方发布博客提供了这些对比:
| 评测 | K3.1 Pro | 对照 | 适用范围 |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Opus 5.5:66.4%;GPT-6 Astra:58.2% | 发布者评估环境下的终端任务 |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | K3:55.95% | 内部工程评测 |
| BenchCAD,使用工具 | 92.7 | Opus 5.5:96.2;GPT-6 Astra:95.9 | 1,000 文件子集;Voxel IoU,不是任务成功率 |
这些比较支持一个有限但有价值的判断:K3.1 值得纳入复杂智能体与空间任务的候选名单。它们不能证明该模型在所有编程任务上都更好,也不能证明无需适配即可替代另一模型,或者在你的 token 预算内也能得到相同结果。工具权限、推理强度、重试次数和评估器设计都会影响成绩。
发布当天还有一处来源差异:英文发布博客中的高难度事实性评测给出单项陈述错误率 23.4% → 8.3%,中文 API 快速入门则写作 23.35% → 6.85%。本文不把它们合并成一个降幅,也不挑更好看的数字作为标题。两者描述的都是刻意选择的高难度样本,不是普通日常请求的总体错误率。
5. 官方价格:国际美元与国内人民币分别看
下表统一以 1,000,000 tokens 为计费单位。1,048,576 tokens 的上下文窗口,与一百万 tokens 的报价单位并不相同。美元表和人民币表分别引用对应区域的官方标价,人民币数字不是 Modelflare 自行换算的结果。
国际 API 美元标价
| 模型 | 未缓存输入 | 输出 | 缓存读取 | 缓存写入,5 分钟 | 缓存写入,1 小时 |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2 | $10 | $0.20 | $2 | $4 |
| Kimi K3.1 Pro Highspeed | $4 | $20 | $0.20 | $4 | $8 |
| Kimi K3 | $3 | $15 | $0.30 | $3 | $6 |
来源:国际 API 价格页,包括当前页面内嵌的价格表数据。这是供应商公布的税前价格。K3.1 标准版的输入和输出单价比 K3 低三分之一;Highspeed 对应两项是标准版的两倍,但缓存读取仍为 $0.20。
国内 API 人民币标价
| 模型 | 未缓存输入 | 输出 | 缓存读取 | 缓存写入,5 分钟 | 缓存写入,1 小时 |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | ¥13 | ¥68 | ¥1.30 | ¥13 | ¥26 |
| Kimi K3.1 Pro Highspeed | ¥26 | ¥136 | ¥1.30 | ¥26 | ¥52 |
| Kimi K3 | ¥20 | ¥100 | ¥2 | ¥20 | ¥40 |
来源:国内 API 价格页。相对国内 K3 标价,标准版输入降低 35%,输出降低 32%。这些降幅与国际表不同,是因为两套官方价格本来就不同。
缓存写入不能重复计算
Kimi 的缓存文档将输入拆成互斥的未缓存、缓存读取、缓存写入三部分。Chat Completions 的 prompt_tokens 是总输入量,明细字段再标明命中与写入数量。已经计入缓存写入的 token,不应再收一次普通未缓存输入费用。
对于把 5 分钟和 1 小时写入分开统计的示例请求,费用可以这样计算:
cost = (uncached_tokens * input_price
      + cache_read_tokens * read_price
      + cache_write_5m_tokens * write_5m_price
      + cache_write_1h_tokens * write_1h_price
      + billed_output_tokens * output_price) / 1_000_000
公式中的每类输入必须互不重叠。默认缓存有效期为 5 分钟,文档还提供 1 小时选项。把稳定的指令和工具定义放在请求前部,把每轮变化的任务内容放在后部,才更有利于重复前缀命中。提示词变长本身并不会自动节省费用。
6. 与其他模型的价格对比
下面比较的是各家官方美元标价,不是 Modelflare 分组折扣、编程订阅价格,也不是实测能力排名。使用普通在线推理口径,不包含税费、付费工具、地区附加费用或批处理折扣。
| 模型 | 输入/百万 tokens | 输出/百万 tokens | 缓存读取/百万 tokens | 价格条件 |
|---|---|---|---|---|
| Kimi K3.1 Pro | $2 | $10 | $0.20 | 标准版 |
| Kimi K3.1 Pro Highspeed | $4 | $20 | $0.20 | 高速输出版本 |
| Kimi K3 | $3 | $15 | $0.30 | 上一代旗舰 |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | 标准全球路由 |
| Claude Opus 5.5 | $4 | $20 | $0.20 | 标准全球路由 |
| GLM-5.3 | $1.40 | $4.40 | $0.26 | Z.AI 国际 API |
| DeepSeek-V4.1-Flash-1017 | $0.30 | $1.20 | $0.006 | 高峰时段 |
| DeepSeek-V4.1-Flash-1017 | $0.15 | $0.60 | $0.003 | 非高峰时段 |
来源:Kimi、Anthropic、Z.AI、DeepSeek。DeepSeek 当前官方模型 ID 是 deepseek-flash,表中写出其对应版本。其高峰时段为工作日 UTC 01:00–04:00、06:00–10:00,中国法定节假日除外;其他时间按非高峰价格计算。
K3.1 Pro 与 Sonnet 5.5 的普通输入、输出价格相同,但 Sonnet 的缓存读取标价是一半。Highspeed 与 Opus 5.5 在表中三项价格上相同,缓存写入价格则不同。GLM-5.3 和 DeepSeek Flash 的普通输入、输出价格更低。这些结论可以帮助确定预算候选,不能当成通用能力排名。
Anthropic 的 5 分钟缓存写入价格为 Sonnet $2.50、Opus $5;Kimi 的 Pro、Highspeed 分别为 $2、$4。两组相应的 1 小时写入价格分别为 $4、$8。Z.AI 将缓存存储列为限时免费。因此比较重复工作流时,除了 token 标价,也要对齐缓存策略。
7. 一组可复算的 token 预算
假设一次请求使用 100,000 输入 tokens、10,000 计费输出 tokens。输出量包含应计费的推理 token,并不承诺能看到 10,000 tokens 的最终答案。冷请求没有缓存命中,按普通输入价格计算,或使用与普通输入同价的 Kimi 5 分钟写入;热请求含 90,000 缓存读取 tokens 和 10,000 普通输入 tokens,没有新缓存写入。两种情况都不含外部工具和重试费用。
| 模型/档位 | 冷请求 | 热请求 |
|---|---|---|
| Kimi K3.1 Pro | $0.300 | $0.138 |
| Kimi K3.1 Pro Highspeed | $0.600 | $0.258 |
| Kimi K3 | $0.450 | $0.207 |
| Claude Sonnet 5.5 | $0.300 | $0.129 |
| Claude Opus 5.5 | $0.600 | $0.258 |
| GLM-5.3 | $0.184 | $0.0814 |
| DeepSeek Flash,高峰 | $0.042 | $0.01554 |
| DeepSeek Flash,非高峰 | $0.021 | $0.00777 |
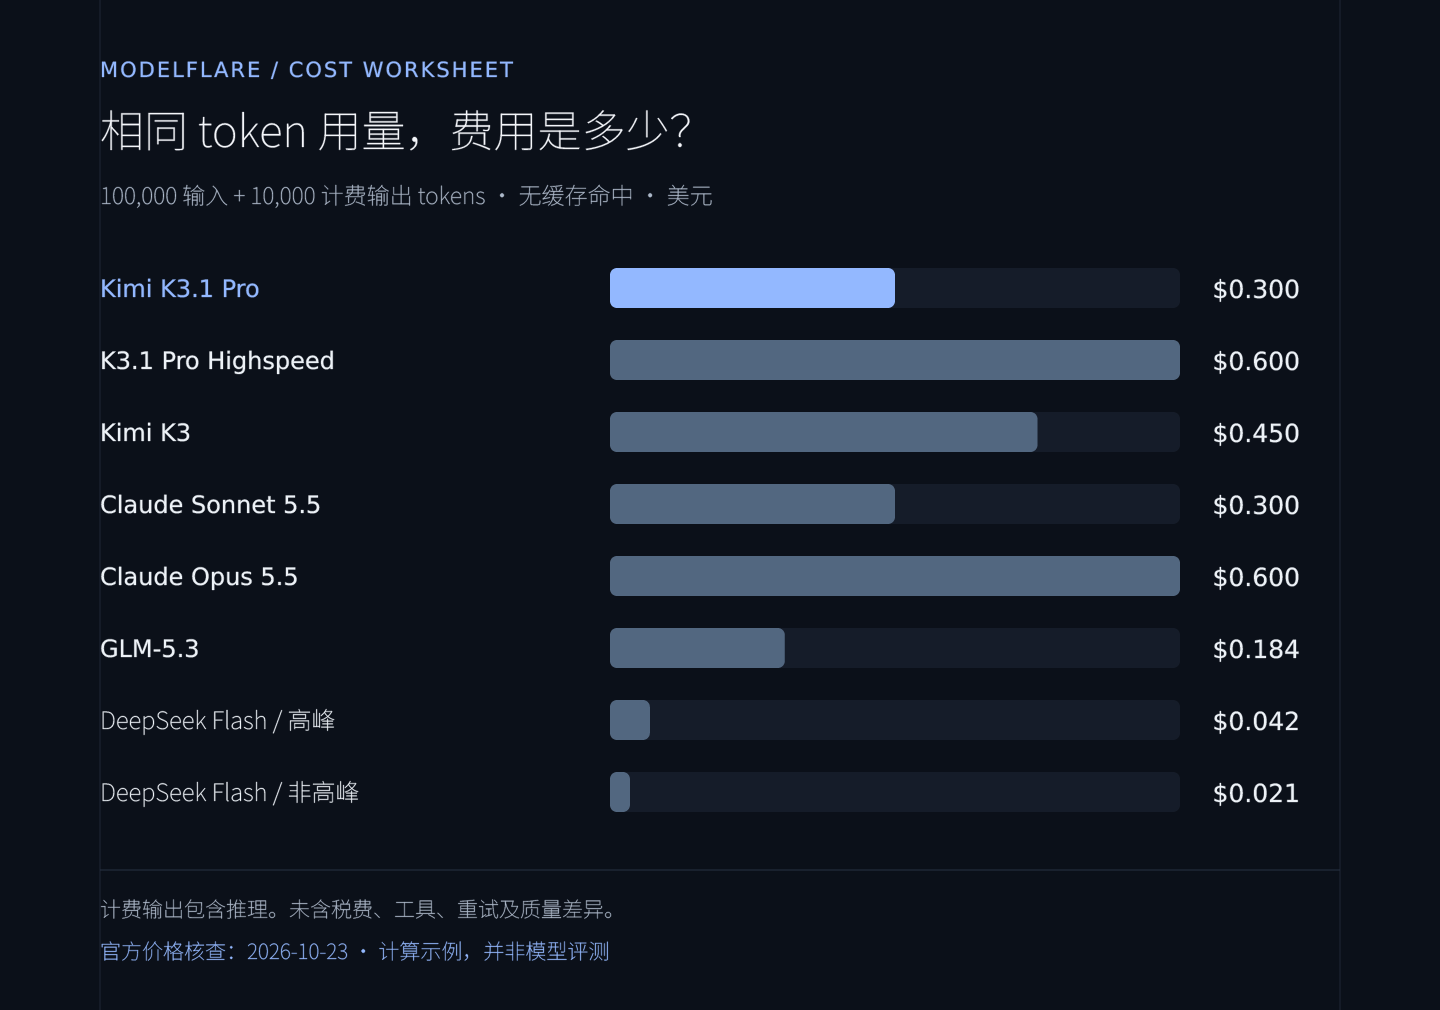
Modelflare 计算示意,不是模型评测。图表使用上表冷请求一列,不包含延迟或完成质量。
以标准 Pro 为例,冷请求为 0.1 × 2 + 0.01 × 10 = $0.30;热请求为 0.09 × 0.20 + 0.01 × 2 + 0.01 × 10 = $0.138。使用国内标价,相同两组用量分别为 ¥1.98 和 ¥0.927。若每次请求都满足同一假设,重复 1,000 次,对应 $300 / $138,或 ¥1,980 / ¥927。
热请求没有计入之前创建缓存的那次请求。计算完整会话时,还要加上首次写入、过期后重新写入,以及后续每轮调用。除了 token 费用,也应记录每个验收通过任务的成本:便宜的一次请求,如果需要多轮重试和人工返工,未必对应便宜的完整工作流。
8. API 参数与接入细节
上下文与生成上限
| 参数或行为 | K3.1 Pro / Highspeed |
|---|---|
| 上下文窗口 | 1,048,576 tokens |
max_completion_tokens 默认值 |
131,072 |
max_completion_tokens 可配置最大值 |
1,048,576,仍受剩余上下文空间约束 |
| 输入加期望输出超过上下文时 | API 根据剩余空间调低本次生成额度 |
| 输入本身 | 必须小于模型上下文窗口 |
| 输出达到上限的信号 | finish_reason: "length" |
temperature |
固定为 1.0 |
top_p |
固定为 0.95 |
n |
固定为 1 |
presence_penalty、frequency_penalty |
固定为 0 |
reasoning_effort |
low、high、max;默认 max |
tool_choice |
auto、none、required |
thinking |
不要把 K2 专属开关沿用到 K3.1 请求中 |
来源:Chat Completions 参考、模型参数参考、推理强度指南。固定参数通常应省略;传其他数值可能报错。通用客户端默认发送了不兼容的 temperature,属于接入适配问题,不能当成模型质量问题。
如果输入已经占用 900,000 tokens,在标称窗口里只剩 148,576 tokens,且还要考虑后续上下文消耗。把输出参数设为一百万,不会让输入和输出容量变成可直接相加的两块独立空间。应用应明确处理输出截断,不要把不完整 JSON 或只写了一半的补丁当成成功结果。
一份基于文档的请求体
对于官方国内 Chat Completions 入口 POST https://api.moonshot.cn/v1/chat/completions,可以使用下面这份有输出预算的流式 JSON。鉴权应放在客户端的密钥配置中。本文仅在本地检查了示例语法,没有将其发送给模型。
{
  "model": "kimi-k3.1-pro",
  "messages": [
    {
      "role": "user",
      "content": "说明如何检查电子表格中的不一致公式。"
    }
  ],
  "reasoning_effort": "high",
  "max_completion_tokens": 16384,
  "stream": true,
  "stream_options": { "include_usage": true }
}
这里明确指定推理强度,便于应用自己控制,而不依赖模型默认值。该 JSON 只用于 Chat Completions,不能原样当作 Responses 或 Messages 请求体。Kimi 另外提供 Responses 和 Messages 文档,它们有各自的输入与事件协议。
推理、工具与结构化答案
多轮请求应保留完整 assistant message,包括 reasoning_content 和 tool_calls;每个工具结果按对应 tool_call_id 返回。思考模型指南解释了保留式推理要求。只保留可见 content,可能丢失下一步需要的状态。
流式界面应区分推理增量和最终答案增量。应用数据应解析最终答案字段,计费用量读取最终 usage 记录。收到思考文本,本身并不意味着某个工具已经运行,也不代表任务完成。
对于信息提取,Kimi 文档提供 response_format 搭配 json_schema 和 strict: true 的用法。解析后仍需校验必填项与业务规则。对于工具调用,应在应用侧限制权限并处理失败。遇到输出达到长度上限时,可能需要修改预算或拆小任务;不调整条件就盲目重试,可能只会重复失败。
9. Kimi Code 会员与按量 API 是两种产品
Kimi Code 模型配置页说明:标准 Pro 从 Plus 档可用,Pro 档起支持 1M 上下文;Highspeed 需要 Pro。旧套餐名称在该页面单独列出。这个产品使用 k3.1-pro、k3.1-pro-highspeed,而不是按量 API 中更长的型号 ID。
从旧模型切换时,建议新建会话,并尽量固定模型和推理强度。供应商提示,切换可能影响上下文缓存和行为稳定性。会员额度并不等于固定金额的 API 余额,月度订阅费也不应与每百万 tokens 单价放在同一列直接比较。
10. 按任务选择评估方向
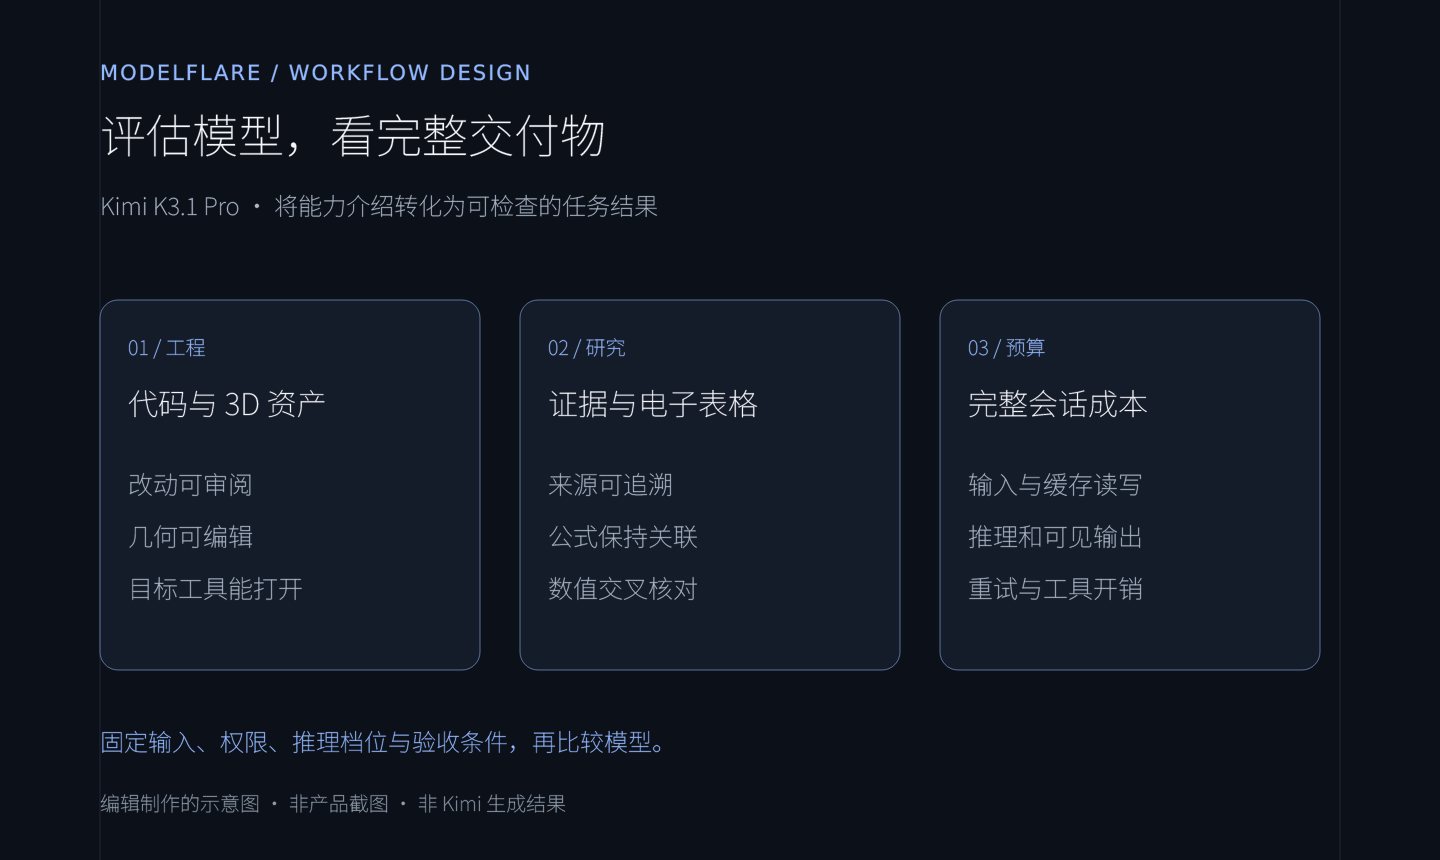
编辑制作的工作流示意图,用于说明验收维度,不是产品截图或 Kimi 生成结果。
| 你的主要目标 | 候选评估方式 | 应观察什么 |
|---|---|---|
| 大型代码库或多阶段开发 | 先评估标准 Pro | 改动是否通过验收、失败恢复、总 token 用量 |
| 输出等待占主要时间的交互任务 | 对比 Pro 与 Highspeed | 总耗时、每个合格结果增加的费用 |
| 重复使用长提示词 | 对比 Kimi 与 Claude 缓存策略 | 冷启动、读写用量、命中率、TTL 过期 |
| 大批量经济型推理 | 纳入 GLM-5.3 与 DeepSeek Flash | 自有数据上的质量、失败率、高低峰费用 |
| CAD、场景或游戏资产 | 在真实目标工具中评估 K3.1 | 几何正确性、可编辑性、导出兼容、渲染结果 |
| 研究与电子表格 | 使用带来源的任务及独立检查 | 证据准确性、公式关联、数值核对 |
这些建议来自上文的协议能力和价格分析,并非亲自试用后的产品背书。比较前应固定输入集、工具权限、推理档位、停止条件和验收标准;否则账单更低,可能只是因为完成了不同任务,而不是效率更高。
11. Modelflare 当前可用状态与后续接入
在 10 月 23 日 18:03 UTC,只读查询 Modelflare 公开价格接口,可见 kimi-k3 属于 kimi-award、kimi-stable 分组,尚未列出 kimi-k3.1-pro 或 kimi-k3.1-pro-highspeed。本文不宣称 K3.1 已有路由、本站分组价格、成功调用记录或可部署能力。把客户端里的 K3 ID 改成新名字,不能证明新模型已经可用。
当前接入状态请查看模型与价格。接入背景可继续阅读 OpenAI 兼容 API 指南、Responses 与 Chat Completions 的区别、API 成本追踪。
12. 来源、方法与更新记录
主要来源已放在对应结论和表格附近,包括月之暗面发布页与 API 文档、其 K3 模型卡、其他供应商价目页,以及 Modelflare 公开目录。Kimi 价格同时核查了两个区域的官方页面;动态表格使用实际页面里的数据,不依靠搜索摘要推算。
本文新增内容包括互斥 token 分类费用公式、两组预算场景和任务验收矩阵。图片沿用 Modelflare 工程专题样式,没有虚构产品界面或评测成绩。全文没有发起真实模型调用。K3.1 精确 checkpoint 内部规格、独立速度测量,以及存在差异的事实性数字,均保留明确的不确定状态。
**2026 年 10 月 23 日:**首版,介绍官方 K3.1 Pro 与 Highspeed 发布、当前区域价格、注明来源的参数、费用比较及记录时间点的 Modelflare 可用状态。